A d-Matrix Demo Cloudban percek alatt kipróbálható a Corsair
A d-Matrix új Demo Cloud szolgáltatása lehetővé teszi, hogy ügyfelek, partnerek és értékelők percek alatt kipróbálják a Corsair hardverre épülő AI-inferenciát. Ehhez nem kell saját infrastruktúrát kiépíteni, elegendő egy API-kulcs létrehozása.
- A Demo Cloud valódi Corsair hardveren futó AI-inferenciát tesz kipróbálhatóvá.
- A teszteléshez előre létrehozott munkaterület és API-kulcs-kezelés tartozik.
- A szolgáltatás OpenAI-kompatibilis kliensekkel és a Codex CLI-vel is használható.
- Heterogén Speculative Decoding futtatható Corsair és GPU szerverek kombinációjával.
- A d-Matrix Demo Cloud jelenleg várólistán keresztül érhető el.
Valódi hardveren tesztelhető a Corsair teljesítménye
A d-Matrix szeptember 15-i bejelentése szerint a Demo Cloud olyan hosztolt környezet, amelyben a felhasználók saját munkaterheléseiken vizsgálhatják meg a Corsair gyorsítóira épülő inferenciát. A szolgáltatás célja, hogy az érdeklődők még az értékesítési csapattal folytatott egyeztetés előtt közvetlen tapasztalatot szerezhessenek a rendszer működéséről.
A tesztelés valódi Corsair hardveren, produkciós használatra szánt modellekkel történik. A felhasználók inference végpontot indíthatnak, majd az általuk már használt OpenAI-kompatibilis eszközöket csatlakoztathatják hozzá. A d-Matrix szerint ehhez nem kell infrastruktúrát létrehozni, és a beállításra sem kell várni.
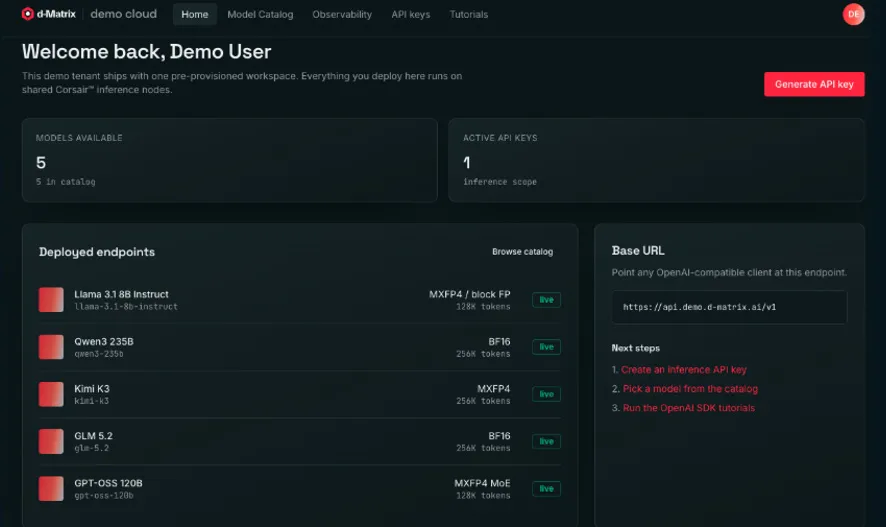
A Demo Cloud irányítópultján megjelenik, milyen végpontok vannak telepítve, mely API-kulcsok aktívak, és melyik alap URL-címet kell használni az OpenAI-kompatibilis kliensek kapcsolódásához. Minden bemutatóhoz előre létrehozott munkaterület tartozik, így a bejelentkezés után látható, mi érhető el és hogyan lehet elindítani a tesztet.
OpenAI-kompatibilis eszközökkel, átírás nélkül
A szolgáltatás önkiszolgáló API-kulcs-kezelést kínál. A felhasználó korlátozott hatókörű inference API-kulcsot hozhat létre, majd szabványos Bearer tokennel hitelesítheti magát az elérhető végpontokon. A d-Matrix ezt ahhoz a mintához hasonlítja, amelyet az OpenAI SDK használ.
A hosztolt modellek az OpenAI wire protokollján keresztül érhetők el, ezért a meglévő kliens lecserélése a vállalat szerint konfigurációs módosítás, nem teljes átírás. A támogatott lehetőségek között szerepelnek a chat completions kérések, a Responses API, valamint az olyan ügynökalapú kódolási eszközök, mint a Codex CLI.
A d-Matrix példaként azt mutatja be, hogy a Codex CLI vagy más OpenAI-kompatibilis kliens egy szolgáltatói beállítás hozzáadásával a Demo Cloud alap URL-címére irányítható. Így a felhasználó egy hosztolt modellen, például a Qwen3 235B-n futtathat valódi kódolási feladatokat.
A heterogén inferencia működését is meg lehet nézni
A Demo Cloud kétféle használatot tesz lehetővé. Az egyik a teljes modell futtatása Corsair szervereken, a másik a heterogén, szétválasztott inferencia GPU és Corsair szerverek kombinációjával. A rendszerhez előzetesen ellenőrzött telepítési konfigurációk tartoznak, ezért a felhasználónak nem kell maga elvégeznie a kapcsolódó hangolási munkát.
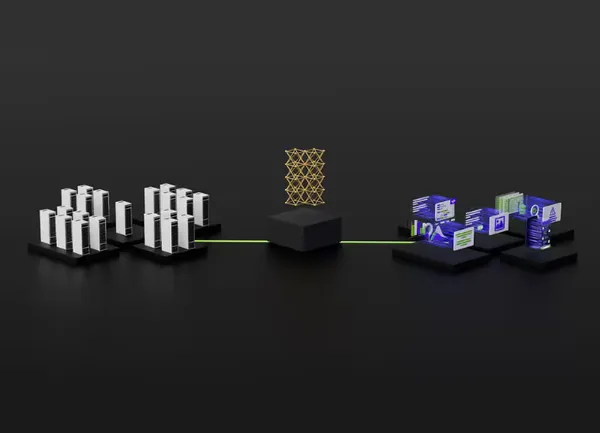
A d-Matrix külön kiemeli a heterogén Speculative Decoding inferenciát. Ennél a módszernél egy kisebb, úgynevezett javasló modell Corsair hardveren tokeneket javasol, egy nagyobb célmodell pedig GPU-n ellenőrzi ezeket. A Demo Cloud a Corsair és GPU-csomópontok közötti teljes vezérlést és összehangolást biztosítja.
A vállalat példájában a Qwen3 1.7B javasló modell két Corsair kártyán, a Qwen3 235B célmodell pedig négy H200 GPU-n fut. A katalógus végpontjai a Speculative Decoding módhoz, a számítási és memóriaerőforrásokhoz, valamint a chat completions és Responses API kompatibilitásához is előre beállított konfigurációkat kínálnak.
A d-Matrix a Demo Cloud képességeit az AI Infra Summit 2026 rendezvényen is bemutatja. A szolgáltatás iránt érdeklődők jelenleg várólistára iratkozhatnak fel, így a Corsairre épülő inferencia teszteléséhez nem kell azonnal saját infrastruktúrát kiépíteniük.