A Databricks minden kódoló ügynöknek külön adatbázist adna
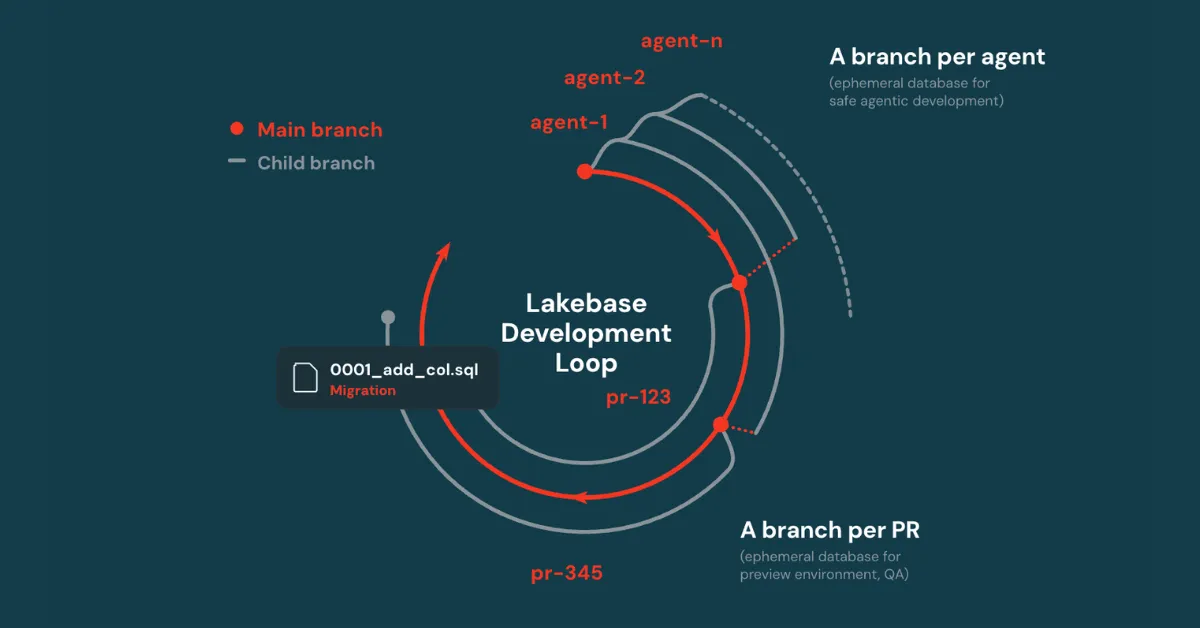
A Databricks olyan fejlesztési folyamatot mutatott be, amelyben minden kódoló ügynök és pull request saját, elszigetelt Lakebase-adatbázis-ágat kap. A megoldás célja, hogy a párhuzamosan dolgozó ügynökök ne zavarják egymás sémamódosításait és tesztjeit.
- A Lakebase egy másodpercnél rövidebb idő alatt adatbáziságat hozhat létre.
- A kódoló ügynökök külön, elszigetelt adatbázis-környezetben dolgozhatnak.
- A pull requestekhez a GitHub Actions ideiglenes ágat és előnézeti alkalmazást hozhat létre.
- A sémafrissítések migrációként kerülnek vissza a szülőágba.
- A külön ágak hibakeresésre és produkció előtti migrációtesztelésre is használhatók.
Az adatbázis lett a párhuzamos fejlesztés szűk keresztmetszete
A Databricks szerint a kódoló ügynökök egyre nagyobb részt vállalnak a szoftverfejlesztésből, ezért a fejlesztők feladata fokozatosan az ügynökök összehangolása felé tolódik. A több ügynök párhuzamos futtatása közben azonban egy kritikus elem gyakran háttérbe szorul: az adatbázis.
Minden ügynöknek kódot kell írnia, sémamódosításokat kell alkalmaznia, majd teszteket kell futtatnia. Ha ugyanazt a fejlesztési vagy tesztadatbázist használják, az ügynökök módosításai ütközhetnek, zavarhatják egymás munkáját, vagy a fejlesztők olyan szimulált adatokhoz fordulhatnak, amelyek nem tükrözik a valós környezetet. A Databricks szerint ezt a problémát tovább súlyosbítja, hogy az ügynökök gyorsan és párhuzamosan dolgoznak.
A Lakebase másodpercnél rövidebb idő alatt ágaztat adatbázist
A Databricks bemutatott megoldása a Lakebase Postgres adatbázis-ágaztatása. A vállalat leírása szerint a rendszer az adatbázis teljes méretétől függetlenül, egy másodpercnél rövidebb idő alatt képes új ágat létrehozni.
A technológia másolás íráskor elvű működést használ. Az ágak megosztják a szülőág adatait, és csak az eltérésekhez szükséges további tárhelyet használják. Az inaktív ágak számítási erőforrás-használata nullára csökkenthető, így a Databricks szerint több ügynök párhuzamos futtatása mellett sem kell minden ág számára folyamatos számítási kapacitást fenntartani.
Az egyes ágak teljesen elkülönülnek egymástól. Az ügynökök saját águkon alkalmazhatnak migrációkat, futtathatnak teszteket, majd a munka befejezésekor megszüntethetik azt.
Git worktrees, Claude Code és külön ág minden pull requesthez
A bemutatott fejlesztési folyamat a kód és az adatbázis elkülönítését együtt kezeli. A Git worktree minden ügynöknek saját könyvtárat és saját kódágat ad. A repozitóriumhoz hozzáadott post-checkout hook automatikusan létrehozza az adott munkaterülethez tartozó Lakebase-ágat. A Databricks példájában Claude Code, Git worktrees és Lakebase branching dolgozik együtt.
Amikor az ügynök elkészül, pull requestet nyit. A kód és az adatbáziság később megszüntethető. A Lakebase-ágakat a Git ágaitól eltérően nem olvasztják vissza közvetlenül a főágba. A sémamódosításokat a kód mellett követik, majd Drizzle, Flyway, Liquibase vagy Alembic használatával migrációként juttatják el a szülőághoz. A Databricks saját példájában a Drizzle szerepel.
A pull request megnyitásakor a GitHub Actions a produkciós ágból ideiglenes Lakebase-ágat hoz létre. Erre fut rá a migráció, erre telepíthető előnézeti alkalmazás, és itt futtathatók az automatizált tesztek. A folyamat séma-összehasonlítást is készíthet, amely megmutatja a módosult táblákat, oszlopokat és indexeket, majd ezt megjegyzésként hozzáadja a pull requesthez. A Databricks példája Databricks Apps alkalmazást használ, de a leírás szerint a módszer más tárhelyszolgáltatókkal is alkalmazható. A pull request lezárásakor vagy összeolvasztásakor a CI-rendszer törli az ideiglenes ágat.
Hibakeresés és sémafrissítés éles adatok veszélyeztetése nélkül
A Databricks szerint az adatbázis-ágaztatás nem csak a kódoló ügynökök munkáját segítheti. Egy korábbi időpontra visszavezetett produkciós ágból például biztonságosan reprodukálható egy hiba a valódi adatokon, majd a vizsgálat végén megszüntethető a külön környezet.
A sémafrissítések előtt szintén létrehozható egy elkülönített ág. Erre alkalmazható a migráció, lefuttathatók a tesztek, és ellenőrizhető, hogy az alkalmazás a várt módon működik-e. A vállalat szerint ez lehetővé teszi produkcióhoz hasonló vagy abból származtatott adatok használatát is, például Unity Catalog maszkolással, miközben az éles adatbázis változatlan marad.
A Databricks által felvázolt fejlesztési ciklus így ügynökönként, pull requestenként, valamint produkciós ellenőrzésenként külön, ideiglenes adatbázis-környezetet biztosít. Ez a kódoló ügynökökkel dolgozó csapatok számára elszigeteltebb módot kínál a fejlesztésre, a tesztelésre és a sémafrissítések ellenőrzésére.
Databricks: Lakebase and Agentic SDLC: Branching Databases for Coding Agents