Automatikus modellválasztást kínál a DigitalOcean Inference Router
A DigitalOcean továbbfejlesztette Inference Router szolgáltatását, amely a beérkező kérésekhez automatikusan választ modellt a feladat és a felhasználói preferenciák alapján. A megoldás Public Preview állapotban érhető el, használatáért jelenleg nincs külön díj.
- Az Inference Router automatikusan választ modellt az egyes feladatokhoz.
- A DigitalOcean belső tesztjeiben a router 22 százalékkal alacsonyabb költséget ért el.
- A kezdeti kategóriák a szoftverfejlesztés, az ügynökalapú munkafolyamatok és a következtetés.
- Public Preview alatt nincs külön routerdíj, csak a kiszolgáló modellek használata után számláznak.
- A jövőben saját értékelési készlet alapján is irányítható lesz a modellválasztás.
A router választ modellt a feladathoz
A DigitalOcean új Inference Routere azt a célt szolgálja, hogy a fejlesztőknek ne kelljen minden új modell megjelenésekor ismét lefuttatniuk a saját értékeléseiket, összehasonlító teszteket végezniük és átírniuk az útválasztási szabályokat. A használathoz a kérést az inference-router modellnévre kell küldeni, majd szükség esetén megadható egy preferencia.
A szolgáltatás a DigitalOcean Model Catalog modelljeire támaszkodik. A kínálatban az Anthropic és az OpenAI csúcsmodelljei, valamint olyan nyílt forráskódú modellek szerepelnek, mint a Kimi, a GLM és a DeepSeek. A DigitalOcean szerint minden új modell ugyanazon a teszten megy keresztül, és azok kerülnek be a routerbe, amelyek megfelelő eredményt érnek el.
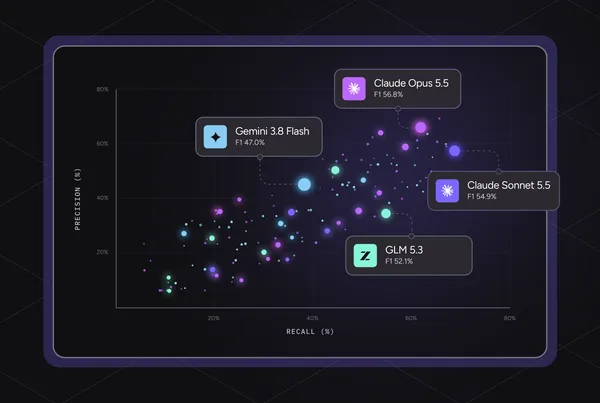
A vállalat belső tesztjei szerint az Inference Router a szoftverfejlesztési, következtetési és ügynökalapú feladatokban magasabb pontosságot ért el, mint a Claude Opus 5.5 és a GPT-6 Astra, miközben a költsége körülbelül 22 százalékkal alacsonyabb volt. Ezek a DigitalOcean belső értékeléseinek eredményei, amelyek a közlemény szerint eltérhetnek a nyilvános ranglistáktól.
Benchmarkok, költség és gyorsaság alapján dönt
A router működésének alapja a modellek széles feladatsoron végzett mérése. A DigitalOcean a teljesítmény mellett a költséget és a késleltetést is figyelembe veszi, majd ez alapján határozza meg, hogy egy adott feladathoz melyik modell illik leginkább.
Amikor beérkezik egy kérés, az útválasztó modell értelmezi azt, hozzárendeli a megfelelő feladattípushoz, majd a felhasználó megadott preferenciáját is figyelembe véve kiválasztja a modellt. A rendszer gyorsítótár-tudatosan működik, vagyis igyekszik megtartani az aktuális modellt és újrahasznosítani annak gyorsítótárát, kivéve, ha a váltás előnyei ellensúlyozzák ennek költségét.
A kezdeti feladatkategóriák között a szoftverfejlesztés, az ügynökalapú munkafolyamatok, valamint az általános intelligencia és következtetés szerepel. A DigitalOcean Inference Router Getting Started oldala megmutatja az egyes használati esetekhez tartozó benchmarkokat, a router eredményeit a legjobb egyedi modellel összevetve, valamint azokat a modelleket, amelyek között választ.
Public Preview, saját értékelésekkel a jövőben
A DigitalOcean a balanced útválasztási preferenciát állítja be alapértelmezettként, és úgy számol, hogy ez a legtöbb ügyfélnek megfelelő lesz. A felhasználók ugyanakkor a budget beállítással az alacsonyabb költségű modellek, a quality beállítással pedig a minőség előnyben részesítése felé terelhetik a rendszert.
A vállalat később saját értékelési készletek használatát is lehetővé tenné. A fejlesztők így a saját rubrikájukat és sikerdefiníciójukat adhatják meg, a router pedig ezek alapján döntheti el, melyik modell teljesít a legjobban. Új modell megjelenésekor az értékeléseket újra lefuttatják, hogy a rendszer továbbra is a feladathoz leginkább illő modellt válassza.
Az Inference Router a DigitalOcean közlése szerint már elérhető Public Preview verzióban. Ebben az időszakban nincs külön díja, a felhasználókat az egyes kéréseket kiszolgáló modellek után számlázzák. A szolgáltatás a DigitalOcean vezérlőpultján található, az API-kéréseket pedig az https://inference.do-ai.run/v1 végpontra kell küldeni az inference-router modell megadásával.
DigitalOcean: DigitalOcean Inference Router Enhancements: Performance Tuned Routing, No Rules to Write