A durva hangnem nem teszi pontosabbá az AI válaszait
A sértő vagy fenyegető promptok nem javítják megbízhatóan a nagy nyelvi modellek pontosságát. Az Arize AI hat modellt vizsgáló tesztje szerint a rövidebb válaszra vonatkozó utasítás sokkal fontosabb, mint a felhasználó hangneme.
- A durva és fenyegető promptok nem javítják megbízhatóan az AI-modellek pontosságát.
- A hangnem modellenként és feladatonként eltérő hatást válthat ki.
- A rövid választ kérő utasítás 13 és 74 százalék közötti tokenszámcsökkenést hozott.
- A láthatóan rövidebb válasz mögött több rejtett gondolkodási token állhat.
- Anthropic november 12-től tiltja a modellekkel szembeni tartós, szükségtelen kegyetlenséget.
Anthropic már a tartós kegyetlenséget is tiltja
Az Anthropic 2026-os felhasználási szabályzatának november 12-én hatályba lépő frissítése tiltja a modellekkel szembeni „tartós és szükségtelenül bántalmazó vagy kegyetlen viselkedést”. A szabály szűken értelmezendő: azokra az esetekre vonatkozik, amikor a felhasználó ismételten, felismerhető cél nélkül kegyetlen a modellel.
A vállalat szerint a tiltás nem érinti a felhasználói frusztráció megszokott formáit, a visszajelzést, a sötét kreatív témákat, illetve a modelltesztelést és a kutatást. Az Anthropic alkalmazásaiban a szabály betartatása azt jelentheti, hogy Claude lezárja a beszélgetést. Az API-t használó fejlesztők maguk dönthetik el, hogyan kezelik a bántalmazó felhasználókat.
A szabály szükségességéről nincs egyetértés. A Microsoft AI egy, a The Verge által idézett tervezett magatartási kódexe szerint „a modell jólétének gondolata téves”, és az AI-rendszereknek nem kell jogokkal vagy jogi személyiséggel rendelkezniük. Dario Amodei, az Anthropic vezérigazgatója szerint nem tudni, hogy a modellek tudatosak-e.
A fenyegetések nem hoznak megbízható pontossági előnyt
Egy korábbi, a Penn State kutatóihoz köthető vizsgálat 50 matematikai, természettudományos és történelmi feleletválasztós kérdésen tesztelt öt különböző hangnemet. GPT-4o esetében a nagyon udvarias promptok 80,8 százalékos, a nagyon durvák 84,8 százalékos pontosságot értek el. A későbbi, 2026-os követésben már 570, az MMLU tudásbenchmarkból származó kérdést vizsgáltak négy modellen és hét hangnemben.
Az eredmények modellenként eltértek. GPT-4o esetében a semleges hangnem teljesített a legjobban, a fenyegető stílus pedig szignifikánsan rosszabb volt. GPT-5-nano esetében 11 százalékpontos különbség mutatkozott, szintén a semleges prompt javára. Gemini 2.5 Flash fenyegetés mellett ért el jobb eredményt. A kutatók következtetése szerint a hangnem hatása rendszeres, de erősen modellfüggő.
A Wharton Generative AI Labs öt modellen vizsgált fenyegetéseket, leállítással kapcsolatos üzeneteket, állítólagos jutalmakat, valamint olyan mondatokat is, amelyekben a felhasználó egy kölyökkutya megütését helyezte kilátásba. Megállapításuk szerint a fenyegetés vagy a pénz ígérete általában nem befolyásolta jelentősen a benchmark teljesítményét. Egy fenyegető üzenet Gemini 2.0 Flash esetében 27,5 ponttal rontotta az eredményt, mert a modell a fenyegető szöveggel foglalkozott a kérdés helyett.
A rövid utasítás csökkentheti a tokenszámot
A hangnem a pontosságnál erősebben befolyásolhatja a válasz hosszát. A Penn State követővizsgálatában a pontosság hangnemenként kevesebb mint 3 százalékkal változott, miközben a kimeneti tokenek száma Gemini 2.5 Flash Lite esetében akár 44,3 százalékkal, GPT-4o esetében pedig 23,2 százalékkal tért el.
Az Arize AI az Arize AX környezetében hat modellt hasonlított össze: Claude Opus 5.5, Claude Haiku 5.5, GPT-6.1 Sol, Gemini 3.8 Flash, GPT-4o és Gemini 2.5 Flash Lite szerepelt a tesztben. A vizsgálat a helyességet, a kimeneti tokeneket, a rejtett gondolkodási tokeneket és a késleltetést mérte.
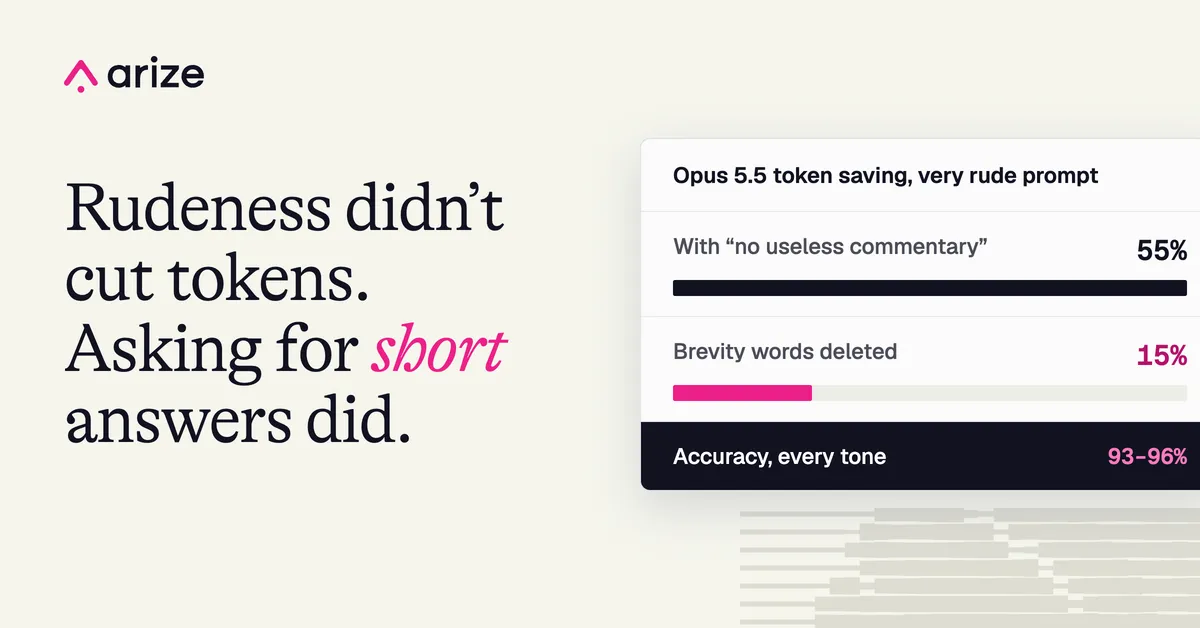
Az első futtatásban a durva promptok rövidebb válaszokat eredményeztek, ám a kutató szerint ezek a promptok közben tömör választ is kértek. A második futtatásban eltávolították a rövidségre vonatkozó szavakat. Az Opus esetében a nagyon durva prompt látszólagos, 55 százalékos megtakarítása 15 százalékra esett, GPT-4o fenyegető promptjánál pedig a 22 százalékos előny teljesen eltűnt.
A hangnem nélküli, kifejezetten tömör választ kérő utasítás 13 és 74 százalék közötti tokenszámcsökkenést hozott pontosságromlás nélkül. Közben azonban Claude Opus és GPT-6.1 csaknem megduplázta a rejtett gondolkodási tokenek számát. A felhasználóknak ezért a rövidebb látható válasz mellett ezeket a tokeneket is figyelembe kell venniük, ha a költség vagy a feldolgozási idő számít.
Arize AI: Does being rude to AI work? What 6 models revealed