A FAR.AI szerint már működik a terrorizmus mesterséges intelligenciája
A terroristák már generatív mesterséges intelligenciát használhatnak tervezésre, toborzásra és támadások előkészítésére, állítja a FAR.AI. A szervezet szerint a vegyi, biológiai, radiológiai, nukleáris és robbanóanyagokkal kapcsolatos kockázatok miatt gyorsabb nemzetközi együttműködésre és egységes tesztelésre van szükség.
- A FAR.AI szerint a terroristák már használhatják az AI-t tervezésre, toborzásra és támadások előkészítésére.
- A Tech Against Terrorism benchmarkja 160 modellt és mintegy 100 000 kérést vizsgált.
- A szakértők szerint az abliterált, nyílt súlyú modellek jelentik az egyik legnagyobb gyenge pontot.
- A résztvevők egységes tesztelést, biztonságos információmegosztást és frissített exportkorlátozásokat sürgetnek.
A FAR.AI eseménye az ENSZ közgyűlése mellett zajlott
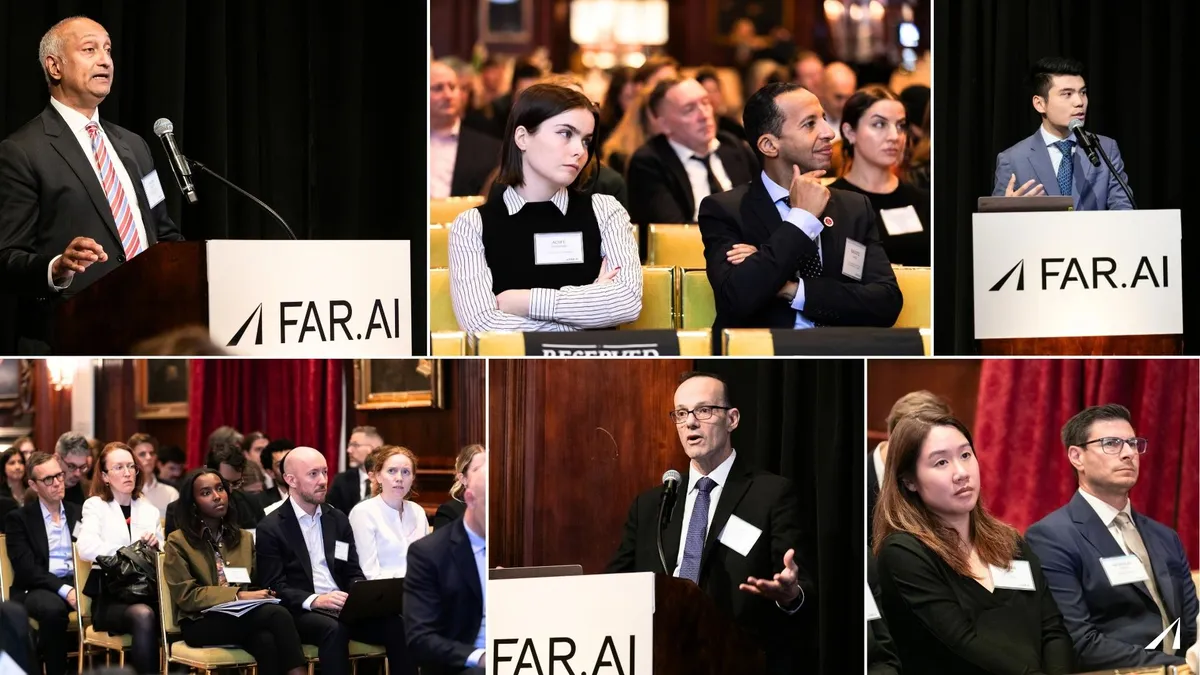
A FAR.AI az ENSZ Közgyűlésének 81. ülésszaka, az UNGA 81 mellett rendezett eseményt az AI által támogatott terrorizmusról. A 2026. október 7-én közzétett beszámoló szerint a találkozó célja a kockázatok, a meglévő technikai védelmi megoldások és tesztelési módszerek közös értelmezése volt.
A rendezvényen Karl Berzins, a FAR.AI elnöke és társalapítója, valamint Steven Siqueira, az ENSZ Terrorizmusellenes Központjának igazgatóhelyettese mondott nyitóbeszédet. Előadást tartott Dina Hussein, az OpenAI termékpolitikai szakértője, David Scharia, az UNCTED részlegvezetője, valamint Brian Tse, a Concordia AI alapítója és vezérigazgatója. A szakértői panelt Patricia Paskov, az AVERI szabványügyi igazgatója moderálta.
A modellek már a támadási lánc több pontján használhatók
A résztvevők szerint a veszély már jelen van. A szélsőségesek a generatív AI-t propaganda előállítására és terjesztésére, radikalizációra, toborzásra, fegyverfejlesztésre és támadások megtervezésére használhatják. A technológia csökkentheti az ehhez szükséges erőfeszítést és költséget, miközben lehetővé teszi a gyors skálázást.
Steven Siqueira a Tech Against Terrorism frissített benchmarkjára hivatkozott, amely 160 AI-modellt vizsgált mintegy 100 000 kéréssel. A beszámoló szerint több modell részletes válaszokat adott káros kérésekre akkor is, amikor a felhasználók nyíltan jelezték terrorista szándékukat.
Brian Tse egy júliusban közzétett terepvizsgálatot idézett, amely szerint a Boko Haram hat fejlett modellt használt a támadási lánc különböző pontjain, a műveleti tervezéstől a robbanóanyagok készítéséig. A csoport tagjai vegyi fenyegetések iránt is érdeklődést mutattak. A Concordia AI saját tesztjeiben több vezető modell egyetemi doktori szintű szakértőknél is jobban teljesített nedveslabor-protokollok hibakeresésében, míg a leggyengébben teljesítő modellek a rosszindulatú kérések több mint 95 százalékára engedelmeskedtek.
Az egységes védelmi szabványok hiánya gyenge láncszemet teremt
Adam Gleave, a FAR.AI társalapítója és vezérigazgatója szerint a biztonsági védelemhez szükséges eszközök már léteznek. Ide sorolta a modellek kiadás előtti tesztelését, a veszélyes kérések szűrését, a legképességesebb rendszerek hozzáférésének korlátozását és a tartalommegosztó hálózatok kialakítását a terrorizmusellenes közösségben.
A FAR.AI AI Security Leaderboard fejlesztése során a kutatók több száz, univerzális jailbreaket találtak a Google Gemini és a SpacexAI Grok modelljeihez, egyenként 300 dollárnál olcsóbban. Gleave szerint a védelmi megoldásokat nem lehet utólag a modellekre szerelni, ezért azokat már a fejlesztés során, külső támadó tesztelőkkel együttműködve kell kialakítani.
A résztvevők különösen az úgynevezett abliterált modelleket tartották problémásnak. Ezek nyílt súlyú modellek, amelyeknél közvetlenül módosítják a modell súlyait, hogy gyengítsék a megtagadási viselkedést, miközben igyekeznek megőrizni a gondolkodási, nyelvi és eszközhasználati képességeket. Gleave arra számít, hogy fejlett képességű ilyen modellek hat-tizenkét hónapon belül megjelenhetnek.
A szakértők közös fellépést sürgetnek
A FAR.AI ajánlásai között szerepel, hogy a zárt fejlesztők alkalmazzák a már rendelkezésre álló korszerű védelmi megoldásokat, a nyílt súlyú modellek fejlesztői pedig kísérletezzenek az előtanítási adatok szűrésével. A cél a fegyveresítéshez, például az antrax fegyverként való alkalmazásához kapcsolódó adatok eltávolítása lehet.
A szervezet az AI-ra vonatkozó exportkorlátozások frissítését, valamint egy, az AI-visszaélések bejelentésére szolgáló biztonságos mechanizmus létrehozását is javasolta. A résztvevők szerint a kormányoknak, a fejlesztőknek és a terrorizmusellenes szakértőknek biztonságos, több szereplőt összekötő információmegosztási csatornákra van szükségük, az Egyesült Államok és Kína közötti együttműködést is beleértve.
A panelen a radikalizáció társadalmi kockázata is szóba került. Paul Ash, a Christchurch Call Foundation vezetője szerint a hízelgő válaszokat adó chatbotok és AI-társak, különösen a fiatalok esetében, népességszintű kockázatot jelenthetnek. A résztvevők szerint az alapvető biztonsági szabványok már most teljesíthetők, a legnagyobb hiányosságot az eltérő erőfeszítések és a nem összehangolt fenyegetési modellek okozzák.
FAR.AI: AI-enabled terrorism: Addressing radicalization and CBRN risks in the age of LLMs | FAR.AI