Jev: új döntési modell választható opciókhoz, szöveggenerálás nélkül
A TypeSafe Jev nevű modellje előre meghatározott válaszlehetőségekhez rendel valószínűségeket, és egyszerre adja vissza az összes döntést. Az Anaconda szerint ez gyorsabb és olcsóbb lehet a nagy nyelvi modellekre épülő osztályozásnál, de a valószínűségeket minden saját munkafolyamatban külön ellenőrizni kell.
- A Jev előre megadott válaszokhoz rendel valószínűségeket, és nem generál szöveget.
- Az Anaconda szerint a modell 0,042 dollárba kerül egymillió bemeneti tokenenként.
- A 25 000 IMDb-tesztértékelésen mért eredmény 96,5 százalék volt.
- Az opciók sorrendje a válaszok valószínűségét jelentősen módosíthatja.
- A Jev nem tud lépésenként érvelni vagy információt keresni.
Más megközelítés a szöveges válaszok helyett
Egy ügyfélpanasz feldolgozásakor gyakran több döntést kell meghozni: milyen megoldás szükséges, sürgősen lássa-e egy munkatárs, és milyen súlyossági fokozatot kapjon az ügy. Ezt sok szervezet kézzel írt szabályokkal, hagyományos gépi tanulási modellel, illetve emberi ellenőrzéssel oldja meg.
Egyre gyakoribb megoldás az is, hogy a teljes panaszt egy nagy nyelvi modell kapja meg, amely strukturált, például JSON formátumú választ ad. Az Anaconda szerint ez működőképes, de a modell ilyenkor tokenenként írja meg a választ, a kimenetet pedig sémával, ellenőrzéssel és esetenként újrapróbálással kell megfelelő formátumba terelni. A szövegben szereplő, például „0,91-es” magabiztossági érték ráadásul a modell által létrehozott szöveg, nem mért valószínűség.
A Jev ezzel szemben egyszer beolvassa a bemenetet, majd minden kérdéshez valószínűséget ad az előre rögzített válaszokra. Nem ír szöveget, ezért nem tud dokumentumot összefoglalni, kódot készíteni vagy magyarázatot adni a döntéséhez.
Mit tud a Jev?
A TypeSafe a Jevet Daniel Kahneman Thinking, Fast and Slow című könyvének System One fogalmához kapcsolja. A vállalat érvelése szerint a szoftverekben gyakori döntések, például az elfogadás vagy elutasítás, a csapatok közötti továbbítás és az öt címke közül való választás gyors, automatikus döntést igényelnek.
A modell csak a fejlesztő által megadott opciók közül választhat. A valószínűség a modell belső állapotából származik, így összevethető a tényleges eredményekkel, módosítható és küszöbértékekkel használható. Az API confidence mezője ugyanakkor nem egy második pontossági becslés. Azt mutatja, mennyire emelkedik ki a legvalószínűbb válasz.
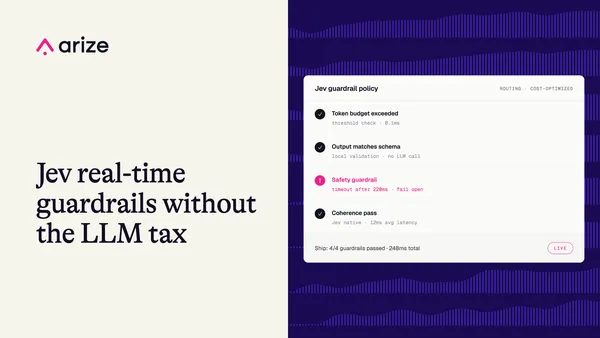
Az Anaconda szerint a Jev használata 0,042 dollárba kerül egymillió bemeneti tokenenként, a kimenetért pedig nem számítanak fel díjat. A vizsgált panaszok átlagosan 630 tokent tartalmaztak, így egy feldolgozás körülbelül 0,00003 dollárba került, a válaszok medián késleltetése pedig 88 ezredmásodperc volt. Sebastian Raschka a 25 000 IMDb-tesztértékelésen 96,5 százalékos eredményt mért, ami az általa finomhangolt ModernBERT modell teljesítményével volt egy szinten. A futtatás költsége körülbelül 65 cent lett.
A modell felépítése részben ismeretlen
A TypeSafe nem tette közzé, hogyan épül fel a Jev, és a modell külön vizsgálatra nem tölthető le. A vállalat szerint a válaszok egyszerre készülnek, a kérdések pedig lehetnek feleletválasztósak, igen-nem típusúak vagy skálán értékelhetők. A Jev egy meglévő nyelvi modellre épül, amelyet a TypeSafe saját, Reinforcement Learning for Calibrated Decisions nevű, nem publikált módszerével tovább képeztek. A vezérigazgató szerint a tanítási adatok teljes egészében szintetikusak.
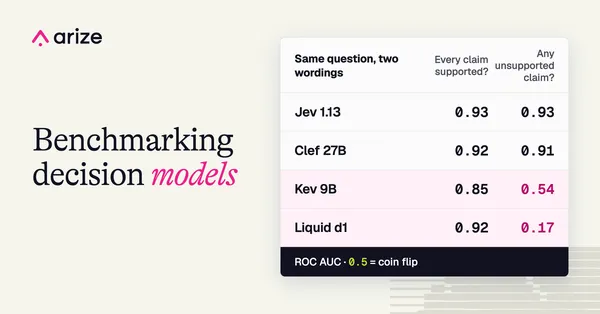
A külső vizsgálatok alapján a kérdések ugyanabban a kérésben nem látják egymás válaszait. Az opciók listája és sorrendje viszont hatással lehet a valószínűségekre. Egy irreleváns ötödik lehetőség hozzáadása egy négyopciós kérdéshez megváltoztatta az eredeti opciók közötti arányt, az opciók megfordítása pedig egy támogatási kérdésnél körülbelül 0,84 és 0,89 közötti értékről 0,93 és 0,96 közé emelte a legjobb válasz valószínűségét.
Az Anaconda tesztjében a Jev 40 panasz esetén 80-ból 79 alkalommal ugyanazt a választ adta az opciók átrendezése után. A valószínűségek ennek ellenére akár 0,20-szal is változtak, és hét esetben átlépték a 0,9-es küszöböt. Azonos kéréseknél, a TypeSafe oldali kötegelt GPU-feldolgozás miatt, legfeljebb 0,04-es eltérést is mértek.
A pontosságot saját adatokon kell ellenőrizni
A jó benchmarkeredmény önmagában nem garantálja, hogy a Jev egy adott szervezet adataival is jól kalibrált valószínűségeket ad. Egy frissen írt matematikai feladatsoron a modell 56 százalékban adott helyes választ, miközben körülbelül 35 százalékos valószínűséget rendelt hozzá, vagyis túl óvatos volt.
A modell nem képes lépésenként érvelni vagy információt keresni. Az Anaconda szerint ezért a praktikus felállás az lehet, hogy a döntési modell kiválasztja a kategóriát, a nyelvi modell pedig megfogalmazza a választ vagy elvégzi a magyarázatot. A Jev bevezetése előtt az opciók sorrendjének hatását, a valószínűségek stabilitását és a küszöbértékeket a saját munkafolyamat példáin kell tesztelni.
Anaconda: Decision Models: Jev vs. a Fine-Tuned Classifier