Kimi K3 AMD MI355X-en: 24,4%-kal több token GPU-nként, mint NVIDIA B300
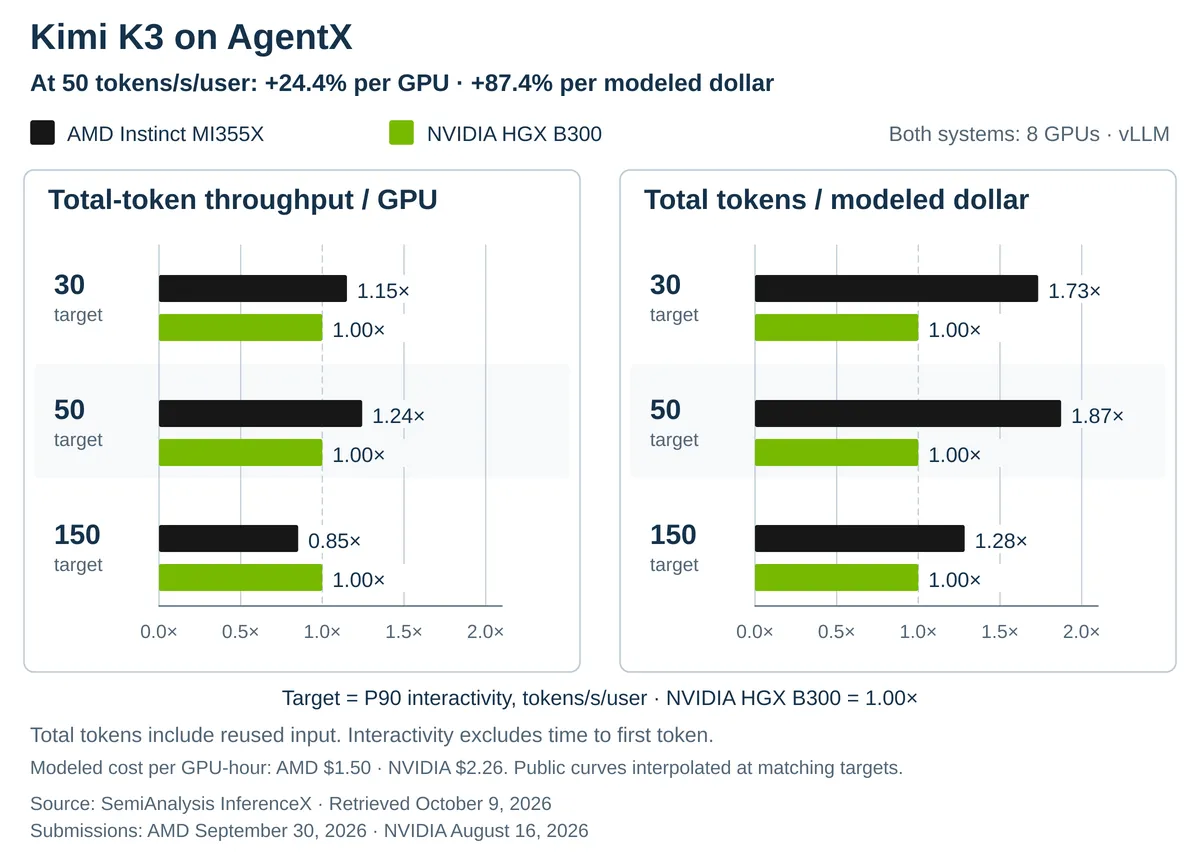
A vLLM csapata szerint egy nyolc AMD Instinct MI355X GPU-t tartalmazó rendszer 24,4%-kal több összesített tokent szolgál ki másodpercenként és GPU-nként a Kimi K3 modellel, mint az NVIDIA HGX B300, az AgentX teszten, 50 token/s/felhasználó P90 interaktivitás mellett.
- Nyolc AMD Instinct MI355X a vLLM szerint 24,4%-kal több összesített tokent ad GPU-nként, mint az NVIDIA HGX B300, 50 token/s/felhasználó P90 interaktivitásnál.
- Mért értékek: kb. 7567 token/s/GPU az AMD-n, 6083 az NVIDIA-n.
- A SemiAnalysis TCO-modellje alapján az AMD 87,4%-kal több tokent ad dolláronként (18,16 millió vs. 9,69 millió).
- A DCP8 egy 142 000 tokenes beszélgetésnél GPU-nként kb. 1,96 GB-ról kb. 245 MB-ra csökkenti az MLA-előzményt.
- A MoE-projekció szétosztása 3,05, 4,91%-kal növelte a kimeneti áteresztőképességet a PR tesztjében.
A mérés eredménye az AgentX tesztben
A vLLM blogbejegyzése szerint az AMD Instinct MI355X nagyjából 7567 összesített tokent szolgál ki másodpercenként és GPU-nként 50 token/s/felhasználó P90 interaktivitás mellett. Az NVIDIA HGX B300 ugyanezen a ponton 6083 tokent ér el, ez 24,4%-os előnyt jelent az AMD javára.
A költséghatékonyság különbsége nagyobb. A SemiAnalysis modellezett teljes birtoklási költsége (TCO) GPU-óránként 1,50 dollár az AMD, illetve 2,26 dollár az NVIDIA esetében. Ebből 18,16 millió, illetve 9,69 millió összesített token jut egy dollárnyi TCO-ra, vagyis az AMD 87,4%-kal több tokent ad dolláronként.
Az adatok a SemiAnalysis InferenceX 2026. október 9-i pillanatképéből származnak. A blog szerint mindkét gyorsító 288 GB HBM3E memóriával és 8 TB/s csúcs memória-sávszélességgel rendelkezik. A publikált sűrű számítási csúcsteljesítmény az MI355X-nél 10,1 PFLOP/s (MXFP4), a B300-nál 13,5 PFLOP/s (FP4).
Mit mér az AgentX
Az AgentX nyilvános benchmark valódi kódolóügynök-munkamenetek nyomait játssza vissza szintetikus tokenekkel. Megtartja a kérések hosszát, időzítését és az előtagok megosztásának mintázatát. A munkaterhelés korlátlan gyorsítótár mellett több mint 96%-os elméleti előtag-újrahasznosítást kínál.
Az interaktivitás a válasz tokenek közötti késleltetésének reciproka, és nem tartalmazza az első token megjelenéséig eltelt időt. Az összesített tokenszám az újrahasznosított bemenetet és a generált kimenetet is magában foglalja. A vLLM hangsúlyozza, hogy a nyilvános görbék teljes kiszolgálási stackeket hasonlítanak össze, az egyes optimalizációk mellett közölt mérések pedig külön tesztekből származnak.
Hogyan épül fel a Kimi K3, és mi lassítja
A bejegyzés szerint a Kimi K3 kétféle figyelmi (attention) réteget használ. A 24 MLA réteg tömörített KV-előzményt őriz, amely a beszélgetéssel együtt nő. A 69 KDA réteg ezzel szemben fix méretű állapotmátrixokat visz tovább, és az új tokenekkel frissíti őket. A MoE rétegekben egy útválasztó (router) választja ki, mely szakértőhálózatok dolgozzák fel az egyes tokeneket.
A vLLM hat optimalizációs területet említ: gyorsítótár, MoE, memóriaforgalom, MLA, KDA és spekulatív dekódolás. A közölt szövegrész az első kettőt részletezi.
Gyorsítótár: az előzmények szétosztása és a CPU-ra szervezés
TP8 mellett minden GPU a Kimi K3 96 MLA lekérdezési fejéből 12-t kezel, de a teljes tömörített KV-előzményt tárolja. A nyolcutas dekódolási kontextus-párhuzamosítás (DCP8) ezt osztja fel: minden GPU a gyorsítótárazott pozíciók egyharmadát helyett nyolcadát tárolja. Dekódolás közben a GPU-k lekérdezéseket cserélnek, a helyi előzményeken számolnak, majd egyesítik a részeredményeket.
Egy 142 000 tokenes beszélgetésnél a becsült MLA-adatmennyiség GPU-nként körülbelül 1,96 GB, amit a DCP8 nagyjából 245 MB-ra csökkent, az allokációs többletet nem számítva.
Ha az állapot már nem fér el a GPU memóriájában, az AMD receptje a vLLM natív CPU-offloadját használja: az MLA-előzményeket és a KDA-ellenőrzőpontokat a gazdagép DRAM-jában őrzi. Egy gyorsítótár-találathoz egyező folytatási pontok kellenek. Ha az MLA-előzmény a 3072. tokenig ér, de a legutóbbi kompatibilis KDA-ellenőrzőpont a 2048.-nál van, a kérésnek onnan kell folytatnia, és az előtag hátralévő részét újra ki kell számolnia. Az attention-blokk végének mentése a KDA-ellenőrzőpont mellett összehangolja ezeket a pozíciókat (#54736).
MoE: a duplikált számítás megszüntetése
Az eredeti ROCm-útvonalon az útválasztott szakértők kimeneti projekciója mind a nyolc GPU-n lefutott, mert mindegyik ugyanazt a látens bemenetet kapta és a teljes súlyokat tartotta. A javítás a kimeneti koordinátákat osztja szét a GPU-k között. Mindegyik csak a saját útválasztott kimenetét adja hozzá a megosztott szakértő részeredményéhez, a teljes eredményt pedig a már meglévő all-reduce állítja össze, új kollektív művelet nélkül (#51253). A ROCm-megvalósítás a megfelelő CUDA-stratégiára épül.
A PR tesztjében, nyolc MI355X GPU-n, TP8 mellett, 8 és 128 közötti párhuzamossággal, véletlenszerű 8K bemenetű és 1K kimenetű kérésekkel, kikapcsolt előtag-gyorsítótárral a kimeneti áteresztőképesség 3,05, 4,91%-kal nőtt.
Egy következő változtatás (#59591) csak azokat a sorokat tölti be, amelyeket az adott rang használ, ami TP8 mellett a 92 MoE rétegen GPU-nként nagyjából 3,85 GiB memóriát szabadít fel. Ez a módosítás a nyilvános eredményhez használt image után került be. Külön AgentX-kísérletben 32 és 48 párhuzamosságnál 1% alatti áteresztőképesség-növekedést mértek, 70-nél viszont 28,9%-ot, miközben a jelentett előtag-gyorsítótár találati aránya 74,8%-ról 80,1%-ra emelkedett. A vLLM szerint a nagyobb nyereség magas párhuzamosságnál a gyorsítótár-nyomással egyezik.
Mit jelent a piacnak
A közölt számok szerint a nagy, előtag-újrahasznosításra épülő ügynöki munkaterheléseknél az AMD hardvere a modellezett költségek mellett versenyképes alternatíva lehet az NVIDIA B300-zal szemben. Az eredmény a teljes kiszolgálási stackre vonatkozik, a vLLM-re, a modellspecifikus kernelekre és a gyorsítótár-kezelésre, nem pusztán a hardverre.
Érdemes észben tartani, hogy a költségelőny a SemiAnalysis modellezett GPU-óránkénti TCO-ján alapul, és a közölt vLLM-mérések konkrét konfigurációkra, valamint a 2026. október 9-i pillanatképre vonatkoznak.
vLLM: Scaling Kimi K3 on AMD Instinct MI355X: Matching NVIDIA HGX B300 Throughput per GPU on AgentX