A vLLM ügynöki kódolással gyorsította a Kimi K3-at
A vLLM új, CuTe DSL-re épülő dekódolási útvonalat készített a Kimi K3-hoz NVIDIA GB300 GPU-kon. A projektben kódoló ügynökök segítettek a GPU-kern el ek, a műveletek összevonása és a kommunikáció optimalizálásában.
- A vLLM új CuTe DSL-es dekódolási útvonalat készített a Kimi K3-hoz.
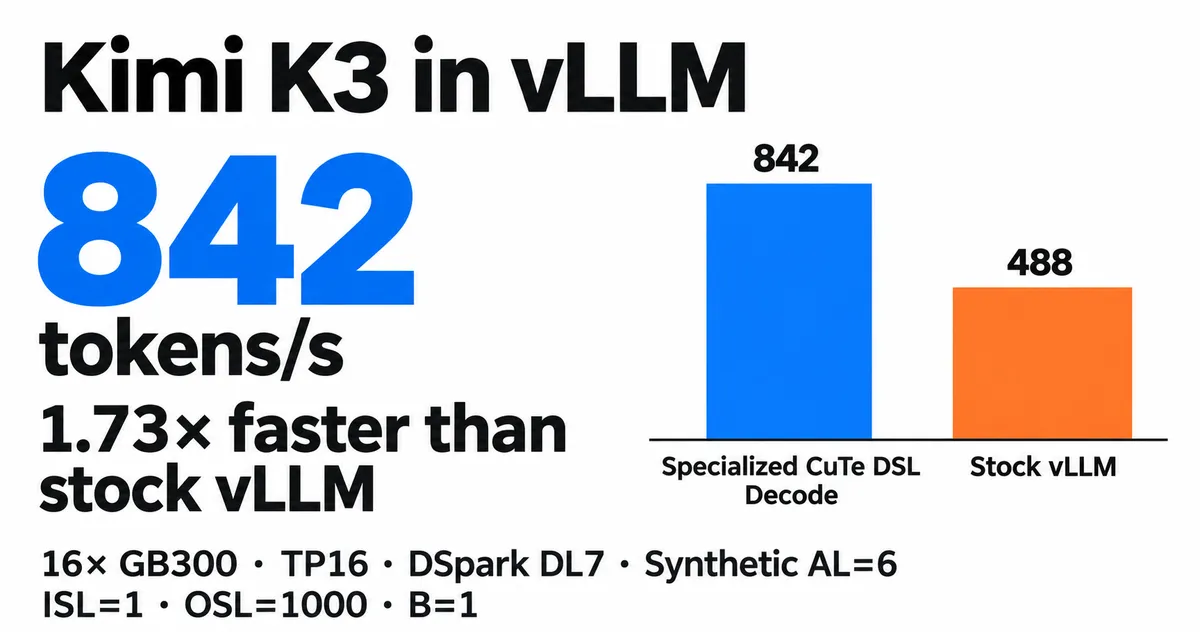
- 16 NVIDIA GB300 GPU-n, batch 1 mellett több mint 840 token/másodpercet mértek a DSpark konfigurációban.
- Több tesztelt konfigurációban 1,5, illetve 2-szeres dekódolási gyorsulást jelentettek.
- A specializált útvonal rétegenként 23 helyett 13 kernelt használ.
- A projektben kódoló ügynökök segítettek a fejlesztésben és a validációban.
Akár 840 token másodpercenként
A vLLM 2026. október 16-i beszámolója szerint az optimalizált Kimi K3-dekódolási útvonal 16 NVIDIA GB300 GPU használatával, egyes kötegméretnél több mint 840 token/másodperces teljesítményt ért el a DSpark szintetikus, AL=6 konfigurációjában. Több vizsgált konfigurációban 1,5, illetve 2-szeres dekódolási teljesítménynövekedést mértek, az AgentX munkaterhelésen pedig a P90 interaktivitás javulása elérte az 1,8-szorost.
Az új útvonal a Kimi K3 szinte valamennyi műveletét egyedi, CuTe DSL-ben írt GPU-kern el ekkel váltja ki vagy vonja össze. A megoldás NVIDIA Blackwell GPU-kra, 8 vagy 16 GPU-s rendszerekre, 1 és 64 közötti dekódolási kötegméretekre, valamint hosszú kontextus esetén opcionális dekódolási kontextus-párhuzamosításra készült. A GPU-k egyetlen, multicast támogatással rendelkező NVLink-tartományon osztoznak.
Kevesebb kernel, összehangoltabb végrehajtás
A vLLM összehasonlítása szerint a készletben található vLLM-réteg egy rétegen belül 130 mikroszekundum alatt és 23 kernellel dolgozik, míg a specializált dekódolási útvonal 69 mikroszekundumot és 13 kernelt használ. A fejlesztők a különböző kötegméretekhez eltérő kernelválasztást alkalmaztak. Kis, 1 és 2 közötti kötegeknél specializált kis mátrixos kerneleket, nagyobb kötegeknél pedig a mátrixszorzást több GPU-s munkavégző között felosztó split-K kerneleket használnak.
Az optimalizálás a számítás és a GPU-k közötti kommunikáció átfedésére is épít. A figyelmi réteg kimeneti projekcióját közvetlenül az all-reduce művelettel és az azt követő maradék-számítással kapcsolták össze. A Mixture of Experts, vagyis MoE-rétegben a router pontszámítását és a látens bemeneti projekciót felosztják a tensorpárhuzamos GPU-k között. A közös expert külön adatfolyamon fut, így munkája konfigurációtól függően átfedhet a routinggal vagy a kiválasztott expert-ek számításaival.
Kis kötegeknél gyakran a memória sávszélessége korlátozza a teljesítményt. Ilyenkor a rendszer kommunikáció közben előre betölti a következő művelet súlyait a gyorsítótárba, hogy később nagyobb legyen a gyorsítótár-találati arány.
Gyors fejlesztés, ellenőrzött kockázattal
A vLLM szerint a kódoló ügynökök már olyan feladatokban is segíthetnek, mint az összetett GPU-kern el ek megírása, a műveletek közötti összevonás, a számítás és a kommunikáció párhuzamosítása, valamint a végrehajtás hangolása különböző kötegméretekhez és GPU-konfigurációkhoz. Ez a fejlesztési sebesség ugyanakkor meghaladja a kód átvizsgálására és karbantartására kialakított munkafolyamat kapacitását.
A vLLM ezért olyan megközelítést javasol, amely elkülöníti a változtatásokat, korlátozza az optimalizálás hatókörét, és rendszeres helyességi, illetve teljesítményteszteket ír elő. A Kimi K3 optimalizálása a projekt első példája erre a modellre épülő munkamódszerre. A módosításokat a modell kódján belül tartják, a támogatott hardvereket és munkaterheléseket előre meghatározzák, miközben a teljes kontextus kiszolgálását, a hőmérséklet-alapú mintavételezést és a strukturált kimenetet a validálandó alapfunkciók között tartják.
A beszámoló szerint az ügynökök feladata a tesztek létrehozása, az értékelések és teljesítménymérések futtatása, a hibák vizsgálata, valamint az optimalizálás működési feltételeinek dokumentálása. Az emberi felülvizsgálók továbbra is a tervet és a bizonyítékokat értékelik, de a vLLM célja, hogy ehhez ne minden kernel minden sorát kelljen külön átnézniük.