A Liquid AI bemutatta a képeket is értő d1 döntési modellt
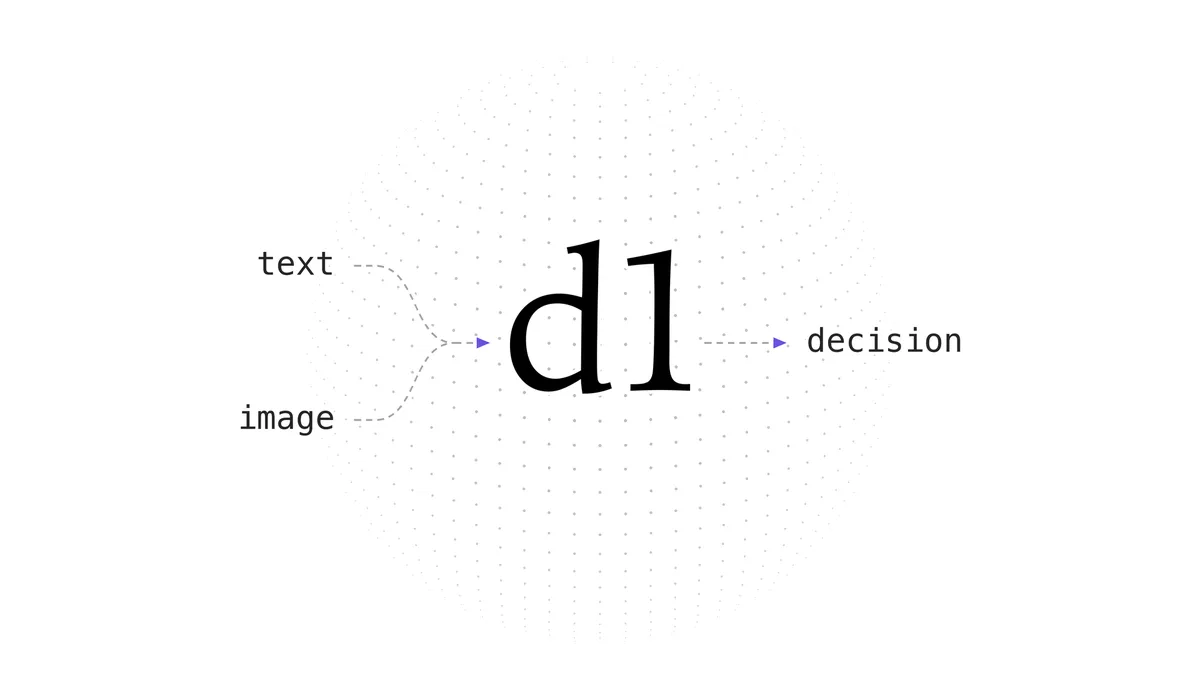
A Liquid AI bemutatta d1 nevű döntési modelljét, amely szövegek mellett képeket is feldolgoz. A vállalat szerint a modell több feladaton a GPT-6.1 Sol teljesítményét érte el vagy múlta felül, miközben jelentősen kevesebbe került és gyorsabban válaszolt.
- A d1 szövegek és képek alapján ad valószínűségi döntéseket.
- A Liquid AI szerint négy összehasonlított feladaton elérte vagy meghaladta a GPT-6.1 Sol eredményét.
- A modell egy szöveges döntést 200 és 300 ezredmásodperc között dolgoz fel.
- A d1 85 és 97 százalék közötti pontosságot ért el négyféle ipari alkatrész vizsgálatában.
- A szolgáltatás a bemeneti tokenek alapján számláz, kimeneti tokenek után nem.
Strukturált válaszokat ad tokenek generálása nélkül
A d1 a Liquid AI első döntési modellje. Bemenetként rendezetlen adatokat, például szöveget, képet vagy ezek kombinációját, valamint egy vagy több kérdést fogad. Egyetlen előremenő feldolgozásban értelmezi ezeket, majd minden lehetséges válaszhoz valószínűséget rendel, anélkül hogy válaszszöveget vagy más tokeneket generálna.
A modell háromféle kérdést támogat. A Noul igen vagy nem jellegű kérdésre ad 0 és 1 közötti valószínűséget. A Choice több címke közül választ, és minden címkéhez valószínűséget rendel. A Score egy skálán helyezi el a választ, az egyes szintek valószínűsége alapján. Egy kérésben több kérdés is feltehető ugyanarról az állapotról, ami a Liquid AI szerint csökkentheti a bemeneti tokenek számát.
A vállalat adatai szerint egy szöveges döntés 200 és 300 ezredmásodperc között készül el, ezért a modell valós idejű alkalmazásokban is használható lehet.
Ipari ellenőrzéstől a kódkeresésig
A Liquid AI hat valós alkalmazáson hasonlította össze a d1-et a GPT-6.1 Sol és a Claude Opus 5.5 modellekkel. A cég szerint a d1 négy feladaton elérte vagy felülmúlta a GPT-6.1 Sol eredményét. A vállalat állítása szerint a modell mindkét másik rendszernél 19-szer, illetve 200-szor olcsóbb volt, és minden vizsgált feladaton gyorsabban válaszolt.
Az egyik bemutatóban a modell négy gyártósorról érkező alkatrészeket vizsgált kameraképek alapján. Áramköri lapokat, gyertyákat, kesudiókat és rágógumit sorolt jó vagy hibás kategóriába, a nyilvános VisA adatkészlet felhasználásával. A Liquid AI szerint a d1 85 és 97 százalék közötti pontosságot ért el, annak ellenére, hogy kifejezetten erre a feladatra nem tanították.
Az öt szöveges alkalmazás között szerepel ügyfélszolgálati jegyek szűrése, kód keresése a Hugging Face transformers tárolójában, dokumentumok mappákba rendezése, repülőjegy-kereső weboldal kezelése, valamint egy kódoló ügynök munkameneteinek tömörítése. Ez utóbbi a cég szerint a tokenek 52 százalékát eltávolította úgy, hogy a feladathoz szükséges kimenetek megmaradtak.
Játékokban is tesztelték a képfeldolgozást
A d1 nyolc klasszikus játékban választja ki a következő lépést. A Liquid AI szerint a képek használata javította a Tetris eredményét: szöveges leírással 70, a játékképernyő hozzáadásával 81 megtisztított sort ért el. Wordle-ben a modell közvetlenül a képernyőképről olvasta le a táblát, és mind a 12 játékot megoldotta, átlagosan 3,8 tippből.
A modell tisztán vizuális feladatot is kapott a Quick, Draw! játékban. A játékos rajzát 62 szó egyikéhez kellett hozzárendelnie. A vállalat szerint hat rajzból átlagosan 5,2-t ismert fel, miközben a véletlenszerű tippelés eredménye 0,6 lett volna.
Elérhetőség és elszámolás
A d1 már használható a Liquid AI API-ján, a Liquid Console felületén létrehozott API-kulccsal. A képes lekérdezésekhez a képeket base64 formátumú adat-URL-ként lehet elküldeni. A teljes API-leírás a döntési modellek dokumentációjában található.
A szolgáltatás csak a bemeneti tokenek után számol díjat, kimeneti tokenek után nem. A képeket a szöveggel azonos, bemeneti tokenalapú rendszerben számítják fel: egy 32×32 pixeles képrészlet 1,5 tokennek felel meg, így egy 1024×1024 pixeles kép 1536 tokenbe kerül. A d1 szöveges változatban a Vercelen és az OpenRouteren is elérhető, a képfeldolgozás ezeken a platformokon a Liquid AI szerint később érkezik.
A vállalat közölte, hogy a következő döntési modelleken új méreteken, új funkciókon, jobb döntési minőségen és alacsonyabb késleltetésen dolgozik. A jövőbeli modellekhez nyílt súlyokat is tervez kiadni a Hugging Face-en.