A Liquid AI látásmodellje akár 3,13-szor gyorsabban dekódol
A Liquid AI bemutatta az LFM2.5-VL-DSpark kísérleti modellt, amely az LFM2.5-VL-3B látásnyelvi modell dekódolását gyorsítja. A vállalat mérései szerint a dekódolási teljesítmény peremeszközökön akár 3,13-szorosára, GPU-kon pedig akár 2,66-szorosára nőhet.
- Az LFM2.5-VL-DSpark az LFM2.5-VL-3B dekódolását gyorsítja.
- A Liquid AI szerint a dekódolás GPU-kon akár 2,66-szor, peremeszközökön akár 3,13-szor gyorsul.
- A vázlatmodell 279,5 millió paraméteres, és 8,9 százalékkal növeli a paraméterszámot.
- A modell támogatja a llama.cpp, az MLX-VLM és az SGLang használatát.
- A kép kódolását és az előfeldolgozást a DSpark nem gyorsítja.
Kis memóriatöbbletért jelentős gyorsulás
A Liquid AI szeptember 24-én tette közzé az LFM2.5-VL-DSpark első, kísérleti változatát. A modell az LFM2.5-VL-3B mellé használható könnyű vázlatkészítő modellként, és a vállalat szerint csak minimálisan növeli a memóriaigényt, miközben érdemben gyorsítja a dekódolást. A cég állítása szerint a kimeneti minőség nem változik.
A dekódolási teljesítmény javulása GPU-kon legfeljebb 2,66-szoros, peremeszközökön pedig legfeljebb 3,13-szoros. A teljes, végponttól végpontig mért áteresztőképesség ugyanezekben a környezetekben akár 2,27-szoros, illetve 2,62-szeres lehet.
A DSpark módszer a modell különböző rétegeiből származó rejtett állapotokat használja arra, hogy egy könnyű modell egyszerre több következő tokent megbecsüljön. A Liquid AI szerint ebből a számítás szempontjából nem következik különbség, hogy a rejtett állapotok szöveget vagy képrészleteket kódolnak, ezért a látásnyelvi modelleken ugyanaz a következtetési algoritmus alkalmazható, mint a szöveges modelleken.
280 millió paraméteres vázlatmodell
A vázlatmodell tanításához a Liquid AI felügyelt finomhangolási adatokat használt, köztük általános látásnyelvi feladatok adatait. Az adatkeveréket azokhoz a munkaterhelésekhez igazították, amelyek kiszolgálására a modellt szánják. A vállalat tíz tanítási kört futtatott, és a célzott látásnyelvi teszteken vizsgálta a tokenek elfogadási arányát.
A végleges architektúra négy réteget és kilences blokkméretet használ. Következtetéskor a Liquid AI nyolcas vagy kilences blokkméretet javasol a hardvertől függően. A vázlatmodell körülbelül 280 millió paraméteres, pontosan 279,5 millió paramétert tartalmaz, és a telepített modell paraméterszámát 8,9 százalékkal növeli.
A tanítási és összehasonlító kísérleteket kizárólag AMD-hardveren, a Liquid AI saját tanítási keretrendszerével végezték. A modell elérhető a Hugging Face-en Safetensors és GGUF formátumban.
Mért eredmények M5 Maxon, M3 Ultrán és H100-on
A kiadáshoz kezdettől támogatást kap a llama.cpp, az Apple Siliconra optimalizált MLX-VLM és az SGLang GPU-kiszolgáló keretrendszer. A közzétett mérésekben a képkódoló és a nyelvi háttérmodell is 16 bites feldolgozást használt, a kvantált modellek gyorsítása nem része ennek a kiadásnak.
Az eszközön végzett teszteket hat látásalapú feladaton futtatták az MMSpec benchmark szerint: általános vizuális kérdésválaszoláson, szöveges vizuális kérdésválaszoláson, képfeliratozáson, diagramok értelmezésén, összetett következtetésen és többfordulós beszélgetésen.
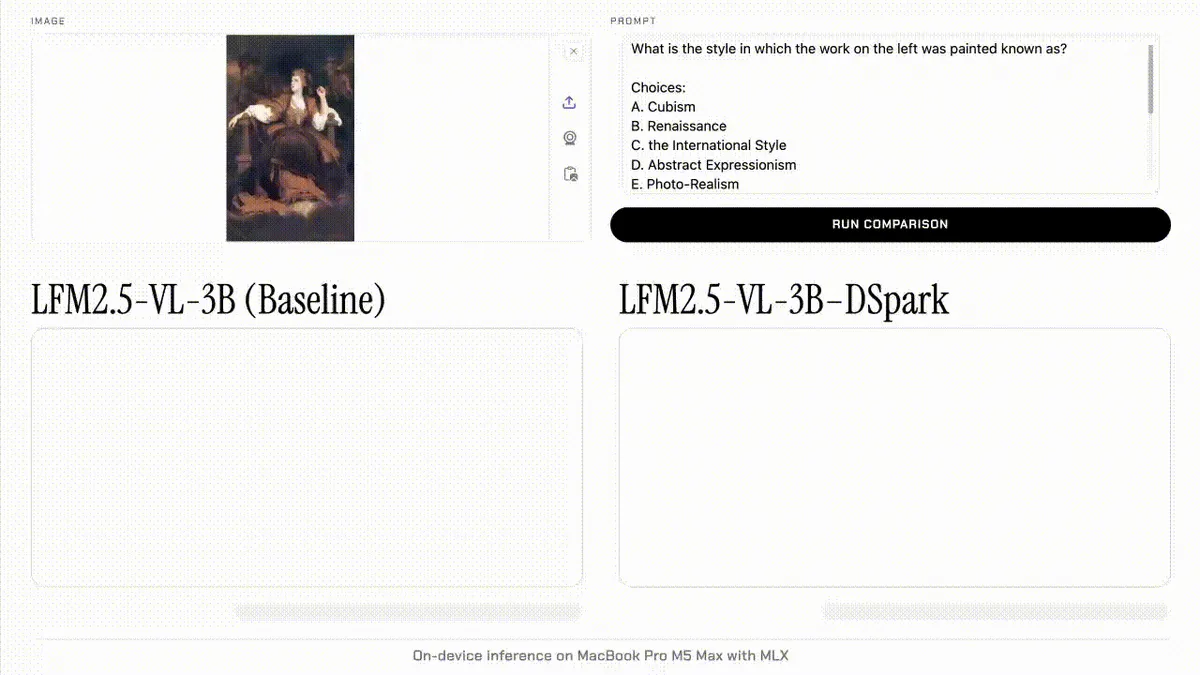
MLX-VLM használatával, egy M5 Max MacBook Prón a dekódolás feladattól függően 2,30 és 3,13-szor gyorsult, a teljes késleltetés pedig 1,56 és 2,62-szer közötti javulást mutatott. Egy M3 Ultra gépen, llama.cpp mellett a dekódolás 1,57 és 2,14-szer, a végponttól végpontig mért teljesítmény 1,30 és 1,77-szer javult.
GPU-s környezetben, egyetlen H100 80 GB-os kártyán, SGLang használatával a dekódolás 2,04 és 2,66-szor, a teljes teljesítmény 1,64 és 2,27-szor javult. A mérések szerint egy ellenőrzési körben nagyjából 3,2 és 4,5 token közötti elfogadás várható eszközön, H100-on pedig 3,46 és 4,57 közötti értéket mértek.
A képfeldolgozás korlátai megmaradnak
A gyorsulás nagyobb párhuzamosság mellett is fennmarad, bár a különbség a konkurens kérések számának növekedésével szűkül. Ennek oka, hogy a DSpark egy célmodell-futtatás során több vázlattokent ellenőriz, így növeli a számítási intenzitást.
A módszer a dekódolási szakaszt gyorsítja. A kép kódolása és a bemenet előfeldolgozása változatlan marad. A látásnyelvi modelleknél a kép először a látásenkóderen halad át, majd a nyelvi modellnek több száz vizuális tokent is fel kell dolgoznia. A Liquid AI szerint peremeszközökön ezek a lépések a teljes késleltetés nagyobb részét adhatják, ezért a dekódolás jelentős gyorsulása csak mérsékeltebb végponttól végpontig javulást eredményezhet.
Az LFM2.5-VL-DSpark így elsősorban azoknak lehet hasznos, akik támogatott környezetben, például llama.cpp, MLX-VLM vagy SGLang használatával szeretnék gyorsabban futtatni az LFM2.5-VL-3B modellt. A Liquid AI közlése szerint a modell letölthető, finomhangolható és korlátozás nélkül telepíthető.