Gyorsabb lehet a képfeldolgozó LFM2.5-VL modell
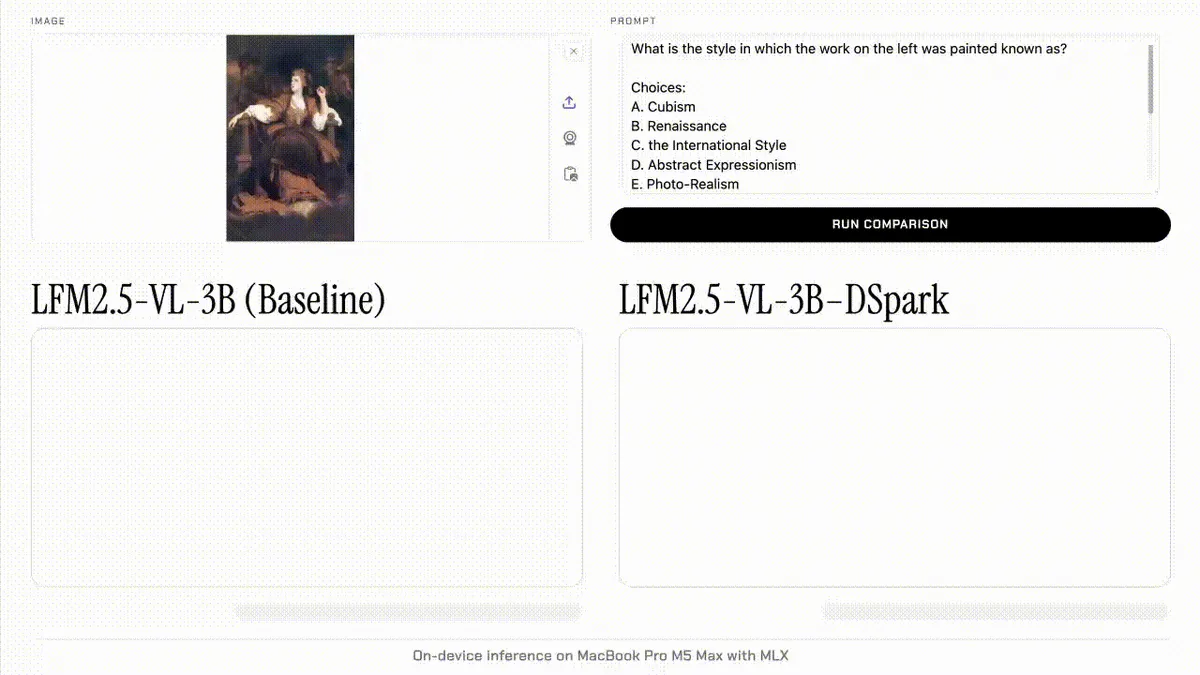
A Hugging Face bemutatta az LFM2.5-VL-DSpark megoldást, amely a képet és szöveget is kezelő modellek következtetését gyorsíthatja. A közzétett adatok szerint a gyorsulás eszközön akár 3,13-szoros, H100 grafikus processzoron pedig 2,66-szoros lehet.
- A Hugging Face bemutatta az LFM2.5-VL-DSpark megoldást.
- A közölt adatok szerint az eszközön mért gyorsulás akár 3,13-szoros lehet.
- H100 grafikus processzoron a forrás legfeljebb 2,66-szoros gyorsulást említ.
- A módszer a képrészleteket és a szöveges tokeneket közös reprezentációba vetíti.
- A projekt támogatja a llama.cpp, az MLX-VLM és az SGLang keretrendszereket.
A spekulatív dekódolást viszi át a képek világába
Az LFM2.5-VL-DSpark az LFM2.5-VL látás-nyelvi modellhez kapcsolódó gyorsítási megoldás. A Hugging Face-en közzétett anyag szerint a módszer a korábbi, szöveges LFM2.5-DSpark modellekben használt megközelítésre épít.
A rendszer egy úgynevezett látási javaslattevőt használ. Ez a célmodell rejtett állapotait rögzíti a modell meghatározott rétegeiben, majd ezek alapján több lehetséges tokent készít elő. A célmodell ezeket a jelölteket ellenőrzi, így a következtetés során egy lépésben nagyobb tokenblokk feldolgozása válhat lehetővé.
A Hugging Face közösségi oldalán szereplő magyarázat szerint a képpontokból származó képrészleteket és a szöveges tokeneket közös reprezentációba vetítik. Emiatt a javaslattevő mindkét bemeneti típusnál azonos dimenziójú rejtett állapotvektorokkal dolgozik, miközben a következtetési algoritmus változatlan marad a szöveges modellekhez képest.
A közzétett mérések szerint jelentős gyorsulást kínál
A projektoldalhoz kapcsolódó anyag címe legfeljebb 3,2-szer gyorsabb következtetést emel ki az LFM2.5-DSpark kapcsán. A látás-nyelvi változatról szóló közösségi magyarázat konkrétan legfeljebb 3,13-szoros gyorsulást említ eszközön, H100 használatakor pedig 2,66-szoros értéket.
Ezeket a számokat a forrás a módszer bemutatásakor közli, ezért a tényleges eredmény az adott hardvertől és munkaterheléstől is függhet. A leírás szerint a cél a következtetés gyorsítása a kimenet minőségének megváltoztatása nélkül, miközben a többlet memóriaigény viszonylag kicsi marad.
Az LFM2.5-VL-DSpark kísérleti modellként jelenik meg. A forrás nem közöl általános teljesítményígéretet minden hardverre vagy feladatra, ezért a megadott értékek a bemutatott mérési környezethez kapcsolódó eredményekként értelmezhetők.
A fejlesztők több környezetben kipróbálhatják
A projekt már az első napon támogatást kapott a llama.cpp, az MLX-VLM és az SGLang keretrendszerekhez. Ez lehetőséget ad a fejlesztőknek arra, hogy a gyorsított látás-nyelvi következtetést több, eltérő célú futtatási környezetben vizsgálják.
A Hugging Face-en megjelent értékelés szerint a közös reprezentáció miatt a DSpark megközelítése újrahasznosítható módon viheti tovább a szöveges modelleknél alkalmazott spekulatív dekódolást a látás-nyelvi rendszerekhez. A felhasználók számára ez gyorsabb képes kérdésválaszolást és egyéb, képet és szöveget együtt kezelő feladatokat jelenthet, de a forrás ezekre nem közöl külön teljesítményméréseket.
A gyakorlati eredményeket a különböző hardverek és munkaterhelések is befolyásolhatják. A projekt fejlesztési iránya ugyanakkor azt mutatja, hogy a modellgyorsítás egyre inkább a látás-nyelvi rendszerek futtatására is kiterjed.
Hugging Face: Accelerating vision-language models with LFM2.5-VL-DSpark