Liquid AI
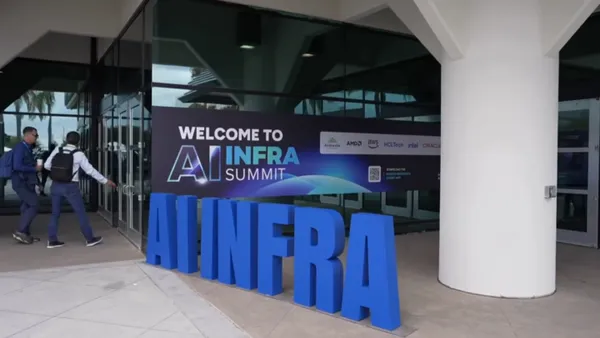
Az Ambarella robotokat és edge AI-rendszereket mutatott be Santa Clarában
Az Ambarella robotikai, logisztikai, biztonsági és járműipari alkalmazásokon keresztül mutatta be, hogyan kerülhet a mesterséges intelligencia a prototípusokból valós…
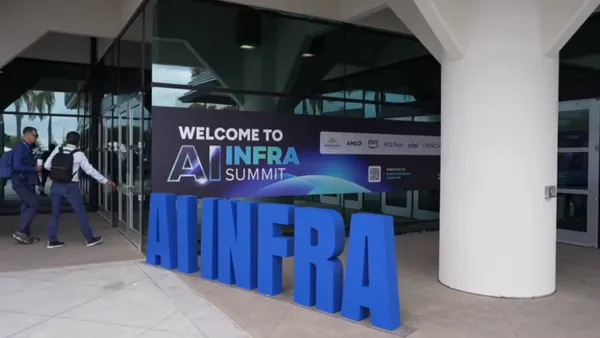
Az Ambarella több mint 50 millió AI-processzort telepített
Az Ambarella több mint 50 millió mesterségesintelligencia-processzor telepítéséről számolt be az AI Infrastructure Summit után. A vállalat a Santa Clara-i eseményen…
Gyorsabb lehet a képfeldolgozó LFM2.5-VL modell
A Hugging Face bemutatta az LFM2.5-VL-DSpark megoldást, amely a képet és szöveget is kezelő modellek következtetését gyorsíthatja. A közzétett adatok szerint a gyorsulás…
A Liquid AI látásmodellje akár 3,13-szor gyorsabban dekódol
A Liquid AI bemutatta az LFM2.5-VL-DSpark kísérleti modellt, amely az LFM2.5-VL-3B látásnyelvi modell dekódolását gyorsítja. A vállalat mérései szerint a dekódolási…
A Liquid AI a Snapdragon eszközökre hozza a személyes AI-kontextust
A Liquid AI és a Qualcomm Technologies Snapdragon processzorokra optimalizálta a Liquid Context eszközön futó kontextusrétegét. A technológia a felhasználó engedélyével…
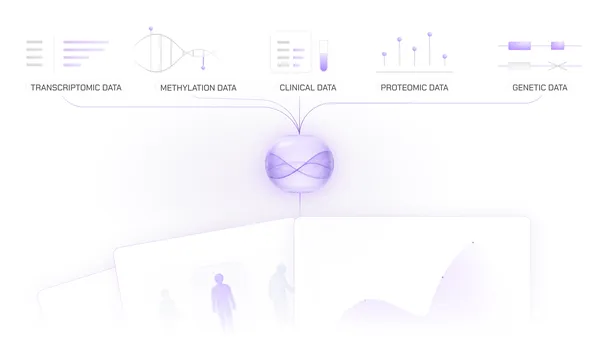
A Liquid AI kis modellekkel vizsgálná az öregedés biológiáját
A Liquid AI bemutatta a LongevityBench tesztkészletet, amely nyelvi modelleket vizsgál öregedéshez és hosszú élettartamhoz kapcsolódó biológiai adatokon. A vállalat…
A Liquid AI Pipette-t adott ki az eszközön futó AI-modellek mérésére
A Liquid AI és az Artificial Analysis nyílt forráskódú benchmarkrendszert indított az eszközökön futó AI-modellek vizsgálatára. A Pipette a sebességet, késleltetést…
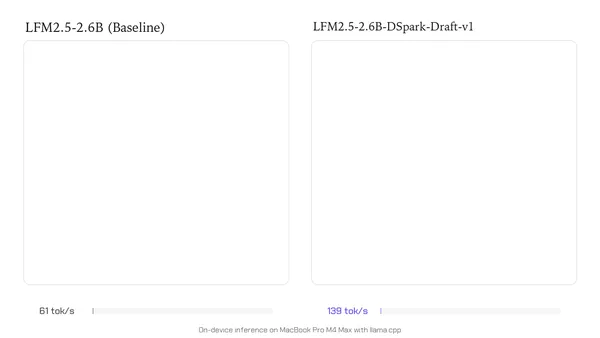
Akár 3,2-szer gyorsabb inferenciát ígér az LFM2.5-DSpark
A Hugging Face-en 2026. augusztus 20-án jelent meg a LiquidAI bejegyzése az LFM2.5-DSpark modellről. A cím szerint a megoldás akár 3,2-szer gyorsabb inferenciát kínál.
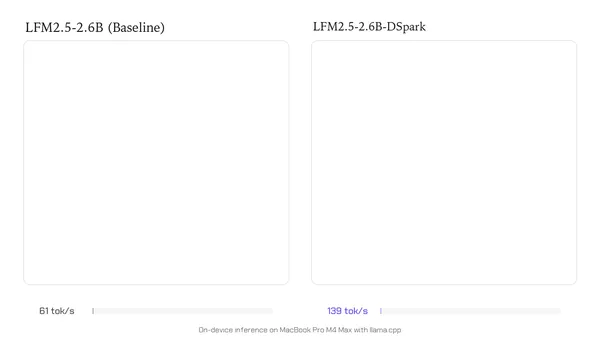
A Liquid AI DSpark modelljei akár 3,18-szoros gyorsulást ígérnek
A Liquid AI elérhetővé tette három LFM2.5 modell DSpark változatát, amelyek a vállalat mérései szerint akár 3,18-szoros átviteli sebességet kínálnak GPU-n, és akár…
A Liquid AI új 4 bites modelljei visszanyerik a pontosság nagy részét
A Liquid AI négy új, 4 bites LFM2.5 checkpointot adott ki, amelyeket kvantálástudatos desztillációval, QAD-del készített. A vállalat szerint a modellek megtartják a Q4_0…
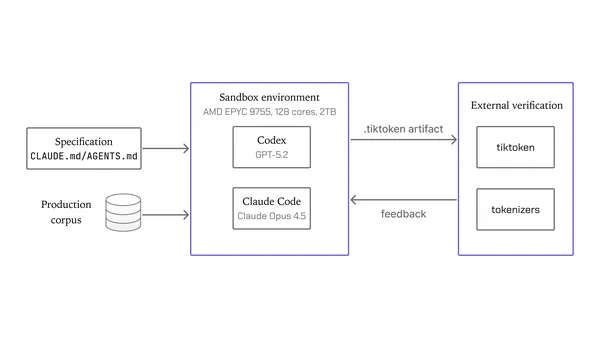
A kódoló ügynököknek iteráció kellett a gyártásérett feladathoz
A Liquid AI két kódoló ügynökkel próbált a semmiből gyártásérett BPE-tokenizáló-trénert készíttetni. Az első prototípusok fél órán belül elkészültek, de a teljes…
Az Liquid AI új, gyors látónyelvi modellje telefonon is fut
Az Liquid AI kiadta az LFM2.5-VL-3B nevű, 3,1 milliárd paraméteres látónyelvi modellt, amelyet gyors, helyi futtatásra terveztek. A vállalat szerint a modell több, nála…
A MacPaw és a Liquid AI helyi mesterséges intelligenciát épít Macre
A MacPaw és a Liquid AI hosszú távú partnerséget kötött a Macen futó, helyi mesterséges intelligencia fejlesztésére. Az együttműködés első terméke az Eney…
A Liquid AI telefonon futó, 2,6 milliárd paraméteres ügynökmodellt adott ki
A Liquid AI kiadta az LFM2.5-2.6B modellt, amely teljes egészében eszközön fut, és tervezésre, eszközhasználatra, valamint többlépéses feladatokra készült. A vállalat…
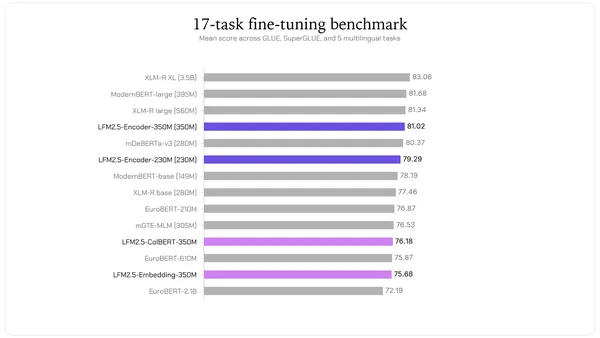
Két CPU-n is gyors encoder modellt mutatott be a Liquid AI
Két új, hosszú bemenetek feldolgozására készült encoder modellt adott ki a Liquid AI. Az LFM2.5-Encoder-230M és 350M akár 8192 tokenes kontextust kezel, és a vállalat…
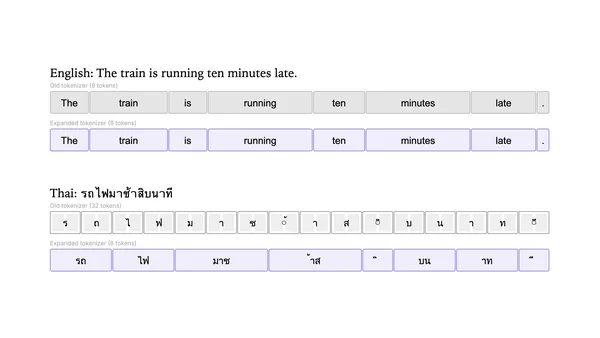
Megduplázta tokenizerének szókincsét a Liquid AI
A Liquid AI olyan eljárást mutatott be, amellyel egy már betanított modell tokenizerét teljes újratanítás nélkül lehet kibővíteni. Az LFM2.5-8B-A1B esetében a szókincs…
Az Antidoom módszerrel csökkentené a modellek végtelen ismétléseit a Liquid AI
A Liquid AI olyan célzott tanítási módszert mutatott be, amely a gondolkodó modellek ismétlődő szöveghurokjait, az úgynevezett doom loopokat mérsékli. Az Antidoom…