Két CPU-n is gyors encoder modellt mutatott be a Liquid AI
Két új, hosszú bemenetek feldolgozására készült encoder modellt adott ki a Liquid AI. Az LFM2.5-Encoder-230M és 350M akár 8192 tokenes kontextust kezel, és a vállalat mérései szerint CPU-n különösen nagy előnyt kínál a hasonló modellekhez képest.
- Megjelent az LFM2.5-Encoder-230M és az LFM2.5-Encoder-350M.
- Mindkét modell legfeljebb 8192 tokenes kontextust támogat.
- A Liquid AI szerint az Encoder-230M 8192 tokennél körülbelül 3,7-szer gyorsabb a ModernBERT-base-nél CPU-n.
- A modellek osztályozási, tokenszintű és keresési feladatokra finomhangolhatók.
- Az új encoderek elérhetők a Hugging Face-en.
Általános célú modellek az LFM2 családból
A Liquid AI július 28-án jelentette be az LFM2.5-Encoder-230M és az LFM2.5-Encoder-350M modelleket. Mindkettő kétirányú encoder, amely az LFM2 hibrid architektúrájára épül. A modelleket osztályozásra, természetesnyelv-feldolgozásra és tokenszintű feladatokra lehet finomhangolni.
A vállalat szerint az új modellek a nagyobb encoderekhez hasonló minőséget kínálnak, miközben a teljesítményük lassabban romlik a bemenet hosszának növekedésével. A támogatott kontextus hossza 8192 token. Ez dokumentumméretű feldolgozást tesz lehetővé olyan hardveren is, amelyben nincs grafikus processzor.
Az LFM2.5-Encoders az előző hónapban kiadott LFM2.5-Retrievers modellek közeli rokonai, de eltérő célra készültek. A Retrievers modelleket többnyelvű keresési feladatokra tanították, az új encodereket viszont maszkolt nyelvi modellezési célfüggvénnyel előtanították. Emiatt többféle későbbi feladatra, például osztályozásra, tokenszintű feladatokra és keresésre is adaptálhatók.
Kétfázisú tanítás és bidirekcionális feldolgozás
A modellek az LFM2.5-230M, illetve az LFM2.5-350M alapokra épülnek. A fejlesztők az oksági dekódert kétirányú encoderré alakították. Ehhez az oksági figyelmi maszkot kétirányú maszkra cserélték, így minden token a tőle balra és jobbra található környezethez is hozzáfér.
Az LFM2 rövid konvolúcióit szimmetrikus középső kitöltéssel nem okságivá tették. Így az egyes tokenek körüli helyi információ mindkét irányból felhasználható. A tanítás során a tokenek 30 százalékát maszkolták, szemben a BERT esetében alkalmazott 15 százalékkal.
Az első tanítási szakaszban a modellek általános nyelvi kompetenciát szereztek rövid kontextusú célfüggvénnyel, egy nagy, csomagolt webes adathalmazon, 1024 tokenes kontextussal. A második szakaszban a kontextust 8192 tokenre bővítették. A Liquid AI szerint ez javította a modellek tárgyi, jogi és többnyelvű teljesítményét.
A vállalat mérései szerint hosszú szövegnél gyorsabbak
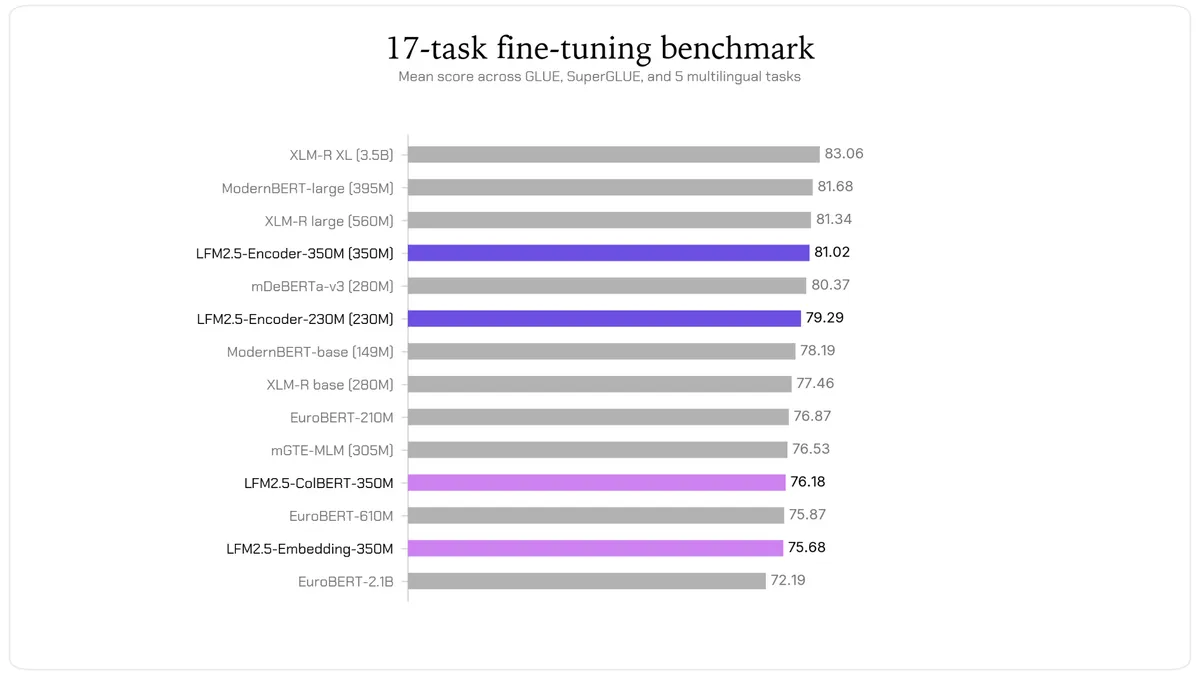
A Liquid AI 14 modellt vizsgált 17 feladaton a GLUE, a SuperGLUE és többnyelvű osztályozási tesztekből. Minden feladathoz teljes felügyelt finomhangolást végzett, az eredményeket pedig öt, a paraméterválasztásban nem használt új véletlen mag átlagaként közölte. A mérési keretrendszert, az indítóprogramokat és a nyers eredményeket nyílt forráskódúvá tették.
A vállalat állítása szerint az LFM2.5-Encoder-350M a 14 modell közül a negyedik helyen végzett, és csak három nagyobb modell előzte meg, köztük egy 3,5 milliárd paraméteres modell. Az LFM2.5-Encoder-230M megelőzte a ModernBERT-base modellt és az összes vizsgált EuroBERT modellt.
CPU-n az LFM2.5-Encoder-230M a Liquid AI méréseiben 1000 token fölött a leggyorsabb modell volt. 8192 tokennél a ModernBERT-base egy előremeneti futása több mint másfél percig tartott, míg az LFM2.5-Encoder-230M körülbelül 28 másodperc alatt végzett, ami a közlemény szerint nagyjából 3,7-szeres előny. Apple GPU-n kisebb különbséget mértek, az LFM2.5-Encoderek körülbelül 2000 token fölött kerültek előnybe.
Helyi feldolgozásra és saját adatokra szánják
A modellek már elérhetők a Hugging Face-en, és a Liquid AI dokumentációt is közöl a helyi futtatáshoz és finomhangoláshoz. A 350M-es változatot a vállalat akkor javasolja, amikor a pontosság fontosabb, a 230M-est pedig szűkebb hardverkeret vagy nagyobb áteresztőképesség esetén.
A Liquid AI három fő felhasználási területet emel ki: a perem- és beágyazott eszközöket, a szabályozott, helyben működő rendszereket, valamint a nagy volumenű, költségérzékeny feldolgozási folyamatokat. Példaként említi a szándékfelismerést, a parancsok osztályozását, a tartalomszűrést, a szerződések osztályozását és az ügyek továbbítását.
A vállalat CPU-only Hugging Face-demókat is készített promptirányításhoz, szabályzatok ellenőrzéséhez, helyesírás-ellenőrzéshez és személyes adatok felismeréséhez. A PII-felismerő demó 40-féle személyes adatot képes észlelni 16 nyelven. Mindkét modell nyílt súlyú, letölthető, finomhangolható és korlátozások nélkül telepíthető a Liquid AI közlése szerint.
Liquid AI: LFM2.5-Encoders: Fast at Long Context, Even on CPU | Blog