A kódoló ügynököknek iteráció kellett a gyártásérett feladathoz
A Liquid AI két kódoló ügynökkel próbált a semmiből gyártásérett BPE-tokenizáló-trénert készíttetni. Az első prototípusok fél órán belül elkészültek, de a teljes feladathoz valós adatokkal végzett ismételt tesztelésre és javításokra volt szükség.
- A Liquid AI két kódoló ügynökkel tesztelt egy gyártásérett BPE-tokenizáló-trénert.
- A Claude Opus 4.5 és a GPT-5.2-re épülő Codex 30 perc alatt működő prototípust készített.
- A teljes adathalmazon memória-, teljesítmény- és helyességi hibák jelentkeztek.
- A Claude Opus 4.5 többszöri javítás után néhány nap alatt lefutó rendszert készített.
- A létrehozott toktoktok tréner nyílt forráskódúvá vált a GitHubon.
Valós problémára kerestek választ
A Liquid AI 2025 végén azt vizsgálta, hogy a kódoló ügynökök képesek-e emberi felügyelet nélkül megoldani egy gyártási szintű problémát. A feladathoz egy olyan byte-pair encoding, vagyis BPE-tokenizáló-trénert kellett létrehozni, amely egyetlen gépen akár billió számú token feldolgozására is alkalmas.
A vállalat szerint a meglévő eszközök nem feleltek meg minden követelménynek. A sentencepiece elsősorban nem BPE-tokenizálókhoz készült és lassú volt, a Hugging Face tokenizers pedig elfogyasztotta a memóriát a használt korpuszokon. A tiktoken nem biztosított tanítási lehetőséget. Az új trénernek emellett támogatnia kellett egy meglévő tokenizáló meleg indítását, vagyis a szókincs bővítését, valamint a nyelvenként eltérő szókincskeretet.
Két ügynök, szigorú ellenőrzési környezet
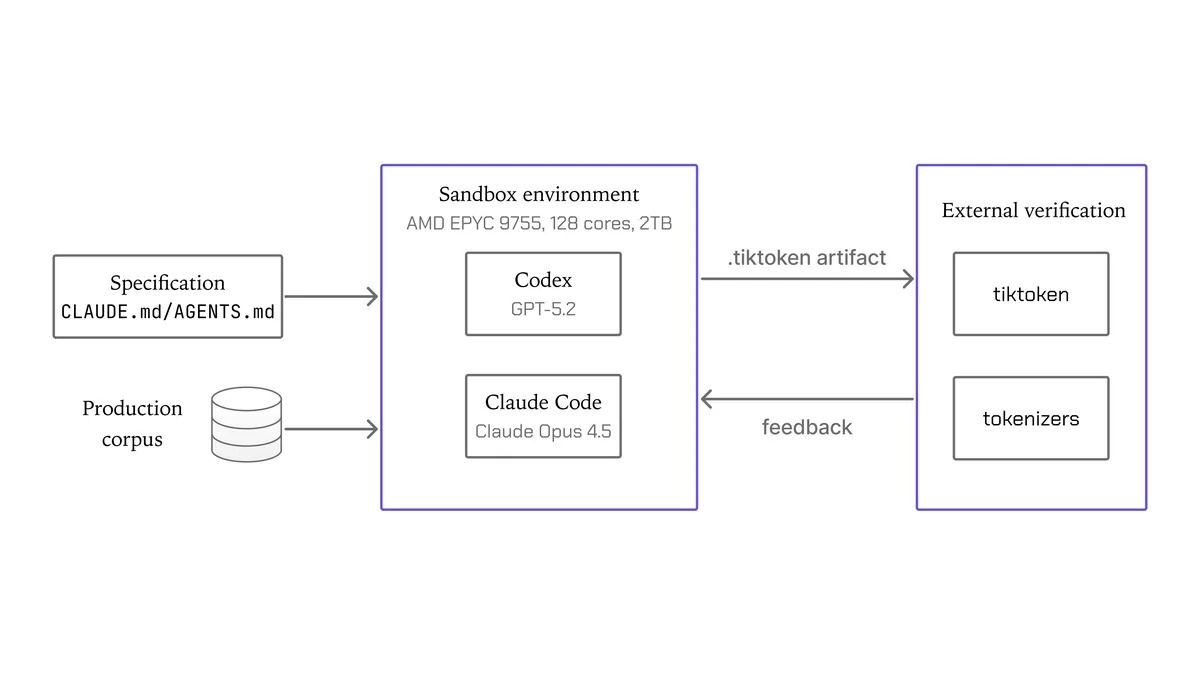
A kísérletben a Claude Opus 4.5 és a GPT-5.2-re épülő Codex vett részt. A Liquid AI a specifikációt egy AGENTS.md, illetve CLAUDE.md fájlban adta meg. Ez a kívánt eredményt és a korlátokat írta le, az implementáció módját viszont nem.
A legfontosabb építészeti szempont a memória volt. A rendszernek a RAM-nál jóval nagyobb korpuszt is kezelnie kellett, miközben a számítási teljesítmény és a bemenet-kimenet kezelése másodlagos szerepet kapott. A megoldáshoz Rustot és többszálú működést jelöltek meg elegendő alapként.
Az ügynökök hozzáférést kaptak egy gyártási tanítóadathalmazhoz, valamint egy 128 magos, 256 szálas, 2 TB memóriával rendelkező AMD EPYC 9755 processzoros géphez. A kész szókincset a tiktokennek és a Hugging Face tokenizersnek is be kellett töltenie. A külső ellenőrző rendszer kódolási és dekódolási oda-vissza teszteket, továbbá azonosító szintű egyezést vizsgált több nyelven, számokkal, pénznemformázással, tabulátorokkal, CRLF sortörésekkel és forráskóddal.
A prototípus gyorsan elkészült, a teljes rendszerhez iteráció kellett
Mindkét ügynök 30 percen belül működő trénert készített. A program feldolgozta a konfigurációt és a korpuszt, végrehajtotta a megadott összevonásokat, lefuttatta a BPE-tanítást, majd érvényes .tiktoken fájlt állított elő. A néhány megabájtos tesztadatokon minden egységteszt sikeres volt.
A teljes gyártási adathalmazzal azonban egyik első változat sem boldogult. A tesztek feltárták a fájlkódolások hibás kezelését, a dokumentumonkénti memóriahasználat problémáit, a nem megfelelő párhuzamosítást és a túl lassú előtokenizálást. Külső ellenőrzés mutatta ki a rangsorrend, a duplikált összevonások és a számok kezelésének hibáit is.
Ezután a vállalat ismétlődő ciklust alkalmazott: az ügynök futtatott, akadályba ütközött, jelentette a tünetet, diagnosztizált és javított, majd újra futott. Több mint öt iteráció után a Codex és GPT-5.2 pályáját leállították, mert a tanítási sebességgel továbbra is küzdött. A Claude Opus 4.5 néhány további kör után olyan trénert készített, amely a több billió tokenből álló, többnyelvű és kódot is tartalmazó adatokon, egyetlen gépen, néhány nap alatt lefutott. A kimenet átment a külső ellenőrzésen.
A tanulság a visszacsatolási kör
A Liquid AI szerint a kísérlet nem azt bizonyítja, hogy az ügynökök egyetlen próbálkozásból képesek megoldani egy gyártási feladatot. A prototípusok sikeres elkészítése kevésnek bizonyult, mert a problémák egy része csak a teljes adathalmazon és külső könyvtárakkal végzett ellenőrzéskor jelent meg.
A vállalat értelmezésében a döntő tényező az iteratív munkafolyamat volt. A tág specifikáció, a valós adatok és az ügynök által nem módosítható ellenőrzés lehetővé tette, hogy a rendszer saját hibáiból haladjon tovább. A toktoktok nevű tokenizáló-tréner a kísérlet eredményeként nyílt forráskódúvá vált a GitHubon.
Liquid AI: Designing Loops for Production-Grade Work | Blog