Megduplázta tokenizerének szókincsét a Liquid AI
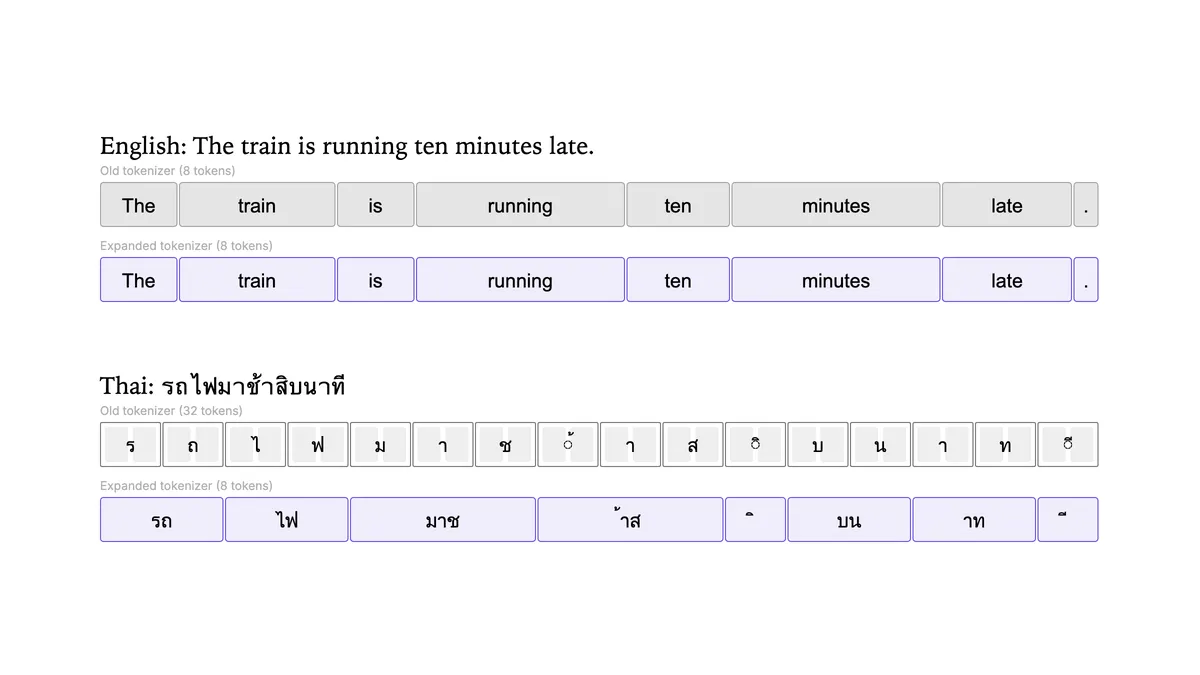
A Liquid AI olyan eljárást mutatott be, amellyel egy már betanított modell tokenizerét teljes újratanítás nélkül lehet kibővíteni. Az LFM2.5-8B-A1B esetében a szókincs 65 ezerről 128 ezer tokenre nőtt, ami többek között a hindi, a vietnámi és a thai nyelv feldolgozását gyorsítja.
- Az LFM2.5-8B-A1B tokenizerének szókincse 65 ezerről 128 ezer tokenre nőtt.
- Hindi nyelven átlagosan 2,4-szer, vietnámiul 2,6-szer, thai nyelven 4,0-szer kevesebb tokenre van szükség.
- A tokenizer bővítéséhez nem kellett a modellt teljesen elölről betanítani.
- A modell és az új tokenizer elérhető a Hugging Face-en, LFM Open License v1.0 licenc alatt.
A meglévő modell tokenizerét bővítették
A Liquid AI július 21-én ismertette az LFM2.5-8B-A1B új tokenizerének elkészítési módszerét. A cél az volt, hogy javítsák azoknak a nyelveknek a tokenizálását, amelyeket az eredeti rendszer túl sok apró tokenre bontott.
A tokenizer a szöveget olyan egységekre bontja, amelyekből a modell felépíti a választ. Mivel a modell minden kimeneti tokennél új dekódolási lépést futtat, a túlzott feldarabolás növeli a késleltetést, a számítási igényt és az energiafogyasztást. Ez különösen fontos a készüléken futó, kisebb modelleknél.
Az LFM2 eredeti, bájtszintű BPE-tokenizere angol nyelvre, kódra és meghatározott nyelvekre készült, a Hindi, a vietnámi és a thai nyelvnek azonban kevés hely jutott a 65 ezres szókincsben. A Liquid AI szerint a tokenizer újratervezése és a modell teljes újratanítása elpazarolta volna a korábbi betanítás során felhasznált számítási erőforrásokat.
A 128 ezres szókincs kialakítása
Az új módszer két fő részből áll. Először a vállalat a régi BPE összevonási szabályait változatlanul átvette, majd ezek folytatásával építette fel a 128 ezres szókincset egy többnyelvű korpusz segítségével. Így a korábbi 65 ezer token nagy része megmaradt, az új tokenek pedig pontosan felbonthatók a régi tokenek sorozatára.
A régi tokenek megtartották eredeti beágyazási soraikat. Az új tokenek beágyazását a hozzájuk tartozó résztokenek sorainak átlagából számították ki, ezért nem véletlenszerű inicializálást használtak. Az LFM2.5-8B-A1B a bemeneti és kimeneti beágyazásokat közös mátrixban kezeli.
Az alkalmazkodás két szakaszban történt. Az elsőben csak az új sorokat tanították 600 milliárd tokenen, miközben a modell többi része rögzítve maradt. A másodikban minden paramétert feloldottak, és 400 milliárd tokenen folytatták a betanítást kiegyensúlyozott, többnyelvű adatokkal. Ezután a modell közvetlenül bekerülhetett az LFM2.5 szokásos középső és utóbetanítási folyamatába.
Kevesebb token, gyorsabb dekódolás több nyelven
A bővített tokenizer a Liquid AI mérései szerint átlagosan 2,4-szer kevesebb tokent használ hindin, 3,4-szer kevesebbet bengáli nyelven, 2,6-szer kevesebbet vietnámiul, thai nyelven pedig akár 4,0-szeres csökkenést ér el. Angol és kód esetében a teljesítmény a vállalat terve szerint változatlan marad.
A nagyobb szókincsnek ára van. A 65 ezerről 128 ezer tokenre váltás a vállalat referenciaeszközein, egy M4 Max processzoron és grafikus vezérlőn, valamint egy Snapdragon 8 Elite Gen 5 rendszeren, tokenenként 7 és 10 százalék közötti lassulást okozott. Ennek oka, hogy a nagyobb kimeneti mátrixot minden dekódolási lépésben be kell olvasni.
A teljes szöveg előállítási idejét azonban a tokenenkénti sebesség mellett a tokenek száma is meghatározza. A Liquid AI becslése szerint ez a megközelítés a célzott nyelveken karakterenként 2,2 és 3,7-szer közötti gyorsulást eredményezhet készüléken. A régi tokenizerrel jól kezelt nyelveknél legfeljebb körülbelül 9 százalékos dekódolási visszaesést mértek.
A modell elérhető a Hugging Face-en
A Liquid AI szerint a tokenizer cseréje kezdetben 5,8 ponttal rontotta a nyolc mérésből képzett összesített eredményt. Az első alkalmazkodási szakasz 4,8 pontot visszahozott, a második pedig megszüntette a fennmaradó különbséget, és az eredeti modell fölé emelte az összesítést. A vállalat ugyanakkor úgy véli, hogy a többlet részben a második szakaszban felhasznált 400 milliárd további tokennek tulajdonítható.
A Global-MMLU eredményei alapján a korábban jól támogatott nyelvek teljesítménye stabil maradt, az alultokenizált nyelvek pedig javultak. Az LFM2.5-8B-A1B nyílt súlyokkal elérhető a Hugging Face-en, az LFM Open License v1.0 licenc alatt. A 128 ezres tokenizerrel együtt telepítési útmutatók is készültek a llama.cpp, az MLX, a vLLM és az SGLang használatához.
A módszer olyan esetekre készült, amikor a fejlesztő birtokolja az eredeti tokenizer összevonási szabályait és speciális tokenbeállításait. Harmadik féltől származó tokenizerre váltásnál ez az eljárás nem alkalmazható. A teljes módszert, a kísérleti összehasonlításokat és az eszközönkénti számokat a Liquid AI technikai jelentése ismerteti.
Liquid AI: Tokenizer Expansion: Upgrading a Model's Tokenizer in Place | Blog