Hierarchikus llms.txt fájlokkal gyorsítja az ügynökök munkáját a Mintlify
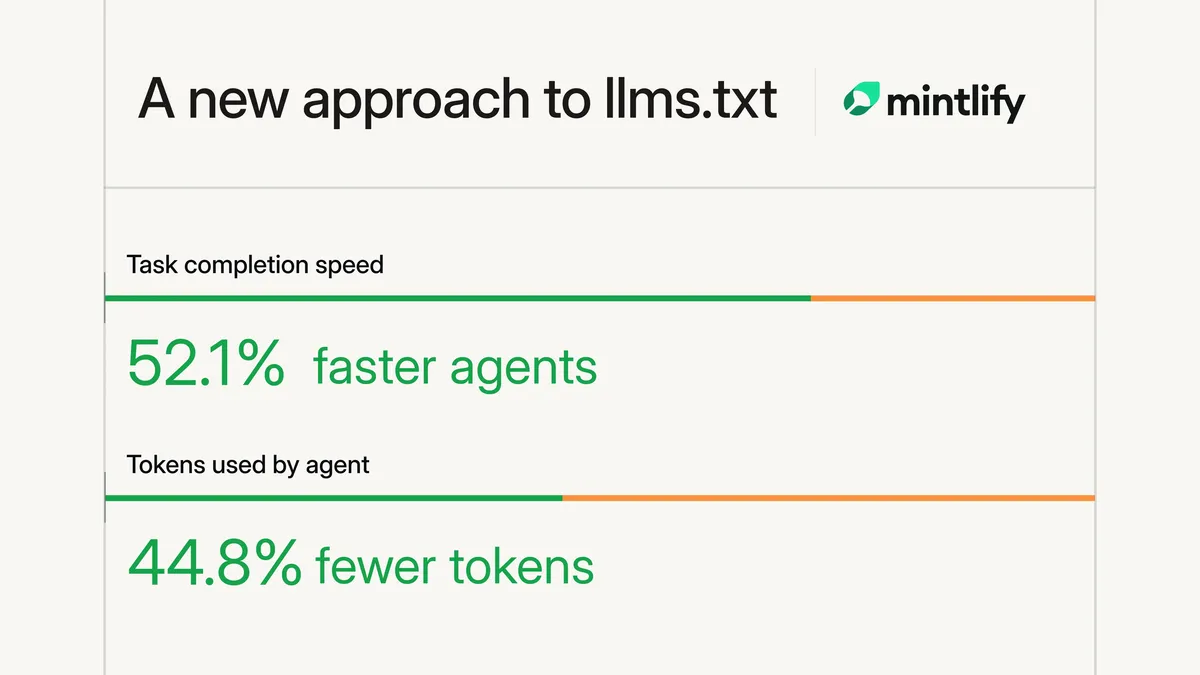
Hierarchikus felépítésű llms.txt fájlokat vezetett be a Mintlify, hogy a mesterséges intelligenciát használó ügynökök csak a releváns dokumentációs ágakat töltsék be. A cég tíz dokumentációs oldalon végzett tesztjei szerint az új megoldás 52,1 százalékkal csökkentette a feladatok elvégzéséhez szükséges időt.
- A Mintlify hierarchikus llms.txt-fájlokat vezetett be.
- A gyökérfájl és a gyermekfájlok legfeljebb 100 000 karakteres egységekre épülnek.
- A tesztelt feladatok átlagosan 52,1 százalékkal gyorsabban készültek el.
- Az átlagos inputtoken-használat 44,8 százalékkal csökkent.
- Az új rendszer minden Mintlify-ügyfél számára elérhető.
A nagy fájlok túl sok felesleges információt tartalmazhatnak
Az llms.txt fájlokat 2024-ben vezették be azzal a céllal, hogy navigációs térképet adjanak az ügynököknek egy webhely tartalmához. Ha azonban a fájl túl nagyra nő, az ügynökök sok, az adott feladathoz nem kapcsolódó információt is megkapnak. Ez megnöveli a kontextusablak terhelését, több token felhasználásához és lassabb feladatvégzéshez vezethet.
A Mintlify eredetileg 100 000 karakteres korlátozással kezelte a problémát. A cég szeptember 1-jén közzétett beszámolója szerint az elmúlt két évben bővültek a platformon működő dokumentációs oldalak, ezért ennek az ideiglenes megoldásnak egyre jobban láthatóvá váltak a korlátai.
A navigációs struktúra alapján épül fel a fájlhierarchia
Az új rendszer a teljes navigációs részeket gyermekfájlokba helyezi át, miközben a gyökérként szolgáló /llms.txt fájlban hivatkozást hagy rájuk. Egy ilyen gyermekfájl közvetlen oldalhivatkozásokat vagy egy mélyebb gyermekfájlra mutató linket tartalmaz. Így az ügynök a releváns ágat követheti, és csak az ahhoz szükséges fájlokat tölti be.
A generátor a Mintlify dokumentációs konfigurációs fájljában, a docs.json-ban található navigációs struktúrát használja. Egy termék, verzió, nyelv, csoport vagy API-referencia szekciója külön gyermekfájl jelöltje lehet. Ha egy index túl nagy, a rendszer azt a jelöltet választja, amely a legtöbb helyet szabadítja fel, majd szükség esetén megismétli a folyamatot.
A gyermekfájlok a /_llms/*.md útvonalon jelennek meg. Az útvonal a navigációs hierarchiát tükrözheti, ezért nem feltétlenül egyezik meg a webhely URL-struktúrájával. Ha a gyökérfájl legfeljebb 100 000 karakteres, a rendszer változatlanul hagyja.
A tesztekben kevesebb tokennel és rövidebb idő alatt dolgoztak az ügynökök
A Mintlify tíz nagy, a platformján működő dokumentációs oldal rögzített állapotán hasonlította össze a régi és az új generálási módszert. Oldalanként tíz kérdést állítottak össze, majd minden feladatot három alkalommal futtattak le. A feladatok közül nyolc olyan oldalakra vonatkozott, amelyek a régi generálásban nem szerepeltek, kettő pedig látható oldalakhoz kapcsolódott.
A feladatokat Claude Code segítségével, Sonnet 5 és GPT-5.6 Terra modellekkel oldották meg. Az átlagos feladatvégzési idő 363,6 másodpercről 174,2 másodpercre csökkent, ami 52,1 százalékos javulás. Az input tokenek száma 1,74 millióról 960 ezerre esett vissza, ez 44,8 százalékos csökkenés. A feladatonkénti hibás oldalhivatkozások átlagos száma 181,80-ról 21,57-re mérséklődött.
A Mintlify szerint az új llms.txt-generálási architektúra már minden ügyfelük számára elérhető, és a dokumentáció minden közzétételekor automatikusan újragenerálódik. A cég külön dokumentációt is biztosít a generálásról, a kézi felülírásokról és az ügynökök számára fontos fájl működéséről.
Mintlify: Scaling llms.txt