Az NVIDIA bemutatta a Nemotron 3.5 Lightning nyílt AI-modellt
Az NVIDIA 2026. augusztus 11-én bemutatta a Nemotron 3.5 Lightning modellt, amelyet hosszú ideig futó AI-ügynökök nagy volumenű, alacsony késleltetésű végrehajtási feladataira terveztek. A nyílt, 30B méretű mixture-of-experts modell 3B aktív paraméterrel működik.
- A Nemotron 3.5 Lightning nyílt, 30B MoE-modell 3B aktív paraméterrel.
- A modell hosszú ideig futó AI-ügynökök nagy volumenű végrehajtási feladataira készült.
- BF16 mellett NVFP4 kvantált ellenőrzőponttal érkezik Blackwell, Hopper és Ampere GPU-khoz.
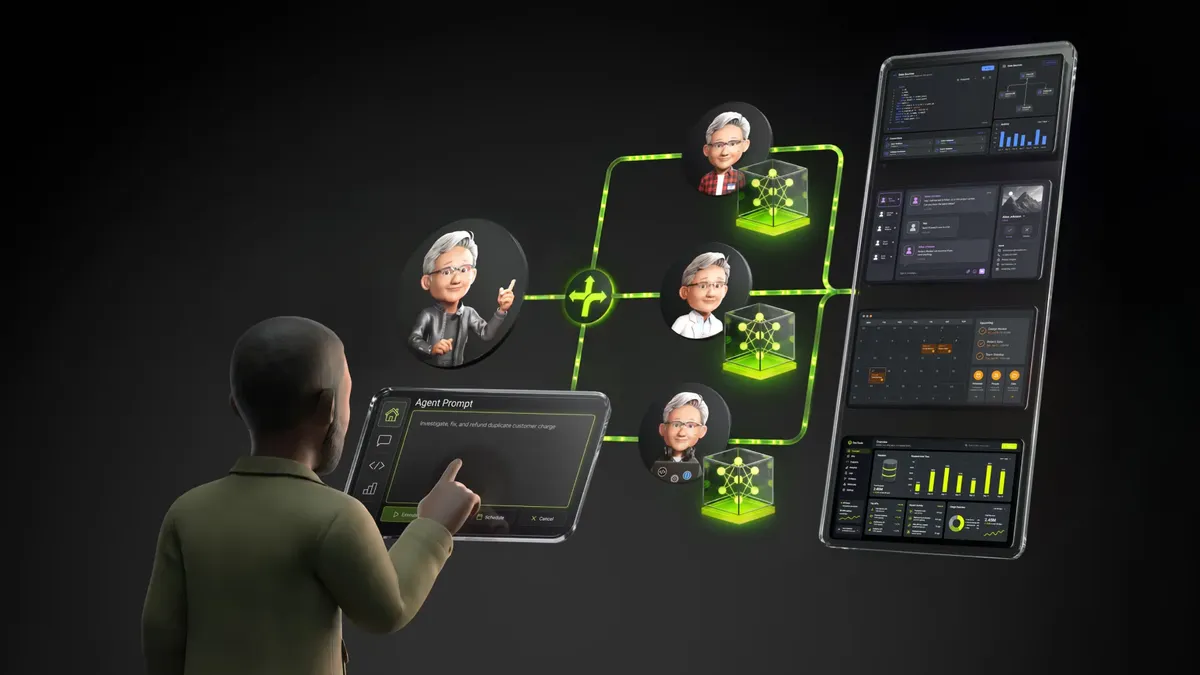
- A NeMo Switchyard a kéréseket a feladathoz illő modellhez irányítja.
- A PinchBench szerint 10,000 feladatot 30% gyorsabban teljesített, mint a Qwen3.6 35B hasonló pontosság mellett.
Kisebb MoE-modell az ügynökök végrehajtási rétegéhez
Az NVIDIA Developer blogon megjelent bejelentés szerint a Nemotron 3.5 Lightning egy nyílt, 30B méretű mixture-of-experts, vagyis MoE-modell, amely tokenenként 3B aktív paramétert használ. A vállalat a modellt a hosszú ideig futó, folyamatosan működő AI-ügynökök végrehajtási rétegéhez pozicionálja, ahol a rendszer jellemzően eszközhívásokat, eredményellenőrzést és alügynökök delegálását végez.
Az NVIDIA szerint az ilyen ügynökök idejük nagy részét nagy volumenű végrehajtási feladatokkal töltik, és minden lépéshez egy frontier reasoning modell használata többletköltséget és késleltetést adhat. A Nemotron 3.5 Lightning ezért a kisebb, hatékonyabb modellek szerepét célozza meg egy többmodellből álló rendszerben. A bejegyzés példaként említi, hogy a Nemotron 3 Ultra az összetett tervezést és orchestration feladatokat kezelheti, míg a kisebb modellek a nagy gyakoriságú végrehajtást végzik.
A modell az NVIDIA közlése szerint olyan keretrendszerekhez készült, mint az OpenClaw és a Hermes Agent, amelyeket az NVIDIA NemoClaw nyílt forrású biztonsági és menedzsment stack támogat a folyamatosan futó AI-ügynökök működtetéséhez. A Nemotron 3.5 Lightning a Nemotron 3 modellcsalád legkisebb tagja, és több olyan technikát kapott, amelyet a család többi modelljénél is alkalmaznak.
Spekulatív dekódolás, testreszabás és kvantálás
A Nemotron 3.5 Lightning egyik fő technikai eleme a spekulatív dekódolás. Az NVIDIA szerint a modell előtanítása során beépítették a többtokenes előrejelzést, ahogy a Nemotron 3 Super és a Nemotron 3 Ultra esetében is. A tréning után külön MTP-erősítő fázis javította tovább a többtokenes előrejelzés pontosságát.
A modellhez két draft modell is érkezik: a DSpark és a DFlash. A forrás szerint a DSpark a DGX Spark inference munkaterhelésekhez és az alacsony konkurenciájú adatközpontos feladatokhoz ajánlott. Az MTP közepes és magas konkurencia mellett illeszkedik jobban, az optimális draft hossz pedig a konkurencia növekedésével csökken. Az NVIDIA a DFlash draft modellt is kiadja, amelyet a fejlesztők saját munkaterheléseiken mérhetnek össze a többi megoldással.
A bejelentés szerint a Nemotron 3.5 Lightning BF16 mellett NVFP4 kvantált ellenőrzőponttal is elérhető. Ez ugyanazokat a specializált NVFP4 kerneleket használja, amelyek a Nemotron 3 Ultra esetében is működnek NVIDIA Blackwell, NVIDIA Hopper és NVIDIA Ampere GPU-kon. Az NVIDIA állítása szerint ugyanaz a fájl adatközpontban és asztali DGX Spark környezetben is használható.
A testreszabásnál az NVIDIA a LoRA és a teljes SFT használatát emeli ki a NeMo Automodel és a NeMo Megatron Bridge eszközökkel. A megerősítéses tanuláshoz, környezetalapú értékelésekhez és rolloutokhoz a NeMo RL és a NeMo Gym szerepel a bejelentésben. A kiadás része a Nemotron-RL Agentic Terminal Pivot nevű nyílt agentic reinforcement learning adatkészlet is, amelyet a forrás szerint egyes kódolóügynök-képességek tanításához használtak. Az NVIDIA azt írja, hogy a súlyokat, tanítási adatokat és recepteket az OpenMDW-1.1 alatt, a lehető legmegengedőbb módon adja ki.
NeMo Switchyard: feladatok irányítása a megfelelő modellhez
A bejelentés másik fontos eleme az NVIDIA NeMo Switchyard, amely a kérések modellhez irányítását és az orchestration feladatokat kezeli. A cél az, hogy egy alkalmazásban a különböző modellek eltérő szerepet kapjanak: a tervezési feladatok a nagyobb képességű modellekhez kerüljenek, a végrehajtási feladatok pedig a Nemotron 3.5 Lightninghoz.
Az NVIDIA példái szerint a Lightning jellegű modellek olyan rutinműveleteknél kaphatnak szerepet, mint a git pull, az eszközkimenetek ellenőrzése, az eredmények formázása és más gyakori hívások, amelyek meghatározzák egy hosszú ideig futó ügynök tokenköltségét. A Switchyard a Nemotron 3.5 Lightningot routing célpontként tudja kezelni más nyílt és zárt modellek mellett, hogy a kérés ahhoz a modellhez jusson, amely az adott feladatra a legalkalmasabb és leghatékonyabb.
Mérések: sebesség és pontosság a kis nyílt modellek között
Az NVIDIA szerint a Nemotron 3.5 Lightning a kis nyílt modellek között meghatározza a pontosság és sebesség Pareto-határát az Artificial Analysis Intelligence Indexen. A forrás alapján ez az index kilenc értékelést kombinál, és agentic feladatokban, kódolásban, tudományos következtetésben és általános intelligenciában méri a modellek teljesítményét.
A vállalat állítása szerint a Nemotron 3.5 Lightning hasonló méretű modellekhez képest akár 4x kimeneti sebességet ér el. A bejelentés külön hangsúlyozza, hogy az ügynökök hatékonyságánál nem egyszerűen a tokenek generálási sebessége számít, hanem az, hogy a modell milyen gyorsan végez hasznos munkát.
A PinchBench mérésen a Nemotron 3.5 Lightning 86% pontosságot ért el, miközben 10,000 feladatot 30% gyorsabban teljesített, mint a Qwen3.6 35B hasonló pontosság mellett. Az NVIDIA szerint a nagyobb inference áteresztőképesség és a tokenhatékonyság segíti a folyamatosan működő ügynököket abban, hogy a nagy volumenű munkát gyorsabban fejezzék be.
Mit jelent ez a fejlesztőknek és a piacnak?
A bejelentés alapján az NVIDIA a Nemotron 3.5 Lightningot olyan építőelemként kínálja, amely a nagyobb modellek mellett kaphat szerepet az agentic AI rendszerekben. A fejlesztők a build.nvidia.com oldalon interaktívan kipróbálhatják a modellt, a súlyokat a Hugging Face-ről tölthetik le helyi telepítéshez és testreszabáshoz, a finomhangolási és telepítési útmutatókat pedig a Nemotron 3.5 Lightning cookbook tartalmazza.
A felhasználói hatás közvetetten jelentkezhet: a forrás szerint a modell olyan ügynöki rendszerekhez készült, ahol sok ismétlődő végrehajtási lépést kell gyorsan és hatékonyan kezelni. Ha a fejlesztők a feladatokat a NeMo Switchyardhoz hasonló routing megoldással osztják szét, a bonyolult tervezést nagyobb modellekre, a gyakori végrehajtást pedig a Lightningra bízhatják. Ez a megközelítés az NVIDIA szerint hatékonyabb tokenfelhasználást és alacsonyabb késleltetést céloz a hosszú ideig futó AI-ügynökökben.