Day 0 támogatást kapott a vLLM-ben az NVIDIA új multimodális modellje
A vLLM bejelentette az NVIDIA Nemotron 3.5 Super VL támogatását, így a 120 milliárd paraméteres multimodális modell azonnal bevethető a vLLM szolgáltatási rétegén keresztül. A modell szöveg, kép, dokumentum és videó feldolgozására, valamint eszközhasználatra és hosszú ideig futó ügynöki feladatokra készült.
- A vLLM Day 0 támogatást jelentett be az NVIDIA Nemotron 3.5 Super VL modellhez.
- A modell 120 milliárd paraméteres MoE-architektúrát használ, ebből 12 milliárd aktív.
- Szöveget, képet, dokumentumot és videót fogad, szöveges kimenetet ad.
- BF16 és NVFP4 modellsúlyok érhetők el a Hugging Face-en.
- A modell NVIDIA NeMo-val vállalati adatokhoz, eszközökhöz és munkafolyamatokhoz igazítható.
Egy modell a multimodális ügynöki feladatokra
Az NVIDIA Nemotron 3.5 Super VL egy nyílt, testreszabható multimodális modell, amely a vállalat leírása szerint a vizuális információk értelmezését, a következtetést, az utasításkövetést és az eszközhasználatot egy rendszerben egyesíti. Bemenetként szöveget, képeket, dokumentumokat és videót kezel, kimenetként szöveget állít elő.
A megközelítés célja, hogy a fejlesztőknek ne kelljen külön szöveges és látási modelleket üzemeltetniük az egyes munkafolyamatokhoz. A modell a feladat szempontjából fontos kontextust is megőrizheti a munkafolyamat különböző lépései között. A vLLM 2026. október 15-i közleménye szerint a Nemotron 3.5 Super VL-t nagy pontosságú végrehajtó modellként szánják olyan modellrendszerekbe, ahol natív dokumentum-, kép- és videóértésre van szükség.
120 milliárd paraméter, 12 milliárd aktív paraméter
A modell kevert szakértői, vagyis mixture-of-experts architektúrára épül. Összesen 120 milliárd paramétert tartalmaz, tokenenként azonban 12 milliárd aktív paramétert használ. Az NVIDIA szerint ez az elrendezés a pontosságot és a hatékonyságot egyaránt támogatja a folyamatosan futó, specializált ügynöki feladatoknál.
A Nemotron 3.5 Super VL C-RADIOv4 látási kódolót, hibrid Mamba-Transformer architektúrát, többtokenes előrejelzést és NVFP4-kvantálást használ. A többtokenes előrejelzés során a modell beépített fejei jövőbeli tokeneket javasolnak, amelyeket a célmodell ellenőriz. Ez csökkentheti a hosszabb válaszok előállításához szükséges egymás utáni lépések számát.
Az NVIDIA saját mérése szerint a modell egyetlen GPU-n, azonos méretkategóriájú más nyílt modellekhez képest, akár ötször nagyobb áteresztőképességet érhet el ügynöki feladatoknál. A közlemény több mint 600 kimeneti token/másodperc értéket említ 100 000 bemeneti token mellett. Ezeket az eredményeket az NVIDIA által közölt összehasonlítások részeként kell értelmezni.
A vLLM szolgáltatási rétege és a támogatott hardver
A vLLM a modell éles környezetbe állításához szükséges szolgáltatási réteget biztosítja. A közlemény szerint ide tartozik a folyamatos kötegelt feldolgozás, az előtag-gyorsítótárazás, a spekulatív dekódolás és az OpenAI-kompatibilis API. A fejlesztők a modellsúlyokat BF16 és NVFP4 formátumban tölthetik le a Hugging Face-ről.
A támogatott telepítési célpontok között szerepel egy GB10, B200, B300, RTX PRO 6000 vagy H200 GPU, illetve két H100 GPU. A vLLM bejelentése egy 1× GB200 konfigurációhoz is mutat NVFP4-indítási példát, ugyanakkor hangsúlyozza, hogy azt a használni kívánt hardveren érdemes ellenőrizni. A gyártási kiszolgáláshoz az NVIDIA NIM szolgáltatását jelöli meg optimalizált megoldásként felhős és adatközponti környezetekben.
Testreszabható vállalati munkafolyamatok
A szervezetek az NVIDIA NeMo használatával saját adataikhoz, eszközeikhez, szabályzataikhoz és munkafolyamataikhoz igazíthatják a modellt. A vLLM és az NVIDIA példaként említi az ügyfélszolgálati ügyintézést, ahol a rendszer dokumentumokat és képeket értelmezhet, szabályzatot alkalmazhat, majd szolgáltatási eszközöket használhat.
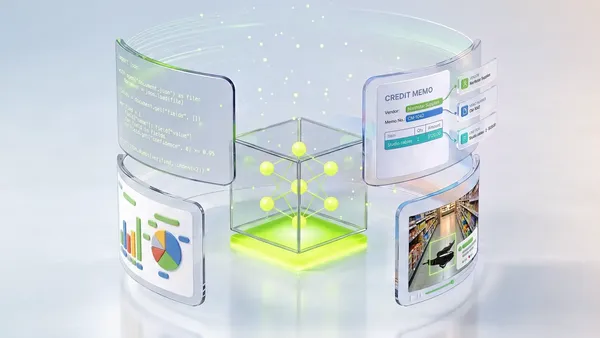
További felhasználási terület a dokumentumintelligencia, beleértve az OCR-t, a táblázatokat, a diagramokat és az oldalak elrendezését. A modell vállalati produktivitási feladatokban, videók elemzésében, webes kutatásban, tartalomellenőrzésben, reklámipari, kiskereskedelmi és incidenselemzési munkákban is használható a közlemény szerint. A vLLM támogatása így azoknak a fejlesztőknek lehet fontos, akik egyetlen, vizuális bemeneteket is kezelő modellre építenének hosszú ideig futó ügynöki folyamatokat.