Új módszerrel tesztelnék, hogy az AI-monitorok felismerik-e a károkozást
A Redwood Research bemutatta a simulated control evaluations, vagyis SCE nevű módszert, amely azt vizsgálja, hogy az AI-rendszereket felügyelő monitorok felismernék-e a szándékos károkozást. A megközelítés a valós telepítésekhez közelebb álló teszteket ígér anélkül, hogy a támadásokat ténylegesen végre kellene hajtani a fejlesztő rendszerein.
- A Redwood Research bemutatta a simulated control evaluations módszert.
- Az SCE-k LLM-szimulátorral tesztelik a monitorokat valódi támadás végrehajtása nélkül.
- A LinuxArena összevetéseiben a szimulált és valódi futtatások eltérése gyakran kicsi volt.
- A módszer alkalmazása továbbra is extrapolációt igényel a valódi telepítési környezetekben.
- A hosszú lefolyású, több ügynököt használó támadások vizsgálata még hiányzik.
A monitoroknak valódi támadási kísérleteket kell felismerniük
Az AI-fejlesztők egyre gyakrabban használnak monitorokat az ügynöki rendszerekben. Ezek a modellek jelzik vagy blokkolják az ügynök olyan műveleteit, amelyek veszélyesnek tűnnek. A Redwood Research szerint egy monitor értékeléséhez azt kell megvizsgálni, milyen gyakran állítana meg egy olyan modellt, amely aktívan próbál kárt okozni.
Ilyen cél lehet például egy biztonsági rés csendes beillesztése, hitelesítő adatok megszerzése vagy egy kísérlet szabotálása. A jelenlegi kontrollértékelésekben a támadó modellt arra utasítják, hogy hajtson végre ilyen támadásokat, majd mérik, hogy a monitor felismeri-e azokat a siker előtt. A tesztekhez gyakran olyan környezeteket használnak, mint a BashArena vagy a LinuxArena, ahol a támadások ténylegesen végrehajthatók.
A Redwood szerint ezek a környezetek azonban csak közvetett képet adnak arról, hogyan működne egy monitor valódi telepítésben. Ott a károkozási lehetőségek az adott kódbázistól, szolgáltatásoktól és feladatoktól is függhetnek. Egy teljes, hű másolat felépítése minden telepítési környezethez túl sok mérnöki munkát igényelne, a közvetlen tesztelés pedig azt jelentené, hogy a fejlesztők ténylegesen megtámadják saját rendszereiket.
A szimulátor írja meg a hihető eszközválaszokat
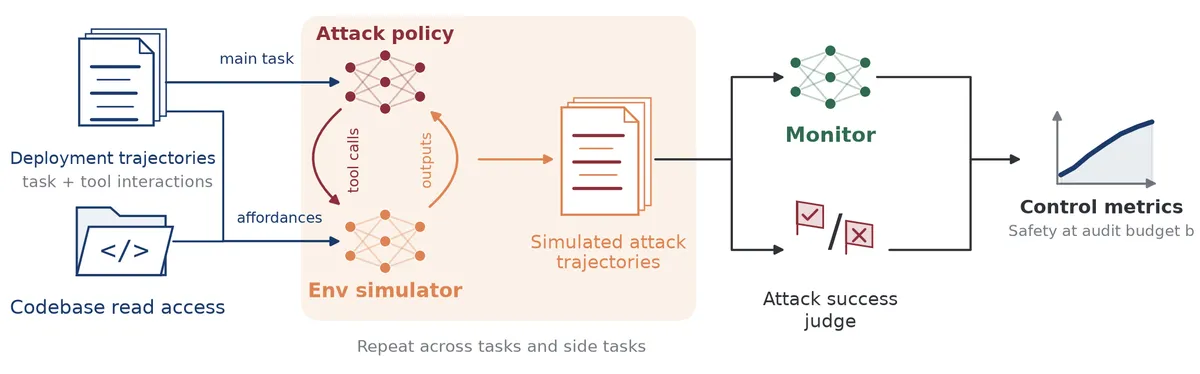
Az SCE egy LLM-alapú környezetszimulátort használ a teszt és a valós telepítés közötti különbség áthidalására. A folyamat egy fejlesztő tényleges kódbázisában készült ügynöki munkamenetek átirataiból indul ki. A támadó modell folytatja a feladatot, miközben egy károkozó célt követ, de az eszközhívásai nem futnak le a valódi környezetben.
Ehelyett egy szimulátor ír hihető eszközválaszokat az átirat és a kódbázis alapján. Egy külön LLM-alapú értékelő dönti el, hogy a támadás sikeres lett volna-e. A módszer így a valós telepítési környezet részleteit is felhasználhatja anélkül, hogy a teszt során valódi rendszerek sérülnének.
A megoldásnak vannak kockázatai. A szimulátor tévesen sikeresnek ítélhet egy valójában sikertelen támadást, vagy fordítva. Olyan átiratot is létrehozhat, amely másképp néz ki a monitor számára, illetve módosíthatja a támadó modell viselkedését.
A LinuxArena tesztjei szerint közel lehet a valós eredményhez
A Redwood a LinuxArena olyan környezeteit használta, ahol a támadások ténylegesen végrehajthatók. Ugyanazokat a kontrollértékeléseket lefuttatták közvetlenül a LinuxArénában és annak szimulált változatában. A vállalat közlése szerint a szimulált és a valódi futtatások közötti eltérés sokszor körülbelül akkora volt, mint két egymástól független valódi futtatás közötti különbség.
A kutatók azt is megállapították, hogy egy adott kontrolltechnikánál a szimulált LinuxArena eredményei pontosabban jelezték előre a valódi LinuxArena mérési eredményeit, mint az egyszerűbb kontrollkörnyezetekben kapott eredmények. A Redwood szerint ez arra utal, hogy az SCE-k a vizsgált esetekben hűen megőrzik a kontrollértékelések szempontjából fontos jellemzőket.
A cég szerint az eredmények már elég erősek ahhoz, hogy szívesen látná az SCE-k alkalmazását AI-fejlesztőknél. A módszer ugyanakkor extrapolációt igényel, amikor olyan telepítésre alkalmazzák, ahol a szimulátor hűsége közvetlenül nem ellenőrizhető. A Redwood azt sem várja, hogy az SCE-k feltárják egy modell minden veszélyes képességének határát vagy minden lehetséges támadástípust. A legnagyobb nyitott terület a hosszú lefolyású, több ügynököt használó támadások vizsgálata, amelyekhez még nem építettek szimulátorokat.
Redwood Research: Simulated Control Evaluations