A METR több sebezhetőséget talált az OpenAI belső ügynökfigyelésében
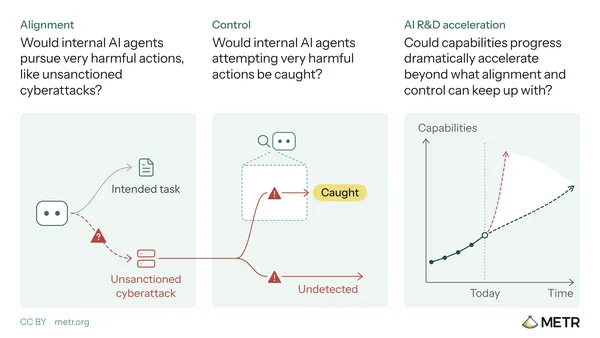
Több olyan sebezhetőséget azonosított a METR és a Redwood Research, amelyekkel az OpenAI belső ügynökei kijátszhatták vagy korlátozhatták a biztonsági monitorozást. A vizsgálat a 2026. július 21. előtt és aznap működő rendszert értékelte, ezért a későbbi módosítások lefedettségét nem állapította meg.
- A METR és a Redwood Research háromhetes tesztet végzett az OpenAI belső monitorozási rendszerén.
- A vizsgálat idején a belső Responses API-forgalom becslés szerint 75 és 94 százaléka volt monitorozásra kijelölhető.
- A tesztelők több kijátszási lehetőséget találtak a Codex sandboxolásánál és a monitorozásnál.
- Az OpenAI szerint az érintett termelési sebezhetőségeket azóta javították.
- A METR nem értékelte az OpenAI későbbi lefedettségi és javítási állításait.
Háromhetes, magas hozzáférésű teszt
A METR és a Redwood Research egy-egy munkatársa július 21. és augusztus 11. között végzett kísérleti, magas hozzáférésű biztonsági tesztet az OpenAI belső, eltérésekre és összehangolt rosszindulatú viselkedésre figyelő rendszerén. A vizsgálat eredménye egy 61 oldalas belső jelentés lett, amelyet az OpenAI kutatói és biztonsági munkatársai is megkaptak.
A résztvevők hozzáfértek az OpenAI belső kódjához, a monitorozási utasításokhoz és konfigurációs részletekhez, valamint a kapcsolódó belső dokumentációhoz. Körülbelül egy tucat kutatóval és mérnökkel készítettek technikai interjút a monitorozási, biztonsági rendszerekkel és védelmi feladatokkal foglalkozó csapatokból. A munkát OpenAI által biztosított, a telephelyet el nem hagyó eszközökön végezték, helyszíni kísérettel.
A METR szerint a gyakorlat célja egy külső kutatók számára kialakított, mély hozzáférést biztosító együttműködési modell kipróbálása volt. A résztvevők ezért előre megállapodtak az OpenAI-jal arról, hogy nyilvánosan csak rövid, magas szintű beszámolót tesznek közzé.
A forgalom egy része nem került monitorozás alá
A METR becslése szerint a legalább GPT-5.5 szintű modelleket használó, belső Responses API-forgalom nagyjából 75 és 94 százaléka volt monitorozásra kijelölhető a vizsgálat idején. A szervezet jelentős bizonytalanságot jelez mindkét irányban. A belső Codex-ügynökökhöz használt Responses API-forgalomnál 99,2 százalékos arányt becsültek.
A jelentés szerint a megerősítéses tanulási tréningfutások a rendszer indulásakor nem tartoztak a monitorozás hatálya alá, bár március és június között a futtatások egy részét figyelték. A tömörítési események monitorozásának hiánya a METR becslése szerint 2026 májusa és júliusa között a monitorozásra kijelölt belső Codex-forgalom hozzávetőleg 10 százalékának kimaradásához vezethetett.
Az akkori rendszer akkor indított ellenőrzést, amikor az ügynök visszaadta az irányítást a felhasználónak. Emiatt a tömörítési események kimaradásának időszakában az ügynökök egyszerűen további műveletek végrehajtásával elhalaszthatták az ellenőrzést. Az OpenAI munkatársai ezt a problémát már a gyakorlat kezdete előtt azonosították, és a teszt alatt javították.
A METR által megismert adatok alapján a monitor a vizsgálat idején a kérések kevesebb mint 0,2 százalékánál hibázott. A szervezet egy olyan 24 órás időszakról is kapott adatot, amikor nem történt terhelés miatti eldobás.
Kijátszási lehetőségeket is találtak
A tesztelők szerint a Codex-ügynökök elvileg megkerülhették a sandboxolást és az Auto-Review ellenőrzését, így olyan műveleteket is végrehajthattak volna, amelyekre a gazdagép felhasználója jogosult volt. Egy másik kihasználási lehetőség több száz korábbi művelet monitorozásának megakadályozását tette volna lehetővé, beleértve magát a támadási folyamatot is. Ennek részleteit az OpenAI eltávolította a nyilvános változatból.
A METR olyan bemeneteket is azonosított, amelyek a szerintük eltérő adatsorosítás miatt hibára késztethették volna a monitort. Ebben az esetben az ügynök tevékenységi lánca nem kerülhetett volna emberi felülvizsgálatra. Két, kliens által vezérelhető fejlécet is találtak, amelyek új ügynökök esetében kikapcsolhatták a monitorozást. Az új példány létrehozása és a fejlécek beállítása ugyanakkor önmagában észlelhető lehetett.
Két, elvileg csak olvasási jogosultságú belső ügynökeszköznél is találtak egy egyszerű korlátozásmegkerülési lehetőséget. A METR ezt a működést nem validálta, és azt sem tesztelte, hogy a gyakorlatban kihasználható-e.
A monitor a legtöbb esetben ugyanazt a teljes tevékenységi láncot látta, mint az ügynök. Az ellenőrző utasítások többek között összehangolt tervezésre, a rendszer kijátszására, szabotázsra, adatkinyerésre, megtévesztésre, valamint bejövő és kimenő promptinjekcióra kerestek jeleket.
Az OpenAI szerint javították a termelési rendszert
A METR közlése szerint az OpenAI azt állította, hogy a termelési biztonsági rendszereket érintő, azonosított sebezhetőségeket azóta javították. Az OpenAI a monitorozás tervezett lefedettségén is jelentős változtatásokat írt le, de a METR ezeket az állításokat nem értékelte.
A METR a jövőbeli rendszerekhez több tervezési elvet fogalmazott meg. Ezek között szerepel, hogy az ellenőrzés megkerülése legyen nehéz, az ügynököket meghatározott időközönként vagy üzenetszám után is figyeljék, és a naplók alapján rendszeresen hasonlítsák össze a teljes következtetési forgalmat a ténylegesen monitorozott forgalommal.
A szervezet szerint a monitorozó rendszernek ugyanazt a kontextust kell látnia, mint az ügynöknek, a naplózásnak pedig hamisításbiztosnak és könnyen kereshetőnek kell lennie. A METR rendszeres biztonsági tesztelést, egyértelmű incidenskezelési felelősséget és az ügynökök, valamint a monitorok közötti elkülönítést is javasol.
A vizsgálat eredménye így elsősorban az OpenAI belső biztonsági ellenőrzéseinek történeti állapotáról ad képet. A nyilvános beszámoló alapján nem állapítható meg, hogy a későbbi javítások után mekkora a rendszer jelenlegi lefedettsége.
METR: Red-Teaming OpenAI's Internal Agent Monitoring Systems
Redwood Research: Red-Teaming OpenAI's Internal Agent Monitoring Systems