Réteges KV-cache-kezelést kapott a vLLM
A vLLM réteges KV-cache-kiürítést vezetett be, amely a gyorsítótár korábban kiszorított adatait CPU-memóriában, tárhelyen vagy távoli gépeken őrzi meg. Így az adatokat újraszámítás helyett alacsonyabb szintről lehet visszatölteni, ami csökkentheti a számításigényt és a késleltetést.
- A vLLM a kiszorított KV-adatokat host memóriában és másodlagos tárolási szinteken őrzi meg.
- A rendszer fájlrendszert, S3-kompatibilis objektumtárolót és peer-to-peer átvitelt is támogat.
- Az akkcelerátormemória a hostra másolás után azonnal felszabadítható.
- A hostoldali, konfigurációfüggetlen formátum eltérő csomópontok közötti megosztást tesz lehetővé.
- A framework a vLLM 0.22-es verziója óta elérhető.
A GPU-memórián túl is megmaradhat a KV-cache
A hosszú kontextusú modellek és a többfordulós beszélgetések nagy KV-cache-eket hoznak létre. Amikor az akkcelerátor memóriája, például a GPU HBM-je megtelik, a korábban kiszámított KV-adatok eddig kiszorulhattak, a következő felhasználáskor pedig a vLLM-nek újra kellett számolnia őket.
Az új megoldás a kiszorított adatokat több tárolási szinten őrzi meg. Az elsődleges szint a host memória, vagyis a CPU DRAM-ja, amelyet fájlrendszer, objektumtároló vagy távoli gépek egészíthetnek ki. A vLLM 0.22-es verziója óta elérhető keretrendszerben az adat először mindig a host memóriába kerül, majd onnan továbbítható a másodlagos szintekre.
Visszatöltéskor a folyamat fordított. A másodlagos szint először a host memóriába küldi az adatot, onnan pedig az akkcelerátor memóriájába kerül. A rendszer azt a legelső szintet használja, amelyen megtalálja a keresett adatrészletet.
A host memória központi szerepe
A vLLM tervezési elve szerint minden KV-adat áthalad a host memórián. Az akkcelerátorról a hostra történő másolás helyi PCIe-átvitellel zajlik, ezért az akkcelerátor memóriája már ennek befejezésekor felszabadítható. A háttértárra írás, a hálózati küldés és a távoli RDMA-átvitel ezután a hostoldali másolatról folytatódik.
Visszatöltéskor az akkcelerátormemóriát csak akkor foglalja le a rendszer, amikor az adat már készen áll a hoston. Ez olyan működést tesz lehetővé, amelyben az akkcelerátormemória csak addig foglalt, amíg ténylegesen szükség van rá.
Több akkcelerátor használatakor, például tensor_parallel_size=8 beállításnál, minden eszköz a KV-cache egy részét tárolja. A vLLM ezeket a részeket egyetlen megosztott hostmemória-régióba egyesíti. A másodlagos tárolási szintek így kevesebb, nagyobb I/O-műveletet látnak, ami javíthatja a tárhely és a hálózat kihasználását.
A hostoldali adatformátum konfigurációfüggetlen. A forrás szerint ugyanaz a KV-adat azonos hostoldali részleteket eredményezhet TP=2 és TP=4 beállítású csomópontokon is, akkor is, ha eltérő akkcelerátortípusokat, figyelmi háttereket vagy párhuzamosítási konfigurációkat használnak.
Fájlrendszer, objektumtároló és peer-to-peer átvitel
A működés alapegysége egy chunk, vagyis a KV-adatok rögzített méretű része, amely tokenek egy csoportját fedi le. Alapesetben egy chunk egy akkcelerátorblokkhoz kapcsolódik, a blocks_per_chunk beállítással azonban nagyobb egységek is létrehozhatók.
A host memória valódi LRU vagy ARC gyorsítótárként működik, nem pusztán átmeneti pufferként. A gyakran használt részek közvetlenül innen szolgálhatók ki. Ha a hostkapacitás elfogy, a ritkábban használt elemek kiszorulnak, de azok megmaradhatnak valamelyik másodlagos szinten.
A fájlrendszeres megoldás minden KV-chunkot külön fájlként tárol helyi vagy hálózati tárhelyen. Tartalomazonosító elnevezést használ, így az azonos tokensorozatok automatikusan ugyanahhoz a gyorsítótárazott adathoz kapcsolódnak. Közös csatolási pont esetén több vLLM-példány további konfiguráció nélkül is megoszthatja az adatokat.
Az objektumtárolási réteg S3-kompatibilis tárolókat használ a NIXL-en keresztül. A forrás ezt hálózati, megosztott tárolási lehetőségként írja le, amely gigabájtonként jellemzően olcsóbb lehet a nagy teljesítményű fájltárolónál.
A peer-to-peer réteg vLLM-példányok közötti KV-cache-megosztást tesz lehetővé. A koordinációhoz ZMQ-t, a nagy mennyiségű adat átviteléhez NIXL-en keresztüli RDMA-t használ. Az átvitelek mindkét oldalon host és host között zajlanak, az akkcelerátormemória érintése nélkül.
Mit jelent ez a vLLM-et használó rendszereknek?
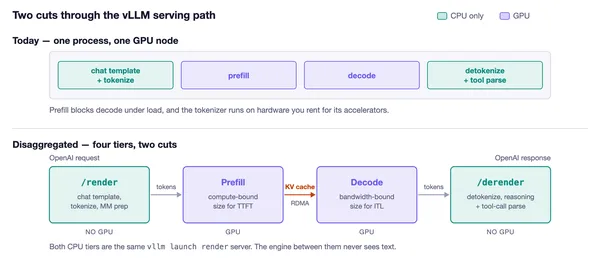
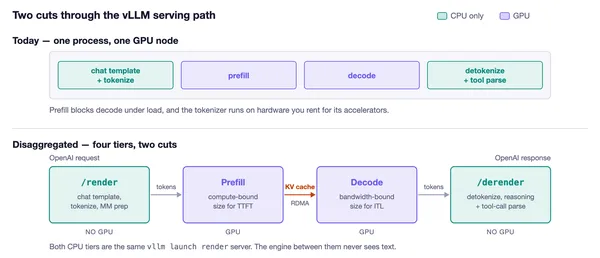
A peer-to-peer működés két kiemelt felhasználási területet támogat. Prefill és decode szétválasztásakor a prefill-példány kiszámítja a KV-chunkokat, a decode-példány pedig RDMA-n keresztül lekérheti őket a host memóriából. A vLLM szerint a több akkcelerátorról érkező kisebb átvitelek összevonása kevesebb, nagyobb RDMA-műveletet eredményezhet.
Terhelt példányról a KV-chunkok olyan vLLM-példányra is átvihetők, amely szabad kapacitással rendelkezik. A framework hibrid memóriaallokátorával a különböző rétegtípusokat kombináló modelleket is kezeli, köztük a teljes figyelmet, a csúszóablakos figyelmet, az MLA-t és a Mamba-állapotokat. A forrás szerint a támogatott architektúrák között szerepel a DeepSeek V4, a GLM 5.3 és a Nemotron 3.
A működés figyeléséhez a vLLM a szokásos /metrics végponton Prometheus-metrikákat tesz elérhetővé. Ezek között szerepel a host-cache kihasználtsága, az akkcelerátor és a host közötti átvitel teljesítménye, valamint az egyes rétegek lekérdezési és adatátviteli késleltetése.
vLLM: Tiered KV Cache Offloading in vLLM