A Sourcegraph kevesebb LLM-kontextussal gyorsítaná a kódmigrációkat
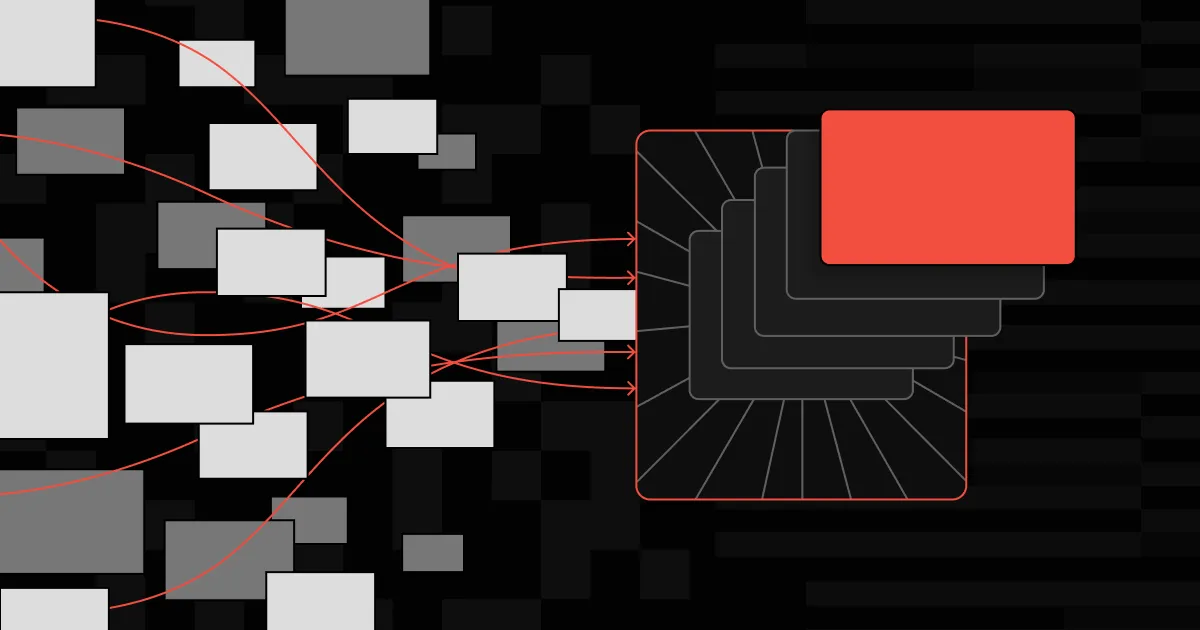
A Sourcegraph Deep Search a kódmigrációk és auditok köztes adatait sandboxban dolgozza fel, így az LLM-nek nem kell több ezer fájl tartalmát kezelnie. A rendszer összesített eredményeket és strukturált jelentéseket ad vissza, például CSV-fájlt.
- A Deep Search sandboxban futtat szkripteket a Sourcegraph keresési API-jai körül.
- A rendszer a köztes találatok helyett CSV-, JSON- vagy SVG-jelentést adhat az LLM-nek.
- Kódmigrációknál az érintett fájlokról CSV-ellenőrzőlistát készít.
- A Sourcegraph szerint a módszer csökkentheti a tokenköltséget és javíthatja a kontextus minőségét.
- A megoldás leltározási, kódminőségi és összevetési feladatokra is használható.
A modell helyett a sandbox dolgozza fel a keresést
A Sourcegraph augusztus 28-án ismertetett megoldása a nagy kódbázisok vizsgálatánál igyekszik csökkenteni az LLM-ek kontextusablakába kerülő adatmennyiséget. A vállalat szerint az AI használatának vállalati bővülésével a tokenköltségek egyre nagyobb figyelmet kapnak, különösen olyan feladatoknál, amelyek több ezer fájl átvizsgálását igénylik.
A hagyományos ügynöki munkafolyamatok gyakran közvetlenül a nyelvi modell kontextusába továbbítják a keresések során összegyűjtött adatokat. Ez a Sourcegraph szerint költségnövekedéshez és gyengébb teljesítményhez vezethet, mivel a modellnek a releváns információk mellett a feldolgozás köztes, rendezetlen részleteit is kezelnie kell.
A Deep Search ehelyett a Sourcegraph keresési API-jai körül futtat szkripteket egy elkülönített sandboxkörnyezetben. Több keresést indíthat, összevetheti az adatokat, kiszűrheti a találatokat, összesíthet, majd CSV-, JSON- vagy SVG-jelentést készíthet. A nyelvi modell így az összesített eredményeket és a végső jelentést kapja meg.
A kódmigrációhoz ellenőrzőlistát készít
A Sourcegraph elsődleges felhasználási példaként a migrációkat emeli ki. Ha egy csapat egy szolgáltatást a old/package útvonalról a new/package útvonalra helyezne át, a Deep Search végigvizsgálhatja a tárhelyeket, amelyek még a régi csomagot importálják.
A rendszer azonosítja az érintett fájlokat, majd tiszta CSV-ellenőrzőlistát készít. A csapat ezt a fájlt közvetlenül megnyithatja és felhasználhatja a migráció megkezdéséhez. A Sourcegraph leírása szerint a jelentés átfogó és pontos képet ad az érintett kódról, miközben a modellnek nem kell minden beolvasott fájl teljes tartalmát megkapnia.
A bemutatott másik példa a kubernetes/kubernetes kódtár pkg/ könyvtárának vizsgálata. A Deep Search megkeresi azokat a fájlokat, amelyekben a legtöbb TODO megjegyzés található, majd a fájlok tartalma helyett CSV-fájlt és SVG-diagramot ad vissza.
Költségcsökkentés és használhatóbb eredmények
A Sourcegraph szerint a sandboxba kiszervezett feldolgozás három előnnyel jár. A felhasználó a köztes feldolgozás minden elemének továbbítása helyett a magas szintű megállapításokért fizet, a modell figyelmét nem vonják el több ezer sor irreleváns fájladatai, és strukturált, azonnal felhasználható adat keletkezik.
A vállalat szerint a kisebb és célzottabb kontextus a válaszok minőségére is hatással lehet. A Deep Search feladata így a nyers adatok feldolgozása helyett az, hogy a modell a releváns eredményekből következtetéseket fogalmazzon meg. Ez növelheti a hasznosabb és pontosabb kimenetek valószínűségét.
A megközelítés a Sourcegraph szerint más, keresésre épülő jelentéskészítési feladatokra is alkalmazható. Ilyen lehet a megosztott szolgáltatások szervezeten belüli használatának leltározása, az elavult vagy sérülékeny függőségeket használó tárhelyek azonosítása, például a 2.17-nél régebbi Log4j-verziók esetében, illetve különböző megvalósítások összevetése az eltérések feltárásához.
A Sourcegraph úgy látja, hogy az AI vállalati elterjedésével a tokenhatékonyság fontos szemponttá válik a mérnöki vezetők számára. A Deep Search ezt architekturális megközelítéssel kezeli: a nagy mennyiségű keresési adatot a sandbox dolgozza fel, az LLM pedig a tömörített eredményeket és a kész artefaktumot kapja meg.
Sourcegraph: A smarter way to run code migrations with less LLM context