A vLLM Qwen3.5-teljesítménye elérte a 25 ezer tokent GPU-nként
A vLLM szerint a Qwen3.5 diszaggregált kiszolgálása több mint 25 ezer token/másodperc/GPU teljesítményt ért el GB200 NVL72 rendszeren. A fejlesztéshez a GDN számításának gyorsítása, a gyorsítótár-állapotok átvitele és az aszinkron ütemezés javítása is kellett.
- A vLLM több mint 25 000 tokent ért el másodpercenként GPU-nként.
- A mérést GB200 NVL72 rendszeren, Qwen3.5-397B-A17B-NVFP4 modellel végezték.
- A Blackwell GDN kernel a vizsgált esetekben 1,02 és 5,78 közötti gyorsulást hozott.
- A GSM8K pontossági eredménye mind az öt konfigurációban 88 százalék volt.
- A teljesítményhez az aszinkron ütemezés versenyhelyzeteit is javítani kellett.
A hibrid architektúra külön feladatokat adott
A Qwen3.5 2026 elején jelent meg, és a vLLM közlése szerint továbbra is a széles körben használt modellek közé tartozik az ügyfeleik körében. A modell hibrid architektúrája teljes figyelmi rétegeket és Gated Delta Network, röviden GDN rétegeket kombinál.
Ez két fontos optimalizálási feladatot jelentett. Gyorsítani kellett a GDN számítását a Blackwell GPU-kon, emellett helyesen kellett átvinni a különböző figyelmi és GDN-állapotokat a bemeneti feldolgozást végző, úgynevezett prefill, valamint a dekódolást végző dolgozók között.
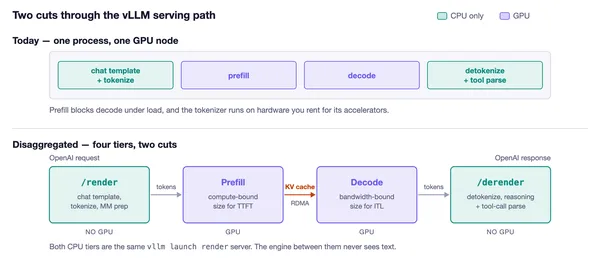
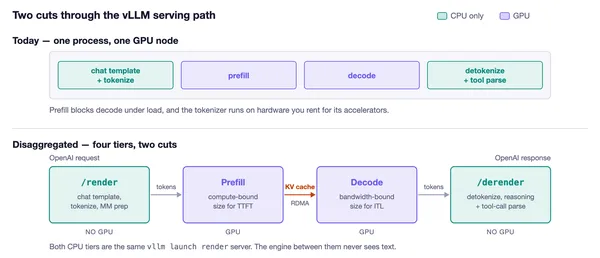
A vLLM közösségének hozzájárulásai nyomán a projekt szerint a Qwen3.5 diszaggregált kiszolgálási útvonala éretté vált. A fejlesztések a prefill és a decode feladatokat külön erőforrásokon kezelő működéshez kapcsolódnak.
Blackwellre optimalizált GDN és javított állapotátvitel
A FlashInfer új Blackwell GDN prefill kernelje a korábbi FLA/Triton megoldáshoz képest körülbelül 1,02-szeres és 5,78-szoros közötti gyorsulást hozott a vizsgált modellméreteknél, tenzorpárhuzamosítási beállításoknál, sorozathosszoknál és kötegméreteknél.
Egy 8 GPU-s B200 rendszeren, Qwen3.5-397B-A17B-NVFP4 modellel a vLLM integráció a mikromérésekben legfeljebb 5,92-szeres GDN-kernel-teljesítményt, csak prefillből álló terhelésnél pedig 1,13-szoros áteresztőképességet ért el. Ugyanebben a terhelésben, 8192 bemeneti és 1 kimeneti token mellett az átlagos első tokenig eltelt idő 12 százalékkal csökkent.
A hibrid gyorsítótár és az SSM-állapot átvitele szintén több fejlesztést igényelt. A vLLM szerint az egyik módosítás 4284-ről 1650-re csökkentette az átvitt leírók számát, és egy kisebb, gépen belüli H100-as tesztben körülbelül 7 százalékkal javította az áteresztőképességet. A későbbi módosítások a teljes figyelmi KV-gyorsítótár és a Mamba-alapú SSM-állapot együttes továbbítását, valamint a Qwen3.5 GDN-rétegeinek támogatását célozták.
GB200 NVL72 rendszeren mérték a 25 ezres értéket
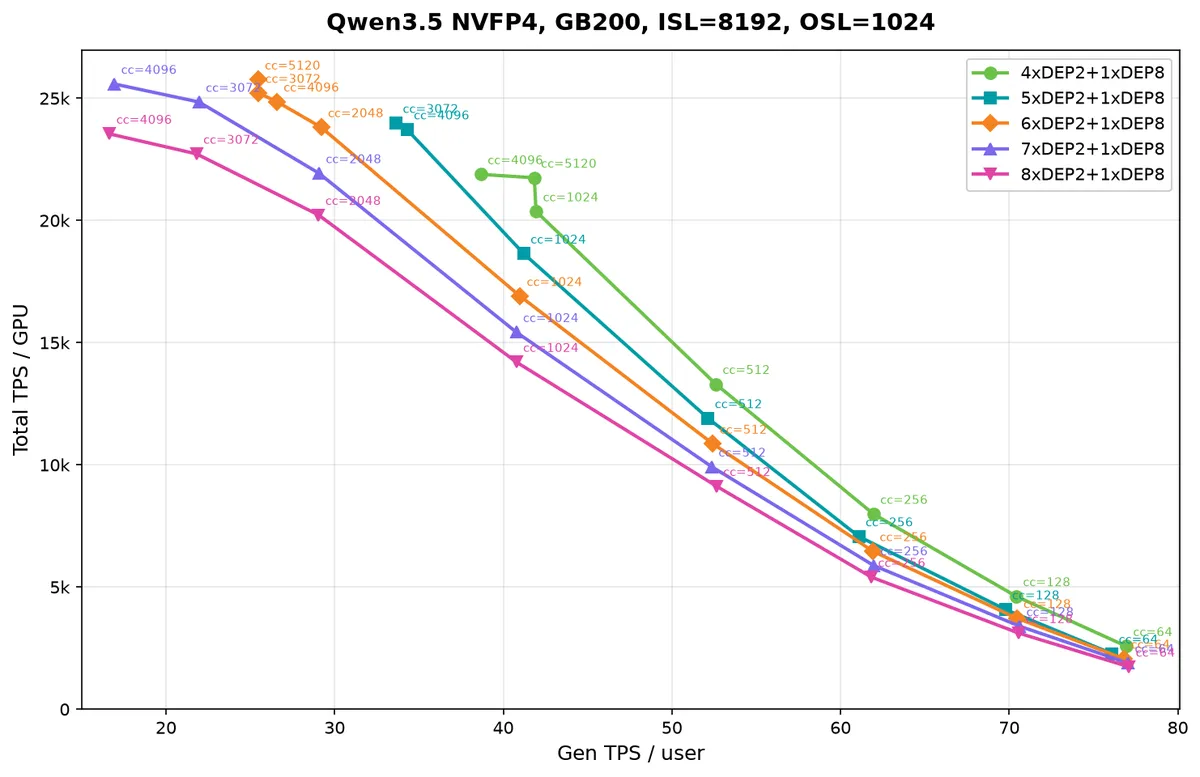
A teljesítményméréseket NVLink72-vel összekapcsolt GB200-fürtön végezték, 8192 bemeneti és 1024 kimeneti tokenes beállítással. A tesztelt modell a Qwen3.5-397B-A17B-NVFP4 volt. A dekódolási oldalon egyetlen, nyolc GPU-s GB200 végpontot használtak DEP8 topológiával, a prefill oldalon pedig négy és nyolc közötti számú végpontot, mindegyiken rögzített DEP2 topológiával.
A vLLM közlése szerint az összesített teljesítmény elérte a 25 000 tokent másodpercenként GPU-nként. A párhuzamosságot 64 és 5120 között vizsgálták. Az 1 és 32 közötti alacsony értékeket nem mérték, mert a vizsgálat a teljesítménygörbe azon részére összpontosított, ahol maximalizálható az egy GPU-ra jutó tokensebesség. 5120 fölé azért nem mentek, mert a dekódolási oldalon fogyni kezdett a KV-gyorsítótár kapacitása.
A tesztek pontosságát a GSM8K benchmarkkal ellenőrizték. Mind az öt konfiguráció 88 százalékos eredményt ért el, ami megegyezett az összesített Qwen3.5-futtatásnál megfigyelt pontossággal.
A receptúrák reprodukálhatóvá teszik a beállítást
A vLLM a méréshez használt receptúrákat az srt-slurm-recipes tárolóban tette elérhetővé. A beállítások egyetlen paranccsal indíthatók, a konfigurációk pedig négy és nyolc közötti DEP2 prefill végpontot kapcsolnak egy DEP8 dekódolási végponthoz.
Az eredményhez kulcsszerepet kapott az aszinkron ütemezés. Két versenyhelyzetet javítottak, amelyek korábban használhatatlanná tették ezt a módot, és bekapcsolásakor a pontosság nullára esett. A receptúrák emellett a konvolúciós állapotok speciális elrendezését, bfloat16 formátumú Mamba SSM-gyorsítótárat és a csak nyelvi modellként történő futtatást használják.
A vLLM szerint a nagyobb párhuzamosság elvileg tovább növelhető, ehhez azonban a dekódolási oldalon további GPU-kra lenne szükség. A közzétett eredmény így elsősorban konkrét, reprodukálható hardveres és szoftveres konfigurációhoz kötött mérési adat, amely megmutatja, milyen fejlesztések kellettek a Qwen3.5 nagy áteresztőképességű kiszolgálásához.
vLLM: vLLM Reaches 25K Total TPS/GPU on Qwen3.5