A Warp saját kódolási feladataidon méri le, melyik modell működik a legjobban
A Warp korai hozzáférésben elindította a Benchmarks funkciót, amely a felhasználók saját kódolási feladatain hasonlítja össze a modelleket és az ügynökkonfigurációkat. A vállalat szerint a belső tesztelésük bizonyos feladattípusoknál 63 százalékkal csökkentette a költségeket a minőség romlása nélkül.
- A Benchmarks saját kódolási feladatokon hasonlítja össze a modelleket és konfigurációkat.
- A rendszer költség, minőség, helyesség és más szempontok alapján értékel.
- A Warp szerint a WarpBench 63 százalékkal csökkentette az egy pull requestre jutó belső költséget.
- A tesztek eredményei alapján modellrouterek irányíthatják a feladatokat.
- A funkció a Warp Factories korai hozzáférési programjában érhető el.
Saját feladatokra épülő modellteszt
A Warp szeptember 3-án mutatta be a Benchmarks funkciót a Warp Factories korai hozzáférésű változatában. A megoldás a nyilvános tesztekkel, például a SWE-bench és a Terminal Bench rendszerével rokon, de a mérés alapját a csapat saját kódolási feladatai és környezete adja.
A Benchmarks célja, hogy a fejlesztőcsapatok ne feltételezések alapján válasszák ki a modellt vagy az ügynök konfigurációját. A rendszerrel különböző modellek, munkafolyamatok és értékelési szempontok hasonlíthatók össze. A Warp szerint a funkció a frontier és a nyílt súlyú modellekkel is működik, a jövőben pedig olyan különböző harness-ek, vagyis futtatási keretrendszerek tesztelését is támogatja, mint a Warp, a Claude Code és a Codex.
Feladatok, konfigurációk és értékelők
Egy benchmark három fő elemből áll. Az első a feladatkészlet, amely származhat a csapat korábbi futásaiból, vagy létrehozható újonnan. A második a tesztelendő gyári konfigurációk halmaza, ahol a modell, a harness és más beállítások változtathatók. A harmadik az értékelők, vagyis a Scorers rendszere, amely olyan dimenziók alapján vizsgálja a teljesítményt, mint a költség, a minőség, a helyesség, a hatékonyság és a terjengősség.
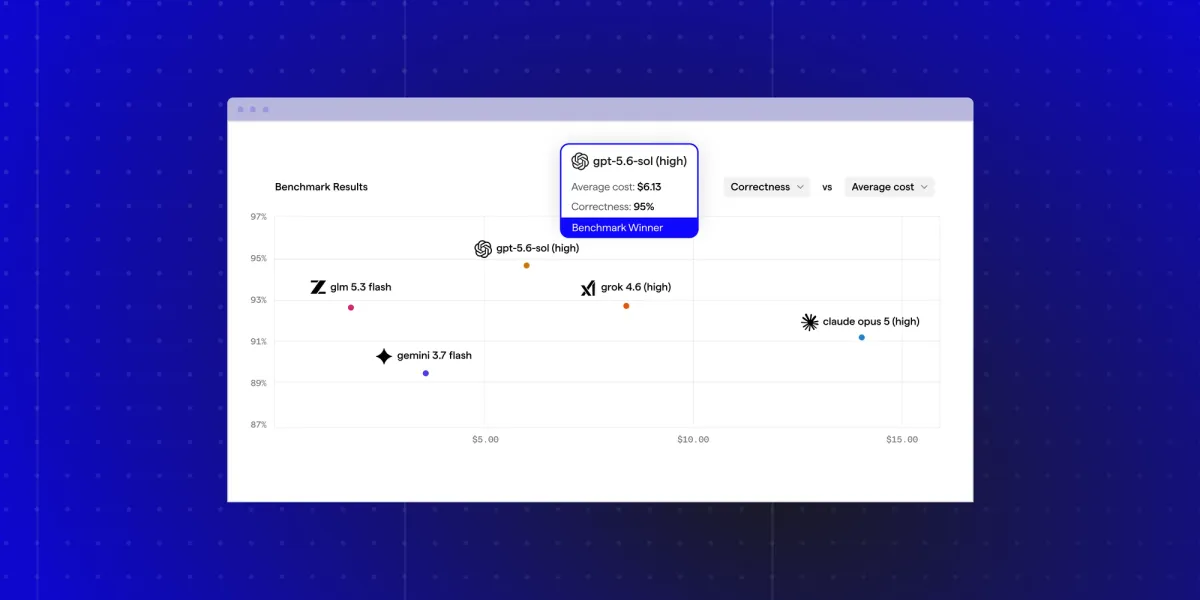
A Warp Factories a feladatok és a konfigurációk minden kombinációját lefuttatja, majd az eredményeket vizualizációkkal és pareto-grafikonokkal mutatja be. Így külön is látható, melyik konfiguráció teljesít a legjobban a költség, a minőség vagy az összesített eredmény szempontjából. A feladatok többszöri futtatása csökkenti az eredmények szórását, ugyanakkor növeli a költséget.
A benchmarkok kódalapúak. A gyári állapotot a factory.yaml fájl és a hozzá tartozó ügynökdefiníciók rögzítik, ez pedig lehetővé teszi a különböző konfigurációk A/B tesztelését. A rendszer minden futás ügynöknyomait és metaadatait tárolja. A vállalati ügyfelek ezeket a saját biztonsági határukon belül is tárolhatják. A Warp szerint a rögzített adatok között szerepelhet a prompt, a teljes beszélgetés, a futás előtti és utáni Git-állapot, a pull request és más létrehozott fájlok.
A Warp szerint 63 százalékkal csökkent a belső költség
A Warp a saját WarpBench nevű, általános célú belső benchmarkját használta a konfigurációk összevetésére. A vállalat által bemutatott futásban a GPT 5.6 Sol (high) lett a legjobb modell. A Warp szerint a WarpBench segítségével az elmúlt néhány hétben körülbelül 63 százalékkal csökkentették az egy pull requestre jutó belső költséget.
A cég egy másik példában egyszerű frontendmódosításokat vizsgál a szerver kódbázisában. Ebben a tesztben a Grok 4.6 (med), a GLM 5.3 flash és a Claude Opus 5 (med) konfigurációit hasonlítják össze a Warp harness használatával. A Warp Factories a harness cseréjét is lehetővé teszi, így például a Claude Code és a Codex teljesítménye is vizsgálható.
A benchmark elkészítésében a Warp úgynevezett foreman ügynöke is segíthet. Ez a korábbi futásokból képes tesztfeladatokat kiválasztani, például meghatározott méretű felhasználói felületet érintő módosításokat. A korábbi futások a kezelőfelületen egyenként is hozzáadhatók a benchmarkhoz.
Az eredményekből automatikus modellválasztás lehet
A teszt eredménye nem áll meg a modellek rangsorolásánál. A Warp Factories egyedi modellroutereket is támogat, amelyek osztályozási szabályok alapján választják ki az adott feladathoz tartozó modellkonfigurációt. A Warp példájában a rendszer az egyszerű, szerveroldali frontendfeladatokat a Grok 4.6 (med) konfigurációjához irányítja, mert ez teljesített a legjobban az adott belső benchmarkon.
A Warp hangsúlyozza, hogy a benchmarkok futtatása költséges, ezért nem automatikus, folyamatos használatra javasolja őket. A vállalat szerint elsősorban új modellek megjelenésekor, illetve promptok, készségek vagy más ügynökkontextusok módosításakor lehet hasznos újramérni a konfigurációkat. A Benchmarks és az önfejlesztési ciklusok együtt a Warp értelmezésében a kódolóügynök-rendszerek költség és termelékenység szerinti mérnöki optimalizálását segítik.
A funkciót a Warp Factories korai hozzáférési programjában lehet kipróbálni. A Warp képzett csapatoknak 10 ezer dollár értékű factory-használatot kínál, a csatlakozás pedig jelentkezéshez kötött.
Warp: Introducing Factory Benchmarks