A Zephon GPU-számváltás után is azonos adatsorrendet ígér
A PyTorch bemutatta a Zephon nevű adatbetöltési megoldást, amelynek célja, hogy a TorchTitan modelltréningje eltérő számú GPU használatakor is ugyanazokat a globális batch-eket kapja. A rendszer a tokenizálást, csomagolást, keverést és előkészítést menet közben végzi el.
- A Zephon eltérő GPU-szám mellett is azonos globális batch-eket céloz.
- A standard adatbetöltésnél a DCLM Core v1 pontszáma legfeljebb 0,82 ponttal tért el.
- A Zephon menet közben tokenizálja, csomagolja és keveri az adatokat.
- A rendszer logikai lane-ekre osztja az adatfolyamot, nem közvetlenül a GPU-k között.
- A PyTorch szerint Zephon egy látás és nyelv pipeline-ban tartotta a lépést a Google Grainnel.
A GPU-k száma a modell eredményét is befolyásolhatja
A PyTorch 2026. október 16-án ismertetett példája szerint a hagyományos adatbetöltők eltérő sorrendben adhatják át a mintákat a modellnek, ha a tréninget más számú GPU-n folytatják. Ennek oka, hogy a GPU-k száma megváltoztatja az adatok sorrendjét, így a modell más mintasorozaton tanul tovább.
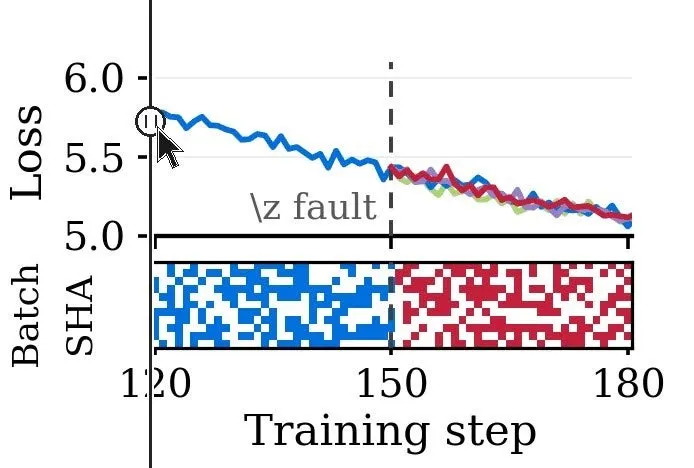
A bemutatóban egy 1 milliárd paraméteres modellt először 16 GPU-n tanítottak, majd a 150. lépésnél készült ellenőrzési pontból 8, 32 és 64 GPU-n folytatták a futtatást. A standard adatbetöltővel mindegyik folytatás eltérő veszteséggörbét produkált. Zephon használatakor a görbék egymásra kerültek, és minden globális batch SHA-256-hash-e megegyezett az eredeti futtatáséval.
A különbség az értékelési eredményekben is látszott
A PyTorch egy másik kísérletben ugyanazt az 1 milliárd paraméteres modellt 20 milliárd tokenen tanította 8, 16, 32 és 64 GPU használatával. Standard adatbetöltés mellett a DCLM Core v1 pontszáma legfeljebb 0,82 ponttal, a FineWeb értékelési készletével mért eredmény pedig legfeljebb 0,64 ponttal tért el a GPU-k számától függően.
Ez a forrás szerint körülbelül négyszerese annak a vonatkozó küszöbnek, amelyet a DCLM és a FineWeb szerzői az adatok összeállítási módszereinek vizsgálatakor használtak. Emiatt egy két különböző adatkeveréket összehasonlító kísérlet könnyen a GPU-k számának hatását mérheti az adatok helyett. Zephonnal a különbség 0,05, illetve 0,011 pont volt.
Menet közbeni előkészítés és rugalmas determinisztikusság
Zephon nem igényel előre feldolgozott másolatot a teljes korpuszról. A tréning közben tokenizálja, csomagolja, keveri és összekeveri az adatokat, miközben a modell mellett rendelkezésre álló CPU-kat használja. A rendszer három elemet kér a felhasználótól: a betanításhoz használt adatkészleteket, a keverést és sorrendet meghatározó WorkSource-t, valamint a tárolt mintákat a tréninghez szükséges tenzorokká alakító Pipeline-t.
A mintakódban két, Hugging Face-ről elérhető szöveges adatkészletet kevernek, majd GPT-2-tokenizálást, 2048-as maximális hosszúságú csomagolást, keverést és batch-elést végeznek. A tokenarány pontos beállítását a TokenEstimation segédprogram támogatja, amely a minták token- és bájtaránya alapján tervezi meg a keverést.
A Zephon működésének egyik alapja, hogy az egyes operátorok döntéshozó, sorrendet követő akkumulátorra és párhuzamosan futó, állapot nélküli munkafolyamatokra válnak szét. A rendszer a feldolgozási eredményeket sorszámozza, majd a megfelelő sorrendbe rendezi vissza. Az adatokat emellett előre meghatározott logikai adatfolyamokra, úgynevezett lane-ekre osztja. Ezeket a lane-eket a GPU-k számának változásakor újra lehet osztani, miközben a globális batch-ek változatlanok maradnak.
A PyTorch szerint a megoldás egy teljes, képeket dekódoló, tokenizáló, csomagoló és batch-előállító látás és nyelv pipeline esetében tartotta a lépést a tesztelt leggyorsabb betöltővel, a Google Grainnel, miközben erősebb rugalmas determinisztikussági garanciákat kínált.