A TorchTitan új modelleket, TitanRL-t és nagyobb skálázási teljesítményt kapott
A PyTorch jelentős frissítést mutatott be a TorchTitan generatív AI-modellek elő- és utótréningjére szolgáló platformjához. Az újdonságok között új nyílt súlyú modellek támogatása, a TitanRL megerősítéses tanulási rendszer, valamint skálázási és kommunikációs fejlesztések szerepelnek.
- A TorchTitan új támogatást kapott többek között a Qwen3.5, a Kimi K3 és a DeepSeek-V4 modellekhez.
- A TitanRL ugyanazt a modellt használja a pretraining, a post-training és a vLLM-alapú folyamatokban.
- A batch-invariant mód támogatott esetekben bitre azonos logaritmikus valószínűségeket biztosít.
- A DeepSeek V3 671B mérésében 512 GPU-n 2 694 493 globális TPS-t értek el.
- A FlexSharddal a Muon optimalizáló ideje akár 79 százalékkal javult a megadott mérésben.
Új modellek és rugalmas konfiguráció
A PyTorch október 21-i bejelentése szerint a TorchTitan az elmúlt évben úgy kapott új képességeket, hogy közben megőrizte minimalista, bővíthető felépítését. A platformot gyors kísérletezésre, valamint generatív AI-modellek nagy léptékű elő- és utótréningjére tervezték.
A TorchTitan PyTorch-natív támogatást kapott a Muse Spark Open, a Muse Glimmer, a Qwen3-VL, a Qwen3.5, a Kimi K2.7, a Kimi K3 és a DeepSeek-V4 modellekhez. A teljes tréningstack-integrációk a platform ötdimenziós párhuzamosítási rétegét is támogatják.
Az új, típusos Python-receptekre épülő konfigurációs rendszerrel a fejlesztők külön modellváltozatok fenntartása nélkül módosíthatják a párhuzamosítási stratégiákat, a modellkomponenseket és a hardverspecifikus kerneleket. A rendszer kompatibilis a torch.compile használatával, és integrálja az Attention Gym optimalizált kerneleit, köztük a Gated DeltaNetet, a Kimi Delta Attentiont és a ritkított figyelmi kerneleket. Emellett választható Helion-kernelek, például összevont RoPE is használható.
A TitanRL ugyanazt a modellt használja a teljes folyamatban
A TorchTitan része lett a TitanRL, amely megerősítéses tanulást tesz lehetővé. A PyTorch szerint több RL-rendszer külön tréning- és következtetési implementációt használ, ami megnehezíti annak megállapítását, hogy egy eltérő eredményt a jutalmazás, az algoritmus vagy a két modellpéldány közötti különbség okoz-e.
A TitanRL a pretraining, a post-training és a vLLM-en belüli használat során ugyanarra a modellre épít, így a munka egyetlen kódbázisban végezhető. Az ügynökalapú RL-feladatokhoz az úgynevezett rollout folyamatok aszinkron módon futnak, miközben a tréning és a generálás többféle párhuzamosítási módszerrel skálázható.
A TorchTitan csapata a rendszert többek között kevert szakértői és sűrű modelleken, hosszú kontextust, kódvégrehajtást, tömörítést, harness-feladatokat és önjátékot igénylő munkaterheléseken tesztelte. A bemutatott példák egyike a Qwen3.5-35B-A3B base modell 64K kontextussal, 40 GB300 GPU-n, egy másik pedig ugyanez a modell 128K kontextussal, 20 GB300 GPU-n.
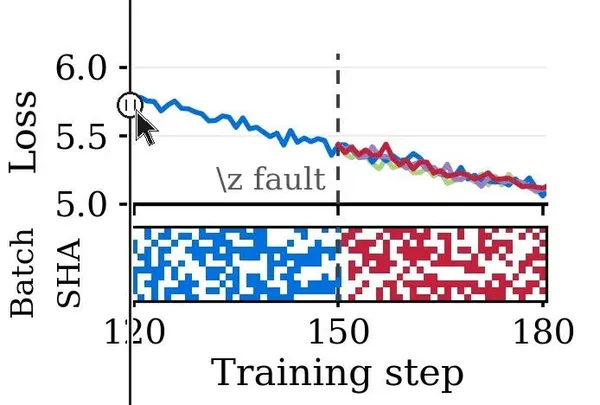
A batch-invariant mód a támogatott on-policy konfigurációkban bitre azonos logaritmikus valószínűségeket biztosít a tréner és a generátor között. A PyTorch közlése szerint így a különbség minden lépésben pontosan nulla lehet, ami megkönnyíti az algoritmusok és a numerikus eltérések vizsgálatát.
Nagyobb teljesítmény, kommunikációs és memóriakezelési fejlesztések
A TorchTitan teljesítményjavításai három területre koncentrálnak: gyorsabb kernelekre, a kommunikáció és a számítás átfedésének növelésére, valamint a memória finomabb szabályozására. A local_compile a natív torch.compile előnyeit kínálja anélkül, hogy teljes gráf vagy teljes blokk nyomkövetését kellene használni.
A torch_remat korszerű aktiváció-ellenőrzőpontozási felületet ad, a Dist-MoE pedig NVIDIA SM100 vagy újabb GPU-khoz készült, összevont kommunikációs és számítási kerneleket biztosít. A megújított pipeline-parallel csomag CUDA-gráfokkal kompatibilis, determinisztikus végrehajtást kínál, és vezérlőket ad az FSDP és a pipeline parallelism együtt használatához.
A PyTorch belső GB300 klaszterén a DeepSeek V3 671B és az MTP1 modul teljesítményét is mérték az MLPerf Training benchmarkon, MXFP8 kvantálással. 512 GPU-n, PP2-512 beállításban a globális teljesítmény 2 694 493 TPS, a GPU-nkénti teljesítmény 5 262,68 TPS, a GPU-nkénti számítási teljesítmény pedig 1 535,93 TFLOPS volt. A csúcsmemória-használat ebben a mérésben 224,65 GiB.
A MuseSpark 1.2 nyílt forrású kiadásánál 512 GPU-val és 192K kontextussal, kényszerített kiegyensúlyozott routing mellett 813 168 globális TPS-t, 929,33 GPU-nkénti TFLOPS-t és 37,17 százalékos MFU-t mértek.
Ökoszisztéma és FlexShard
A TorchTitan több kapcsolódó projektben is megjelent. Integrálták a veRL tréning-backendjeként és a Miles rendszerébe, a Meshy alapértelmezett tréning-backendje lett, valamint hatással volt az Areal tréningmotorjának magimplementációjára.
A platform emellett a FlexShard adatpárhuzamosítási könyvtárral is bővült. Ez lehetővé teszi, hogy az egyes paramétercsoportok testreszabott elhelyezési szabályok szerint legyenek felosztva, miközben a kommunikáció átfedhető a számítással. Az új elhelyezések között szerepel az Owned, ahol egy teljes paramétert egyetlen rang birtokol, valamint a BlockShard, amely kétdimenziós, csempékre igazított felosztást kínál.
A PyTorch szerint a FlexSharddal a DeepSeekV3 256 H100 GPU-n futó mérésében a Muon optimalizáló ideje az egyenértékű, kizárólag FSDP-re épülő implementációhoz képest akár 79 százalékkal javult. A könyvtár blokkosan kvantált paraméterek összegyűjtését is támogatja, ami a közlés szerint körülbelül 50 százalékkal csökkentheti a kommunikációs mennyiséget.
A frissítés a fejlesztők számára egységesebb, PyTorch-natív környezetet kínál az új modellek kipróbálásához, a nagy méretű tréningekhez és az RL-kísérletekhez. A bejelentés alapján a hangsúly a kis léptékű kezdés és a fokozatos skálázás lehetőségén, valamint a konfigurációk és a teljesítményproblémák könnyebb ellenőrzésén van.