Az Arize AI Harborral teszi mérhetővé az AI-ügynökök működését
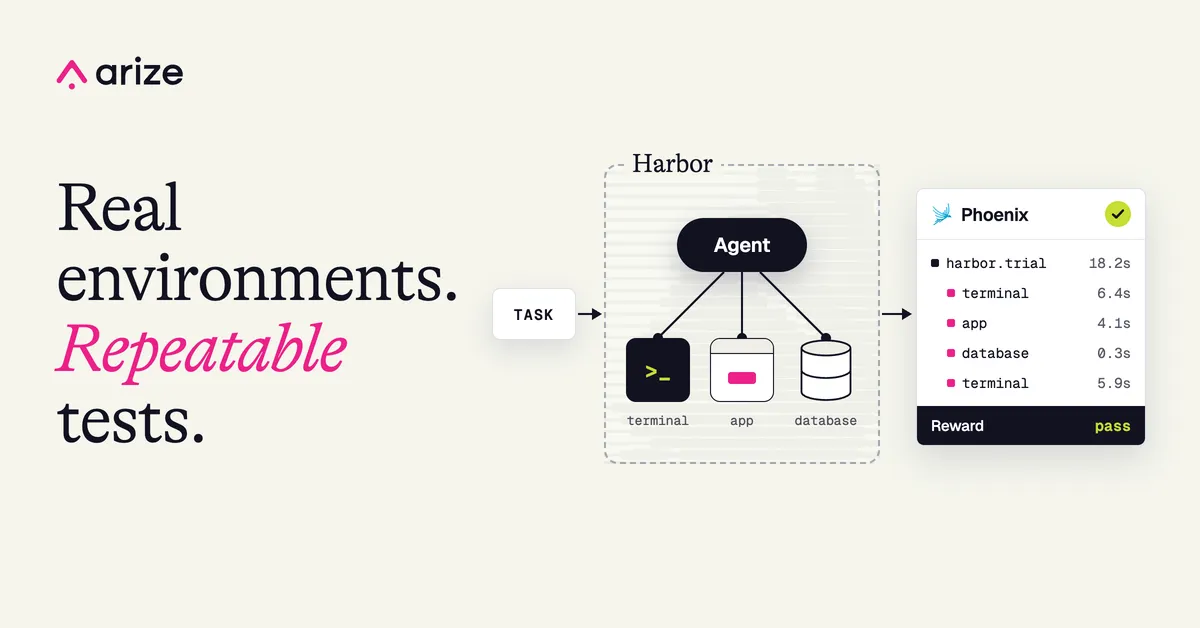
Az Arize AI a Harbor nyílt forráskódú keretrendszerrel és az Arize Phoenix platformmal alakított ki reprodukálható módszert az AI-ügynökök, MCP-szerverek, készségek és parancssori eszközök tesztelésére. A rendszer ugyanazokat a feladatokat, környezeteket és ellenőrzőket használhatja különböző ügynökök összehasonlításához.
- A Harbor minden ügynökpróbát friss, elkülönített homokozóban futtat.
- Ugyanazok a feladatok több ügynök, MCP-szerver és CLI összehasonlítására használhatók.
- A Phoenix a feladatokat adatkészletként, a futtatásokat kísérletként és nyomkövetésként rögzíti.
- A verifikátorok a helyességet, a fordulók és eszközhívások számát, valamint a végrehajtási hibákat is jelölhetik.
- Az Arize AI 2026. október 8-án élőben mutatja be a PXI-benchmarkot.
A reprodukálhatóság az ügynökök tesztelésének kulcsa
Az Arize AI szerint az AI-ügynökök fejlesztésének egyik legnehezebb része az élesítés előtti, offline értékelés. Egy megbízható összehasonlításhoz minden verziónak ugyanazokat a feladatokat, adatokat, eszközöket és környezetet kell használnia, a futtatások között pedig vissza kell állítani az állapotot.
A vállalat ezt a problémát a Phoenixbe épített PXI kódolóügynök vizsgálatakor tapasztalta. A kezdeti tesztek egyetlen fordulóban ellenőrizték az eszközhívásokat, de nem tartalmaztak minden olyan környezeti információt, amelyet a felület biztosított, például az aktuális oldalt és időt. Egyes eszközök csak a felületen keresztül tudtak működni, az MCP-szerver hozzáadása pedig további utánzandó elemet jelentett. Valódi Phoenix-adatbázis nélkül azt lehetett ellenőrizni, hogy az ügynök meghívott-e egy eszközt, azt viszont alig, hogy mit kezdett az eredménnyel.
A Harbor minden próbálkozást külön homokozóban futtat
A Harbor nyílt forráskódú keretrendszer olyan kódolóügynök-benchmarkok mögött áll, mint a Terminal-Bench. A működéséhez egy feladatot, az alkalmazást és az adatokat tartalmazó környezetet, valamint a sikerességet ellenőrző verifikátort kell megadni. A Harbor minden próbálkozást friss, elkülönített homokozóban futtat, helyi Docker-környezetben vagy a támogatott felhős szolgáltatók egyikén.
A futtatás végén a verifikátor teszteket indít, és jutalmat állít elő. A PXI esetében az Arize AI a valódi ügynökvégpontot egy előre feltöltött nyomkövetéseket tartalmazó Phoenix-szerverrel futtatta. Így az ügynök valós eszközeredményekkel dolgozott, a fejlesztők pedig utólag megvizsgálhatták az adatbázis állapotát.
A Harbor támogatja a Claude Code és a Codex kódolóügynököket, valamint az egyedi ügynököket is. Ugyanazokkal a feladatokkal tesztelhető a PXI, az Arize MCP-szervere és a Phoenix CLI. Ha például egy ügynöknek hibás nyomkövetéseket kell megjegyzésekkel ellátnia, a verifikátor ellenőrizheti, hogy a megfelelő adatbázisrekordok módosultak-e.
A Phoenix az eredményeket kísérletekké és nyomkövetésekké alakítja
A Phoenixhez készült bővítmény a Harbor feladatait verziózott adatkészletekként, az egyes ügynökkonfigurációkat kísérletekként, a verifikátorok jutalmait pedig Phoenix-megjegyzésekként rögzíti. A Harbor által felvett munkafolyamatból Phoenix-nyomkövetés is készül, amelyben megvizsgálhatók a modellhívások, az eszközhasználat és a rendelkezésre álló használati adatok.
A felület egy helyen mutatja a feladatot, az opcionális referencia-választ és az ügynök végső válaszát, továbbá a helyességre, a fordulókra és az eszközhívásokra vonatkozó jelöléseket. Minden verifikátori jutalom megjelenik Phoenix-megjegyzésként, az infra_ok jelölés pedig a végrehajtási hibákat jelzi.
Ha változnak a feladatok, a bővítmény új adatkészlet-verziót hoz létre, miközben a korábbi kísérletek az eredeti verzióhoz kötve maradnak. Ez segíthet elkülöníteni az ügynök fejlődését attól, amikor maga a teszt változott. Az eredmények a Phoenix MCP-szerverén és CLI-ján keresztül is elérhetők.
A sikeres válasz mögötti munkafolyamat is számít
Az Arize AI a PXI-t, a Claude Code-ot és a Codexet ugyanazokkal, egy Phoenix-projektre vonatkozó kérdésekkel tesztelte. A válaszok szinte mind helyesek voltak, a nyomkövetések azonban különbségeket mutattak az ügynökök munkamódszerében.
Egy esetben a Codex helyesen azonosított egy hibás eszközt, de a vállalat hibaanalízishez készült készsége miatt a kérdéshez képest túl hosszú folyamatot követett. A nyomkövetés megmutatta, hogy az ügynöknek különbséget kell tennie a gyors diagnózis és a teljes körű vizsgálat között. Az Arize AI szerint a módosítások ezután ugyanazokon a feladatokon tesztelhetők, és ellenőrizhető, hogy csökkentik-e a fordulók és az eszközhívások számát a helyesség romlása nélkül.
A vállalat javasolt kiindulópontja egy, a felhasználók számára fontos feladat, reális környezet és egy eredményellenőrző. A fejlesztők lefuttathatják az alapállapotot, megvizsgálhatják a nyomkövetést, módosíthatnak egy utasítást, készséget vagy eszközt, majd ugyanazt a feladatot újraindíthatják. Az Arize AI szerint erre a visszacsatolási körre olyan optimalizálók is építhetők, mint a GEPA.
A beállítást és a PXI-benchmarkot 2026. október 8-án élő bemutatón ismertetik a „Benchmarking AI agents & tool use with Harbor and Arize Phoenix” eseményen. A felhasználók számára a megközelítés azt jelenti, hogy az ügynökök helyessége mellett a munkafolyamat hossza, az eszközhasználat és a végrehajtási hibák is vizsgálhatóvá válhatnak.