Az AWS szerint gyorsíthatja a vLLM válaszidejét az új KV-átvitel
Az AWS push alapú kulcsérték-átviteli megoldást mutatott be a vLLM-hez, amely a vállalat mérése szerint akár háromszoros javulást hozott az első tokenig eltelt időben. A módszer a prefilling és a dekódolás közötti adatátvitelt részben leveszi a válaszgenerálás kritikus útjáról.
- Az AWS push alapú NIXL-kapcsolót mutatott be a vLLM-hez.
- A megoldás a KV-átvitel előkészítését a prefill oldalára és háttérszálra helyezi.
- A vállalat mérése szerint a TTFT akár háromszorosára javult.
- A Qwen3-32B modellnél a TPOT javulása akár 30 százalék volt.
- A push mód korábban választja ki a decode példányt, mint a pull mód.
A vLLM két külön folyamatra bontja a munkát
A vLLM nyílt forráskódú következtetési és kiszolgáló motor nagy nyelvi modellekhez. A modellkiszolgálás két eltérő szakaszból áll. A prefill feldolgozza a bemeneti promptot és felépíti a kulcsérték-gyorsítótárat, vagyis a KV-cache-t. A dekódolás ezt a gyorsítótárat használja a kimenet tokenenkénti előállításához.
A prefilling és a dekódolás külön motorpéldányokon is futtatható. Ez a P-D disaggregation néven jelölt felépítés lehetővé teszi, hogy a két szakaszt egymástól függetlenül méretezzék és optimalizálják. A megoldás ugyanakkor megköveteli a KV-cache átvitelét a prefill példánytól a decode példányhoz, még a tokenek generálásának megkezdése előtt.
Az átvitelt a vLLM egyik lehetőségeként az NVIDIA Inference Xfer Library, vagyis a NIXL végzi. A könyvtár RDMA-t támogató hálózatokon, például az AWS Elastic Fabric Adapteren keresztül továbbítja a KV-blokkokat. A támogatott példánytípusokon a rendszer közvetlenül a GPU vagy az AWS Trainium memóriája között is mozgathatja az adatokat, a gazdagép memóriájának közbeiktatása nélkül.
A push mód előre elkészíti az átvitelt
A vLLM alapértelmezett NIXL-működése pull alapú. Ebben a prefill példány a prompt feldolgozása után átadja a forrásblokkok adatait az útválasztónak, amely továbbítja azokat a decode példánynak. A decode oldal lefoglalja a célblokkokat, előkészíti az átvitelt, majd NIXL READ művelettel lekéri a KV-blokkokat.
Az AWS által bemutatott push alapú kapcsolóban a decode példány már előre regisztrálja a célblokkokat, miközben a prefill példány még a prompton dolgozik. Amint a forrásoldali KV-cache elkészül, a prefill oldal indíthatja az átvitelt. Ezzel kimarad a prefill utáni azonosító-átadás és a decode oldali előkészítés soros lépése.
A folyamat három lépésből áll. A decode példány regisztrációt küld a lefoglalt célmemória helyéről. A prefill oldal egyezteti ezt a regisztrációt a kész KV-blokkokkal, függetlenül attól, hogy melyik érkezik meg előbb. Ezután NIXL WRITE művelettel közvetlenül a decode példány memóriájába írja az adatokat.
A prefill példányon külön háttérszál készíti elő az átvitelt. Ez a szál hozza létre vagy használja újra a NIXL-kapcsolatot, memóriadeskriptorokat készít, összevonja az egymás mellett lévő blokkokat, majd elküldi az írási műveletet. A modell fő végrehajtási ciklusa így gyorsan folytathatja a munkát.
A vállalat szerint javulhat az első token ideje
Az AWS szerint a push mód két ponton csökkenti a késleltetést. Egyrészt átfedi a producer és a fogyasztó munkáját, másrészt a transzfer előkészítését a prefill oldalára és egy háttérszálra helyezi. A decode példánynak így kevesebb feladata marad a tokenek késleltetésérzékeny generálási szakaszában.
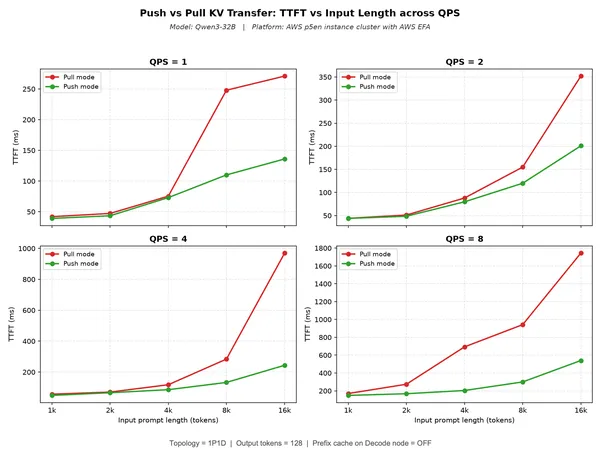
A vállalat Qwen3-32B modellel, egy prefill és egy decode példányból álló, 1P1D telepítésen végzett mérést Amazon EC2 P5en példányokon, EFA-kapcsolattal. A forrás szerint a push mód a pull módhoz képest akár háromszoros javulást ért el a time-to-first-token, vagyis az első tokenig eltelt idő mutatójában, a time-per-output-token, az egy kimeneti tokenre jutó idő esetében pedig akár 30 százalékos javulást hozott.
Az AWS hangsúlyozza, hogy az eredmények a terheléstől és a konfigurációtól függnek. A funkciót Trainium példányokból álló, EFA-val összekapcsolt klasztereken építették és ellenőrizték, majd gyorsítófüggetlen megoldásként hozzájárultak a vLLM projekthez. A bemutatott eredmények GPU-kat használó Amazon EC2 P5en klaszteren születtek.
A push módnak van útválasztási kompromisszuma is. A pull megoldásnál az útválasztó a prefill befejezése után választhat decode példányt, ami nagyobb rugalmasságot ad a terhelés szerinti útválasztásban és a szolgáltatásminőség kezelésében. Push módban a decode példányt korábban kell kiválasztani, cserébe a KV-átvitel hamarabb elindulhat, és a prefill példány gyorsabban felszabadíthatja a blokkjait.
AWS: Push-based KV transfer to improve TTFT and TPOT for disaggregated inference in vLLM
AWS: Improve TTFT for multi-turn agentic workloads with bi-directional KV transfer in vLLM