llama.cpp
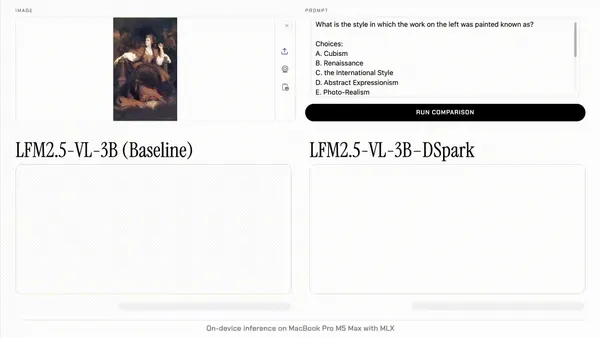
Gyorsabb lehet a képfeldolgozó LFM2.5-VL modell
A Hugging Face bemutatta az LFM2.5-VL-DSpark megoldást, amely a képet és szöveget is kezelő modellek következtetését gyorsíthatja. A közzétett adatok szerint a gyorsulás…
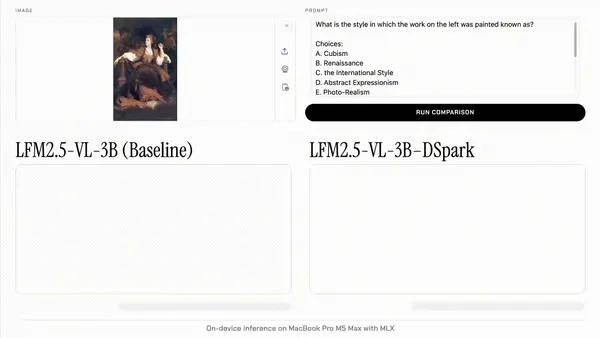
A Liquid AI látásmodellje akár 3,13-szor gyorsabban dekódol
A Liquid AI bemutatta az LFM2.5-VL-DSpark kísérleti modellt, amely az LFM2.5-VL-3B látásnyelvi modell dekódolását gyorsítja. A vállalat mérései szerint a dekódolási…
A Hugging Face Transformers már llama.cpp kvantált modelleket is futtat
A Hugging Face szerint a Transformers mostantól llama.cpp kvantált modellek futtatására is képes. A bejelentés részleteket nem közöl a támogatás technikai…
A beállítások többet számítanak, mint a helyi LLM-szerverek neve
A Mozilla.ai négy népszerű helyi LLM-szervert hasonlított össze Mac Studio M4-en, NVIDIA L40S-en és Steam Decken. A mérések szerint a teljesítményt sok esetben inkább a…
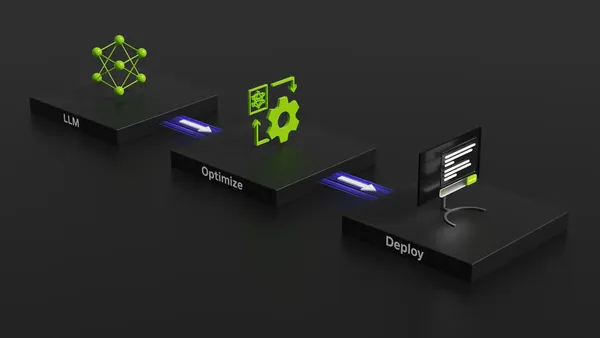
A Jetson AGX Thoron 6,4-szer gyorsabban futott az agentikus teszt
Az NVIDIA TensorRT Edge-LLM 24 perc 36 másodperc alatt futtatta le az MLPerf Inference v6.1 Edge Agentic benchmark teljesítménytesztjét egyetlen Jetson AGX Thor…
A Liquid AI Pipette-t adott ki az eszközön futó AI-modellek mérésére
A Liquid AI és az Artificial Analysis nyílt forráskódú benchmarkrendszert indított az eszközökön futó AI-modellek vizsgálatára. A Pipette a sebességet, késleltetést…
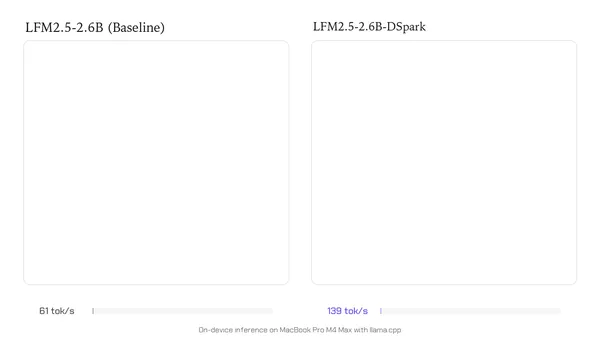
A Liquid AI DSpark modelljei akár 3,18-szoros gyorsulást ígérnek
A Liquid AI elérhetővé tette három LFM2.5 modell DSpark változatát, amelyek a vállalat mérései szerint akár 3,18-szoros átviteli sebességet kínálnak GPU-n, és akár…
A llamafile már a Ternary Bonsai 27B és a Laguna-S-2.1 modellt is futtatja
Megjelent a llamafile v0.10.5, amely a frissebb llama.cpp révén támogatja a Ternary Bonsai 27B és a Poolside Laguna-S-2.1 modelleket. A kiadás dokumentációs javításokat…