A Liquid AI DSpark modelljei akár 3,18-szoros gyorsulást ígérnek
A Liquid AI elérhetővé tette három LFM2.5 modell DSpark változatát, amelyek a vállalat mérései szerint akár 3,18-szoros átviteli sebességet kínálnak GPU-n, és akár 2,87-szereset helyi eszközökön. A modellek a spekulatív dekódolást használják, miközben a cég szerint a kimenet minősége nem változik.
- A Liquid AI három LFM2.5 modellhez adott ki DSpark változatot.
- A vállalat szerint a gyorsulás GPU-n akár 3,18-szoros, helyi eszközön akár 2,87-szeres.
- Az LFM2.5-2.6B M4 Maxon átlagosan 57 százalékkal csökkentette a függvényhívási késleltetést.
- A DSpark modellek elérhetők a Hugging Face-en, támogatásuk bekerült a llama.cpp és az SGLang projektbe.
- Az LFM2.5-8B-A1B helyi eszközön csak 18 százalékos átlagos javulást ért el.
Három LFM2.5 modell kapott DSpark változatot
A Liquid AI augusztus 20-án tette közzé az LFM2.5-1.2B-Instruct, az LFM2.5-2.6B és az LFM2.5-8B-A1B DSpark draft modelljeit. A vállalat szerint ezek a változatok minimális memóriaigény-növekedés mellett gyorsítják a dekódolást. Ez a Liquid Foundation Models első nyilvános spekulatív dekódolási modellkiadása.
A modellek elérhetők a Hugging Face-en. A hozzájuk tartozó, LFM-kompatibilis DSpark-integráció bekerült a llama.cpp és az SGLang nyílt forráskódú projektbe is. A futtatási részleteket a modellkártyák ismertetik.
Könnyű draft modell ellenőrzi a tokeneket
A spekulatív dekódolás alapötlete, hogy egy kisebb, könnyű modell előre elkészíti a lehetséges tokeneket, amelyeket a célmodell egyetlen előremeneti lépésben ellenőriz. Így a rendszer több token között osztja meg a súlyok betöltésének költségét. A Liquid AI szerint a dekódolási szakasz jellemzően memóriaigényes, mivel a rendszer a súlyokat a DRAM-ból az SRAM-ba továbbítja. Ez a vállalat szerint nagy teljesítményű GPU-kon, például az NVIDIA H100-on, és olyan helyi eszközökön is igaz, mint a MacBook vagy az iPhone.
A DSpark három fő elemet kombinál. A DFlash-stílusú párhuzamos gerincmodell a célmodell kontextusjellemzőire támaszkodik, a szekvenciális fej pedig a szomszédos tokenek közötti Markov-láncként működik. Emellett egy bizalomalapú ellenőrző előrejelzi az egyes tokenek elfogadásának valószínűségét, majd a hardverhez igazított ütemező elhagyja az alacsony biztonságú tokenfolytatásokat.
A draft modellek körülbelül 300 millió paraméteresek. A végleges változatok kiválasztásánál az elfogadási arányt vették alapul, nem kizárólag a validációs veszteséget. A tanítást és a kísérleteket kizárólag AMD hardveren végezték. A modellek öt réteget és kilences blokkméretet használnak.
H100-on és MacBookon is mértek gyorsulást
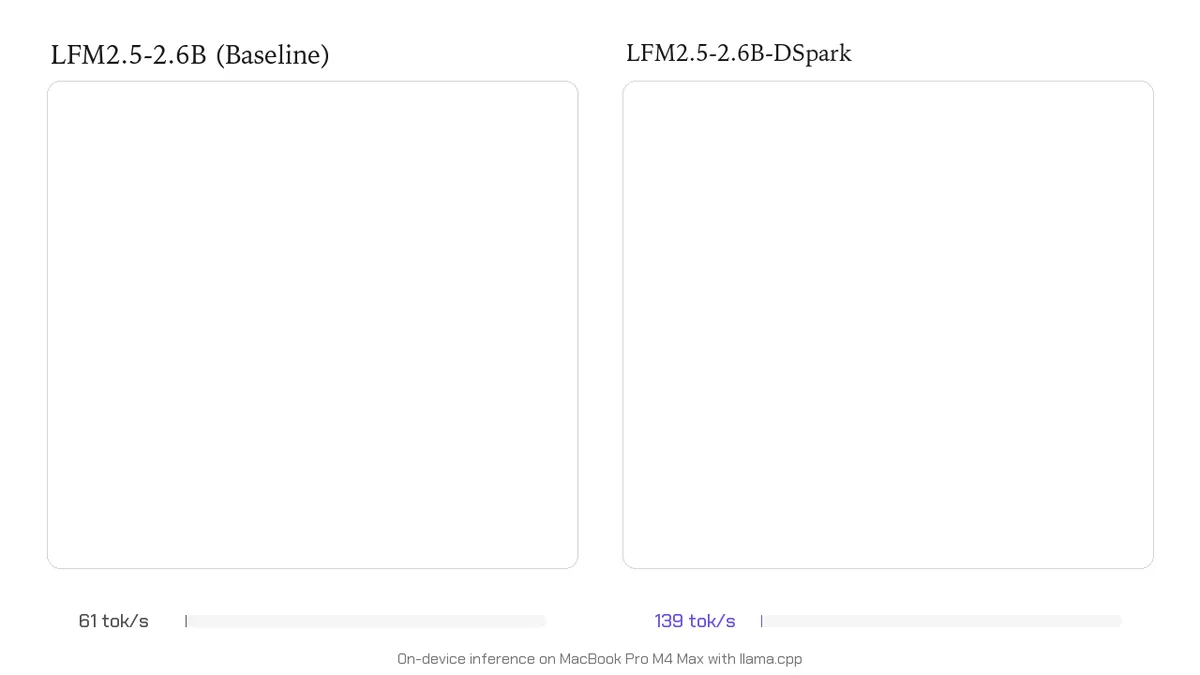
A Liquid AI az LFM2.5-2.6B esetében egyetlen, 80 GB-os H100 GPU-n, valamint egy M4 Max chippel szerelt MacBook Prón végzett méréseket. A tesztek FP16, illetve BF16 formátumot, egyes kötegméretet, nulla hőmérsékletet és legfeljebb 256 kimeneti tokent használtak. Öt adathalmazon, a MATH500, GSM8K, HumanEval, MBPP és MT-Bench teszteken a modell átlagos gyorsulása 2,67-szoros volt H100-on, illetve 2,27-szeres M4 Maxon. Az átlagos teljesítmény 323-ról 864 tokenre nőtt másodpercenként H100-on, MacBookon pedig 61-ről 139 tokenre.
Az LFM2.5-1.2B-Instruct átlagosan 2,10-szeres gyorsulást ért el H100-on, és 2,54-szereset M4 Maxon. A mért átlagos sebesség 656-ról 1384 tokenre, illetve 138-ról 350 tokenre nőtt másodpercenként. A vállalat szerint ennél a modellnél az adathalmaztól függően akár 52 százalékos eltérés is lehet a gyorsulásban.
Az LFM2.5-8B-A1B esetében a GPU-s átlagos gyorsulás 2,54-szeres volt, helyi eszközön azonban csak 18 százalékos javulást mértek. A Liquid AI ezt a llama.cpp Metal-alapú MoE-megvalósításával, valamint azzal magyarázza, hogy több token ellenőrzése több szakértő aktiválásával és nagyobb súlyforgalommal jár.
A gyorsulás az ügynöki feladatoknál is számít
A Liquid AI az LFM2.5-2.6B modellt olyan helyi ügynöki feladatokra szánta, amelyekben a modell minden eszközhívás előtt következtet. A BFCL adathalmazon végzett, több eszközt használó függvényhívási tesztekben a DSpark átlagosan 57 százalékkal csökkentette a késleltetést M4 Max MacBook Prón.
Greedy dekódolásnál a draft token csak akkor kerül a kimenetbe, ha egyezik a célmodell eloszlásával. Elutasítás esetén a célmodell saját tokenje váltja fel, ezért a Liquid AI szerint a kibocsátott szekvencia megegyezik az alap greedy dekódolás eredményével, így a pass@1 vagy exact match típusú pontosság változatlan marad.