A Jetson AGX Thoron 6,4-szer gyorsabban futott az agentikus teszt
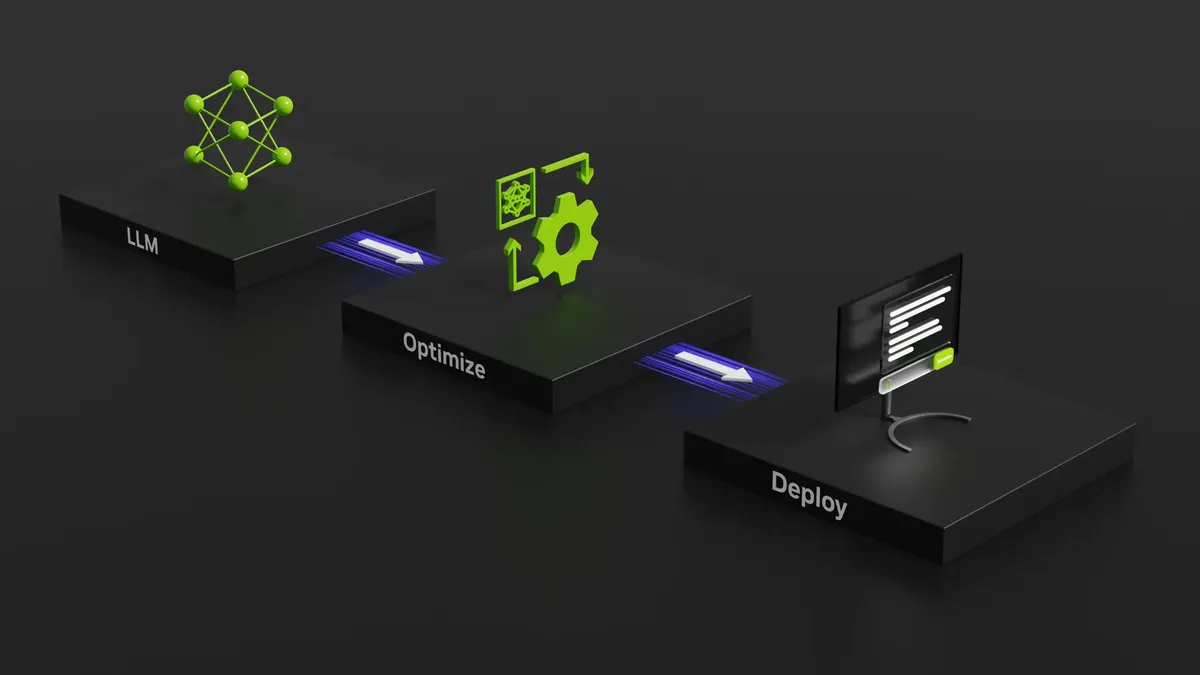
Az NVIDIA TensorRT Edge-LLM 24 perc 36 másodperc alatt futtatta le az MLPerf Inference v6.1 Edge Agentic benchmark teljesítménytesztjét egyetlen Jetson AGX Thor fejlesztői készleten. Ez 6,4-szer rövidebb idő a llama.cpp referenciafuttatásának 2 óra 37 perces eredményénél.
- A TensorRT Edge-LLM 24 perc 36 másodperc alatt teljesítette az 1007 fordulós tesztet.
- A rendszer 52,33 tokent generált másodpercenként egy Jetson AGX Thoron.
- A llama.cpp referenciafuttatás 2 óra 37 perc alatt végzett.
- A prompt tokenek körülbelül 96 százalékát gyorsítótárból szolgálták ki.
- A faalapú többtokenes előrejelzés körülbelül 40 százalékos többletet adott a dekódolásban.
Hosszú, eszközhasználó munkamenetet mértek
Az NVIDIA Developer szeptember 16-i beszámolója szerint a TensorRT Edge-LLM a Qwen3.6-27B modellt futtatta egyetlen, 128 GB egységes memóriával rendelkező NVIDIA Jetson AGX Thor Developer Kiten, MAXN energiaüzemmódban. A rendszer az MLPerf Inference v6.1 Edge Agentic tesztjén 52,33 tokent generált másodpercenként.
Az Edge Agentic benchmark egy OpenAI-kompatibilis modellvégpont teljesítményét és pontosságát vizsgálja. A teljesítménymérés rögzített szoftverfejlesztési ügynöki útvonalakat játszik vissza: a modell felhasználói kérést kap, eszközhívást generál, feldolgozza az eszköz eredményét, majd ugyanabban a beszélgetésben folytatja a munkát.
A munkaterhelés 20 beszélgetésből és 1007 generált fordulóból áll. A bemenet hossza menet közben növekszik, és megközelíti a 23,5 ezer tokent. A rendszer medián elsőtoken-késleltetése 247,12 ezredmásodperc, a kimeneti tokenenkénti medián ideje 14,68 ezredmásodperc lett. A BFCL v4 funkcióhívási pontossági mérésén 87,94 százalékos eredményt ért el.
A gyorsulást több optimalizálás együtt adta
Az NVIDIA szerint az eredményhez az NVFP4 kvantálás, a faalapú többtokenes előrejelzés és a gyorsítótár újrahasznosítása is hozzájárult. A Qwen3.6-27B súlyai és aktivációi, köztük a nyelvi modell kimeneti rétege, NVFP4 formátumot használnak. A kulcsérték-gyorsítótár, vagyis a KV cache FP8 formátumban működik.
Az NVFP4 egy 4 bites lebegőpontos formátum, amelyet a Jetson AGX Thorban található Blackwell GPU támogat. A kisebb modellreprezentáció kevesebb memóriát használ, így több egységes memória marad a hosszú kontextusnak, a spekulatív dekódolás állapotának és az alkalmazásoknak.
Az ügynöki beszélgetések új kérései rendszerint tartalmazzák az előző előzmények nagy részét. A TensorRT Edge-LLM felismeri az újrahasznosítható prompt-előtagokat, majd visszaállítja a hozzájuk tartozó figyelmi gyorsítótár oldalait. A Qwen3.6 hibrid modellarchitektúrája miatt a futtatókörnyezet a rekurrens állapotot és a részleges KV-állapotot is visszaállítja.
A teljes munkaterhelésben a prompt tokenek körülbelül 96 százalékát gyorsítótárból szolgálták ki. Emiatt a rendszer a fordulók összesen 13,6 millió prompt tokenjéből körülbelül 0,5 milliót dolgozott fel újra.
Faalapú tokenjóslással gyorsították a függvényhívásokat
A hagyományos autoregresszív dekódolás minden modellhívásnál egy token előállításával halad. A többtokenes előrejelzés ezzel szemben egy vázlatmodell segítségével több jövőbeli tokent jósol, amelyeket a célmodell egyszerre ellenőriz.
A TensorRT Edge-LLM a lineáris megoldás mellett faalapú többtokenes előrejelzést is alkalmaz. A rendszer a valószínű jelölteket fába rendezi, majd a célmodell egyetlen előrelépésben ellenőrzi az ágakat. Az MLPerf konfigurációja 8 vázlatlépést, minden mélységben a 2 legjobb jelöltet és egy 16 csomópontos ellenőrzési fát használt.
Az NVIDIA közlése szerint ez a megoldás a három vázlatlépéses lineáris többtokenes előrejelzéshez képest további körülbelül 40 százalékos dekódolási teljesítménynövekedést adott ezen a munkaterhelésen. A módszer különösen a függvényhívásoknál lehet hasznos, mivel az eszköznevek, a JSON-szintaxis és a gyakori argumentumszerkezetek sokszor előre jelezhetők.
A fejlesztők számára elérhető a teszt konfigurációja
Az NVIDIA a benyújtáshoz használt megvalósítást a TensorRT Edge-LLM release/0.9.1-mlpinf ágában tette közzé. Az ág tartalmazza a modell exportálási beállításait, a TensorRT motorok felépítéséhez szükséges parancsokat, a szerverkonfigurációt és az MLPerf kliensbeállításait.
A fejlesztők letölthetik a kalibrált Qwen3.6-27B NVFP4 ellenőrzőpontot, majd a leírás alapján felépíthetik az alap- és vázlat-TensorRT motorokat. A közzétett MLPerf Edge Agentic példa a munkaterhelés adat- és kliensbeállításait is tartalmazza.
Az eredmény azt mutatja, hogy a hosszú kontextust, eszközhívásokat és ismétlődő beszélgetési előzményeket kezelő ügynöki modellek futtatásánál az edge eszközökön a memóriahasználat, a gyorsítótár újrahasznosítása és a dekódolási stratégia egyaránt meghatározó lehet. A forrásban szereplő mérés egy konkrét Jetson AGX Thor konfigurációra és a Qwen3.6-27B modellre vonatkozik.
NVIDIA Developer: TensorRT Edge-LLM Completes the MLPerf Edge Agentic Benchmark 6.4x Faster on Jetson AGX Thor