NIXL
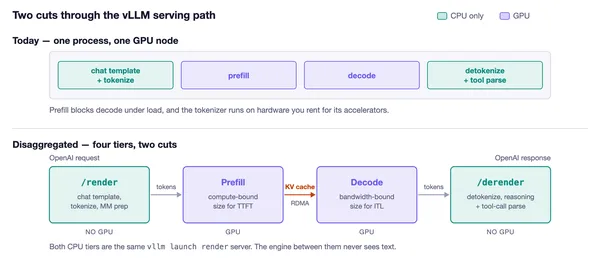
A vLLM különválasztaná a promptfeldolgozást és a tokenek generálását
A vLLM új útmutatója azt mutatja be, hogyan választható szét a nagy nyelvi modellek kiszolgálásában a promptok feldolgozása, a tokenek generálása és a CPU-s…
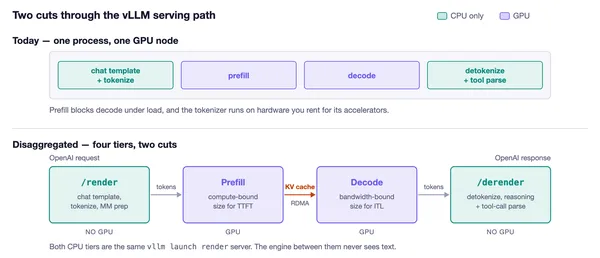
A vLLM négy részre bontaná az LLM-kiszolgálást
A vLLM új útmutatója a nagy nyelvi modellek kiszolgálásának szétválasztását mutatja be. A prefill és a decode külön példányokra helyezésével csökkenthető a hosszú…
Az NVIDIA szerint akár 7-szer gyorsítható a multimodális kiszolgálás EPD-vel
Az NVIDIA Developer 2026. szeptember 9-én ismertette, mikor érdemes encode-prefill-decode, azaz EPD szétválasztást használni multimodális modellek kiszolgálásához. A cég…
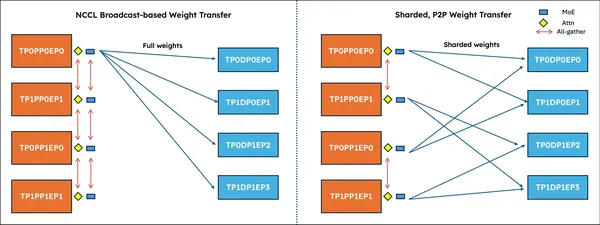
A vLLM gyorsabb és takarékosabb modellfrissítést ígér nagy RL-rendszerekben
A vLLM új, osztott modellparaméter-átviteli motorral segíti az online megerősítéses tanulási rendszereket. A Ray Direct Transportra épülő megoldás csak az egyes…