A vLLM gyorsabb és takarékosabb modellfrissítést ígér nagy RL-rendszerekben
A vLLM új, osztott modellparaméter-átviteli motorral segíti az online megerősítéses tanulási rendszereket. A Ray Direct Transportra épülő megoldás csak az egyes következtetési dolgozóknak szükséges paraméterrészleteket továbbítja.
- A vLLM osztott súlyátviteli motort készített online RL-rendszerekhez.
- Az RDT és a NIXL csak a szükséges paraméterrészeket továbbítja az egyes rangoknak.
- A rendszer dense, MoE és kvantált modellek támogatására készült.
- A Kimi K2 BF16 átvitele 7,53 másodpercet vett igénybe 48, 8 H100 GPU-s csomóponton.
- A megvalósítás elérhető a vLLM-ben, példával a SkyRL-ben.
A teljes modell továbbítása helyett csak a szükséges részek érkeznek
Az online megerősítéses tanulási, vagyis RL-rendszerekben a tanítás és a következtetés során használt modell súlyait rendszeresen össze kell hangolni. Erre azért van szükség, hogy a rendszer a legfrissebb modellverzióval készítse a rollouteket. A vLLM szerint ez egyre fontosabb, ahogy a nyílt forráskódú modellek mérete eléri, illetve meghaladja az ezermilliárd paramétert.
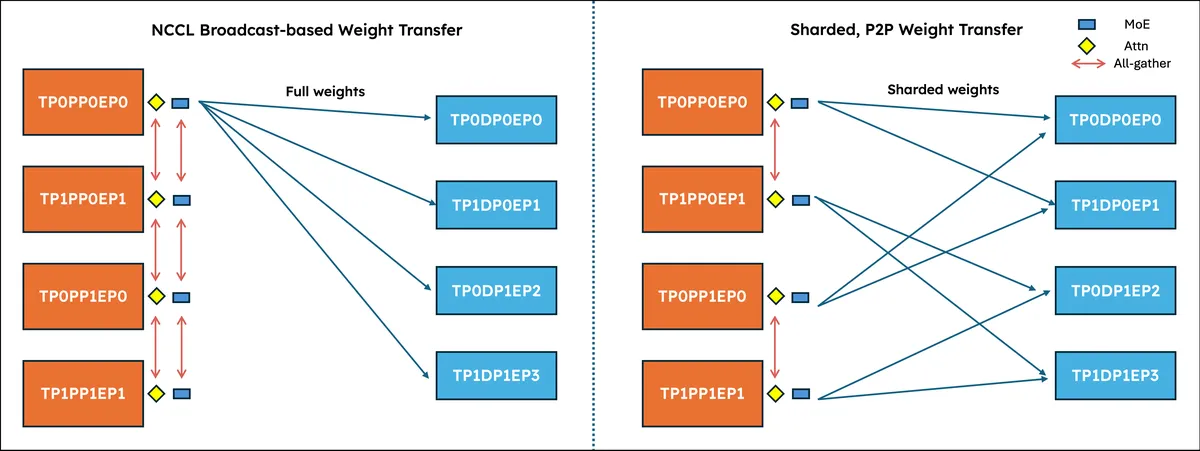
A korábbi, NCCL-alapú megközelítésben a tanító folyamat egyik rangja minden paramétert összegyűjt HuggingFace-formátumba, majd broadcasttal továbbítja a teljes modellt minden következtetési dolgozónak. Egy TP8 konfigurációban egy dolgozó a paramétereknek csak a nyolcadát tartja meg, a többit eldobja. A vLLM szerint ez különösen nagy MoE-modelleknél okozhat jelentős memóriaigényt és lassabb átvitelt.
Az új motor minden tanító rangot bevon az átvitelbe, és csak azt a paraméterszilánkot küldi el, amelyre az adott következtetési rangnak szüksége van. A rendszer elkerüli a súlyok összegyűjtését pipeline párhuzamosítási rangjai között, valamint az experts rétegek összegyűjtését is.
A vLLM saját betöltési folyamatából készül a sharding-terv
A súlyok útja a vLLM-ben több lépésből áll. A rendszer egyesítheti például a Q, K és V tenzorokat, átrendezheti vagy átformázhatja őket, kiválaszthatja az experts egy részét, majd feldarabolhatja a tenzort a tensor párhuzamosításhoz. Ezután a súlyok egy rétegenkénti pufferbe kerülnek, majd további feldolgozáson és másoláson mennek keresztül.
A vLLM az első négy lépést a tanító oldalon végzi el, és BF16 formátumú, feldolgozatlan, de már felosztott súlyokat továbbít. A fogadó oldalon marad a rétegenkénti pufferbe másolás, az opcionális kvantálás és a végső GPU-memóriába írás. Ez lehetővé teszi, hogy a megoldás különböző kvantálási eljárásokkal is működjön.
A kompatibilitás érdekében a fejlesztők egy úgynevezett recording tensorral futtatják végig a vLLM súlybetöltőit. Ez az adatot nem tároló tenzorfajta rögzíti a transzformációkat, például a nézetváltást, a szeletelést, az átültetést és az átméretezést. Az így létrejövő sharding-terv alapján a tanító folyamat előállítja az egyes rangok számára szükséges részeket. Mivel a tervet maga a vLLM töltési logikája készíti, a módszer a támogatott modellek és rétegek eltérő viselkedéséhez is alkalmazkodhat.
Ray Direct Transport és NIXL a háttérben
A vLLM megoldása a Ray Direct Transport, röviden RDT API-ra épül. Ez lehetővé teszi, hogy egy Ray-aktor metódusa GPU-tenzorokat adjon vissza anélkül, hogy azokat előbb le kellene másolni a GPU-ról. A hívó egy ObjectRef hivatkozást kap, az adatok pedig akkor mozognak a választható átviteli rétegen, amikor a hívó beolvassa őket.
A vLLM ehhez a NIXL hátteret választotta. A fejlesztők szerint ez rugalmas peer-to-peer kommunikációt tesz lehetővé, és támogatja az egyedi paraméterek továbbítását az egyes következtetési rangok felé. Az átviteli modell pull-alapú, vagyis a következtetési rangok kérik le a szükséges, felosztott tenzorokat egy vagy több, hozzájuk rendelt tanító rangtól.
A rendszer indulásakor a tanító rangok összegyűjtik a paraméterek nevét, adattípusát, teljes alakját és az egyes rangokon található súlyok elrendezését. A vLLM dolgozói ezután elkészítik saját sharding-tervüket, majd feltérképezik, mely tanító rangoktól kell lekérniük az egyes paramétereket. Ha egy paraméter több tanító rangon is elérhető, a rendszer terheléselosztott módon választ közülük.
A Kimi K2 frissítése 7,53 másodperc alatt
A vLLM közlése szerint az új megoldással a Kimi K2 BF16 formátumú sharded weight transfer átvitele 7,53 másodpercet vett igénybe 48, egyenként 8 H100 GPU-t tartalmazó csomóponton. A felállásban 32 csomópont szolgálta a tanítást, 16 pedig a következtetést.
A motor a feldolgozás és az átvitel átfedésével is gyorsít. A súlyok összegyűjtése, továbbítása és utófeldolgozása párhuzamosan történhet. A vLLM egy hibákat toleráló rollout-demót is bemutatott, amely az RDT és a NIXL hibatűrési tulajdonságait szemlélteti.
A megvalósítás elérhető a vLLM-ben, a teljes folyamatot bemutató példa pedig a SkyRL-ben található. A vLLM szerint az API használatához az RL-keretrendszereknek a súlyok elrendezését kell leírniuk, az átvitel teljes kezelését ezután a motor végzi.