Az NVIDIA szerint akár 7-szer gyorsítható a multimodális kiszolgálás EPD-vel
Az NVIDIA Developer 2026. szeptember 9-én ismertette, mikor érdemes encode-prefill-decode, azaz EPD szétválasztást használni multimodális modellek kiszolgálásához. A cég szerint a módszer bizonyos terheléseknél akár 5-ször gyorsabb első tokenig tartó időt és 7-szer gyorsabb teljes válaszidőt hozhat.
- Az NVIDIA Dynamo EPD szétválasztása külön kezeli a látási kódolást, a prefillt és a dekódolást.
- A cég szerint bizonyos terheléseknél akár 5-ször gyorsabb TTFT és 7-szer gyorsabb E2E válaszidő érhető el.
- Az EPD főleg sok képet vagy videót tartalmazó promptoknál, rövid vagy közepes kimeneteknél és kvantált MoE modelleknél hasznos.
- Vegyes forgalomban az NVIDIA mérése szerint a szöveges kérések átlagos TTFT értéke 42,2 százalékkal csökkent.
- A nyereség kisebb lehet, ha a dekódolás dominálja a késleltetést, vagy nagy dense modell fut.
Mit választ szét az EPD a multimodális inferenciában?
Az NVIDIA leírása szerint az encode-prefill-decode, röviden EPD szétválasztás olyan inferenciaoptimalizálási technika, amely külön kezeli a látási kódoló, a nagy nyelvi modell prefill és a dekódolási szakaszát. A megoldást a cég a Dynamo nyílt forrású inferenciakeretrendszerben mutatja be, amely elosztott környezetben szolgál ki AI-modelleket.
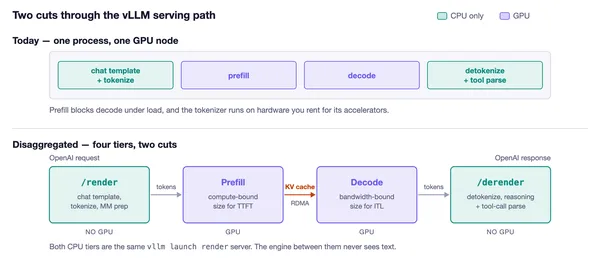
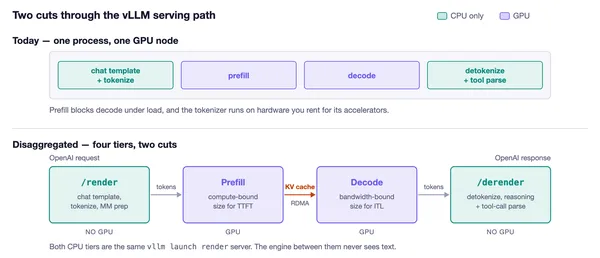
Multimodális kérésnél a rendszernek a nyelvi modell prefill szakasza előtt fel kell dolgoznia a médiát, majd futtatnia kell a vision transformer, vagyis ViT részt, amely embeddingeket állít elő. Aggregált kiszolgálásnál a látási kódolás, a prefill és a dekódolás ugyanazon a workeren és ugyanabban az ütemezési tartományban fut. Az NVIDIA szerint ez az egyszerű felépítés akkor működik jól, ha a médiafeldolgozás csak kis része a teljes terhelésnek.
A helyzet megváltozik, ha a kérések több képet vagy videót tartalmaznak. A forrás szerint a látási kódolás ilyenkor több száz milliszekundumig vagy tovább is tarthat. Mivel az encoder és a nyelvi modell ugyanazt a GPU-t használja, egy médiában gazdag kérés késleltetheti a saját prefill szakaszát, és versenyezhet a párhuzamos prefill és dekódolási munkákkal. Vegyes forgalomnál a csak szöveges kérések is várakozhatnak multimodális kérések mögött, noha nincs szükségük látási kódolásra.
Háromféle elhelyezés az encoder workereknek
A Dynamo EPD kiszolgálása az encoder és a PD worker szerepeit választja szét, de nem rögzíti előre, hogy ezek milyen hardveren fussanak. Az encoder workerek látási embeddingeket állítanak elő, a PD workerek pedig ezeket felhasználva futtatják a nagy nyelvi modellt. Az NVIDIA Inference Transfer Library, vagyis NIXL továbbítja az embeddingeket az egyes részek között.
Az NVIDIA három topológiát különböztet meg. Az aggregált kiszolgálásban minden GPU egyetlen aggregált workert futtat, amely a látási kódolást, a prefillt és a dekódolást egy kérés életciklusán belül kezeli. A colocated encoder elrendezésben egy GPU-n egy vagy több encoder worker fut egy PD worker mellett, külön kérési sorokkal és kötegeléssel, de közös GPU-erőforráson.
A cég szerint homogén klaszteren általában a colocated encoder a jobb illeszkedés. Ennek oka, hogy a látási encoder könnyebb a nagy nyelvi modellhez képest, ezért egy teljes azonos osztályú GPU fenntartása csak encoder munkára kihasználatlan kapacitást hagyhatna.
A harmadik lehetőség a disaggregated encoder, ahol az encoder workerek külön, alacsonyabb költségű GPU-rétegen futnak, miközben a PD workereket az elsődleges GPU-réteg szolgálja ki. Az NVIDIA tesztkörnyezetében két NVIDIA RTX 6000D GPU futtatta az encoder workereket, négy NVIDIA GB200 GPU pedig a PD workereket. A forrás hozzáteszi, hogy a homogén GPU-kkal épített szétválasztott felállást nem vizsgálták, mert az mindig alulteljesíti a colocated encoder elrendezést.
Mikor hoz mérhető gyorsulást?
Az NVIDIA szerint az EPD előnye attól függ, hogyan oszlik meg a munka a látási kódolás, a prefill és a dekódolás között. A módszer akkor a leghasznosabb, ha a látási kódolás jelentős részt képvisel a kérés feldolgozási idejéből, vagy korlátozza az áteresztőképességet. Ilyen helyzetet gyakran a több képet, nagy felbontású képeket vagy videót tartalmazó kérések teremtenek.
A kimeneti szekvencia hossza szintén fontos tényező. Hosszabb OSL esetén a teljes késleltetés nagyobb része a dekódoláshoz kötődik. Az NVIDIA szerint az első tokenig tartó idő, vagyis TTFT javulása ilyenkor megmaradhat, de a teljes végponttól végpontig mért, E2E gyorsulás csökken.
A modell mérete és pontossága is befolyásolja az eredményt. A forrás szerint a ViT számítási igénye nagyrészt fix, míg a nagy nyelvi modell számítási terhe csökkenhet kevesebb aktív paraméterrel és alacsonyabb precizitással. Emiatt a kisebb, mixture-of-experts, röviden MoE, valamint alacsonyabb precizitású modellek többet profitálhatnak EPD-ből, miközben a nagy, dense modelleknél kisebb lehet a nyereség.
Vegyes, szöveges és multimodális forgalomnál a szétválasztás a sor eleji blokkolást is csökkentheti. Az NVIDIA mérése szerint ilyen forgalomnál az EPD a szöveges kérések átlagos TTFT értékét 42,2 százalékkal, a képes kérésekét 30,8 százalékkal mérsékelte.
Mit mértek a tesztkörnyezetben?
Az NVIDIA a benchmarkokat Qwen3.5 122B A10B NVFP4 modellel futtatta, kivéve a precizitási ablációs kísérleteket. A tesztekben négy GB200 GPU szerepelt, a szétválasztott elrendezésben további RTX 6000D GPU-kkal. Az aggregált módban GB200 GPU-nként egy TP1 aggregált worker futott. A co-located EPD esetében GB200 GPU-nként két encoder worker és egy PD worker dolgozott. A disaggregated EPD felállásban az RTX node-ok adták az encoder réteget, a GB200 GPU-k pedig a PD réteget.
A látási embeddingek átviteléhez NIXL-t használtak UCX RC/TCP Ethernet felett, a mért csúcsérték 20 Gbps volt. A Dynamo front endet párhuzamos média-dekódolással kapcsolták be. A goodput SLO feltétele az volt, hogy az inter-token latency, vagyis ITL 100 ms alatt maradjon.
A cikk szerint az EPD képben gazdag promptoknál, rövid vagy közepes kimeneteknél és kvantált MoE modelleknél hozhat akár 5-ször gyorsabb TTFT-t és 7-szer gyorsabb E2E válaszidőt. Az NVIDIA azt is közli, hogy ha a nyelvi modell súlyait NVFP4-re kvantálják, miközben a vision encoder BF16-ban marad, a colocated EPD goodput előnye az aggregált kiszolgáláshoz képest 1,78-szorosról 2,64-szorosra nő.
Mit jelent ez a szolgáltatóknak és felhasználóknak?
A forrás alapján az EPD nem általános gyorsítókapcsoló minden multimodális rendszerhez. Akkor lehet hasznos, ha az elkülönített encoder munka elég nagy ahhoz, hogy ellensúlyozza a workerek koordinációjának és az embeddingátvitelnek a többletköltségét. Ha a dekódolás uralja a késleltetést, vagy ha nagy dense modellek mellett a vision encoder részesedése kisebb a teljes számításból, a nyereség zsugorodik.
A felhasználók számára a forrásból levezethető hatás elsősorban a gyorsabb első válasz és a rövidebb teljes válaszidő lehet olyan alkalmazásokban, amelyek sok képpel vagy videóval dolgoznak. A szolgáltatóknak a döntéshez a média mennyiségét, a kimeneti hosszt, a modell típusát és precizitását, valamint a szöveges és multimodális kérések arányát kell vizsgálniuk.
Az NVIDIA következő lépésként az ai-dynamo/dynamo GitHub útmutatót ajánlja a kísérletek reprodukálásához. A cég javasolja a párhuzamos média-dekódolás bekapcsolását, az embedding cache használatát az ismétlődő médiatartalmakhoz, valamint a multimodális KV routing alkalmazását azokhoz a kérésekhez, amelyek közös médián osztoznak.
NVIDIA Developer: When to Use Encode-Prefill-Decode Disaggregation to Accelerate Multimodal Model Serving