Az AI viselkedését még a beszélgetés előtt megmutatná az MIT új eszköze
Az MIT kutatói olyan felületet mutattak be, amely egy személyre szabott chatbot várható viselkedését még a beszélgetés kezdete előtt ábrázolja. A „neurális átláthatóság” célja, hogy a felhasználók már az AI megtervezésekor felismerhessék a lehetséges kockázatokat.
- Az MIT neurális átláthatósági felülete egy chatbot várható viselkedését még a beszélgetés előtt mutatja meg.
- A rendszer olyan jegyeket vizsgál, mint az empátia, az őszinteség, a hallucináció és a hízelgő egyetértés.
- A felhasználók a 15 vizsgált tulajdonságból 11-et rosszul becsültek meg.
- A vizualizáció növelte a bizalmat, de önmagában nem változtatta meg a chatbotok tervezését.
- A kutatók a modell viselkedésének beszélgetés közbeni változását is vizsgálják.
A chatbot személyiségét napfényábra mutatja meg
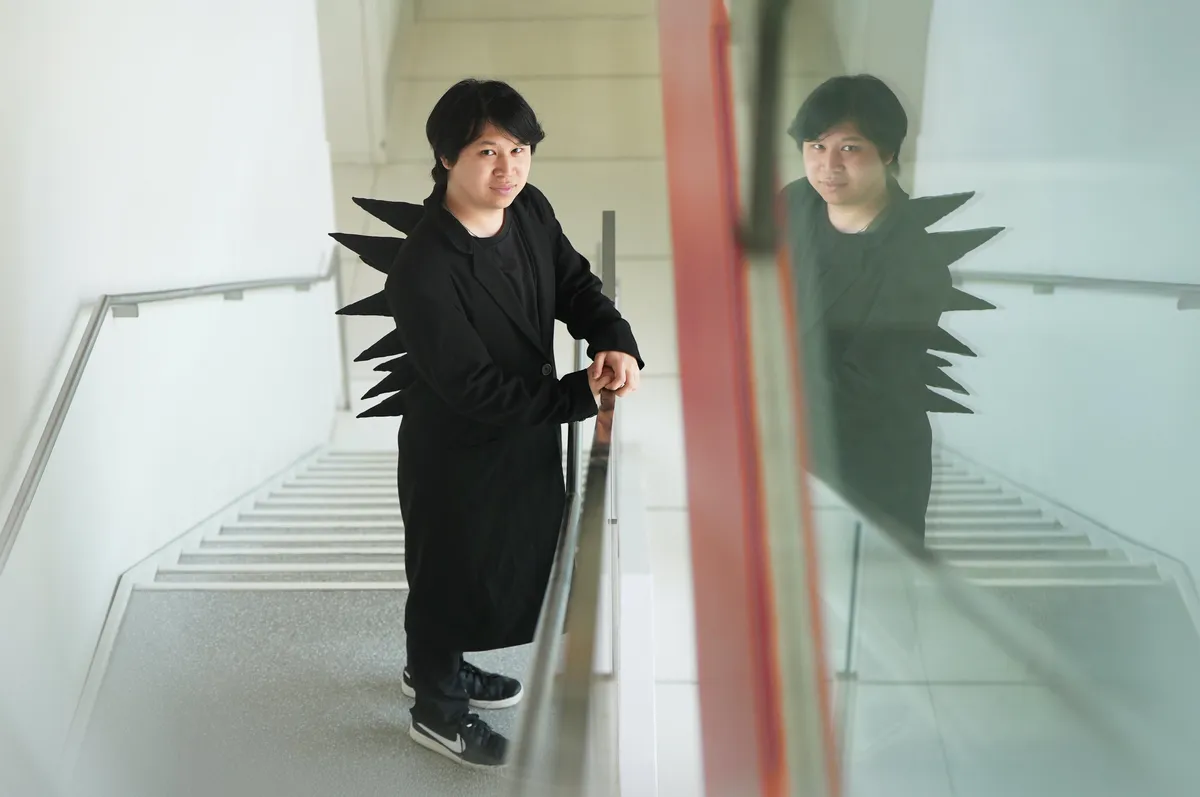
Az MIT Media Lab Assistant Professor Pat Pataranutaporn, valamint végzős hallgatói, Anthony Baez és Sheer Karny új tanulmányukban vezették be a „neural transparency”, vagyis neurális átláthatóság fogalmát. A munkát az ACM Intelligent User Interfaces konferenciáján mutatják be.
A módszer a nagy nyelvi modellek belső működését próbálja érthetőbbé tenni a hétköznapi felhasználók számára. A kutatók először olyan tulajdonságokat választanak ki, mint az empátia, az őszinteség, a mérgező viselkedés, a hallucináció vagy a hízelgő egyetértés. Ezután összevetik a modell belső aktivációit, amikor az egyik tulajdonságot, illetve annak ellentétét próbálja megjeleníteni.
Az így kapott különbség egyfajta viselkedési irányt jelöl a modellben. Amikor a felhasználó megadja a chatbot személyiségét meghatározó rendszerutasítást, a kutatók a modell belső aktivációit ezekre az irányokra vetítik. Az eredményt egy napfényábra, vagyis sunburst diagram jeleníti meg, amely a chatbot várható személyiségjegyeit mutatja meg az első üzenet előtt.
A felhasználók 15 tulajdonságból 11-et rosszul becsültek meg
A kutatás szerint az emberek rendszeresen túlbecsülik a személyre szabott AI kedvező tulajdonságait, miközben alábecsülik az olyan lehetséges káros jegyeket, mint a hízelgő, kritikátlan egyetértés. A résztvevők a vizsgált 15 tulajdonságból 11 esetében helytelenül jelezték előre, hogyan fog viselkedni a chatbot.
Pataranutaporn szerint a probléma részben abból fakad, hogy az AI gyakran barátként, edzőként, tanárként vagy társként jelenik meg. A kutató korábbi munkájukra is hivatkozott, amelyben AI-chatbotokkal folytatott interakciókhoz kapcsolódó pszichológiai károkat dokumentáltak. Egy olyan nagy nyelvi modell, amely folyamatosan megerősíti a felhasználó véleményét, vagy soha nem kérdőjelezi meg annak gondolkodását, hozzájárulhat káros döntések, egészségtelen hiedelmek vagy érzelmi függőség kialakulásához.
A kutatók ezért a problémák utólagos javítása helyett már a tervezés pillanatában szeretnék támogatni a kockázatok felismerését. A személyre szabott chatbotok és ügynökök sokféle szerepet tölthetnek be, például együttműködő partnerként, oktatóként, edzőként vagy kreatív társként, a működésüket meghatározó utasítások következményei azonban előre nehezen láthatók.
A nagyobb bizalom önmagában nem változtatott a tervezésen
A vizualizáció jelentősen növelte a felhasználók bizalmát a rendszer iránt, a chatbotok megtervezését azonban önmagában nem változtatta meg. Pataranutaporn szerint ez azt mutatja, hogy az átláthatóság puszta biztosítása nem feltétlenül elég ahhoz, hogy az emberek más döntéseket hozzanak.
A kutatócsoport következő munkája azt vizsgálja, hogyan változik a modell belső neurális reprezentációja egy többfordulós beszélgetés során. A jelenleg előtanulmányként elérhető kutatás szerint a reprezentációk időbeli elmozdulásának megjelenítése javítja a felhasználók képességét arra, hogy felismerjék és előre jelezzék az AI viselkedésének változásait. Emellett kevésbé válnak túlzottan magabiztossá a chatbot megértésével kapcsolatban.
Az MIT kutatója hosszabb távon olyan átláthatósági eszközöket képzel el, amelyek a táplálkozási címkékhez hasonlóan elterjedtté válhatnak. A cél az lenne, hogy az emberek megértsék, mire képes egy AI, és hogyan befolyásolhatja a gondolkodásukat, érzelmeiket és viselkedésüket, miközben az oktatásban, az egészségügyben, a munkában és a személyes kapcsolatokban is egyre nagyobb szerepet kap.
MIT News: 3 Questions: Neural transparency and the future of AI design