Az NVIDIA Mission Control 2.5 önállóan állítja helyre a Kubernetes-feladatokat
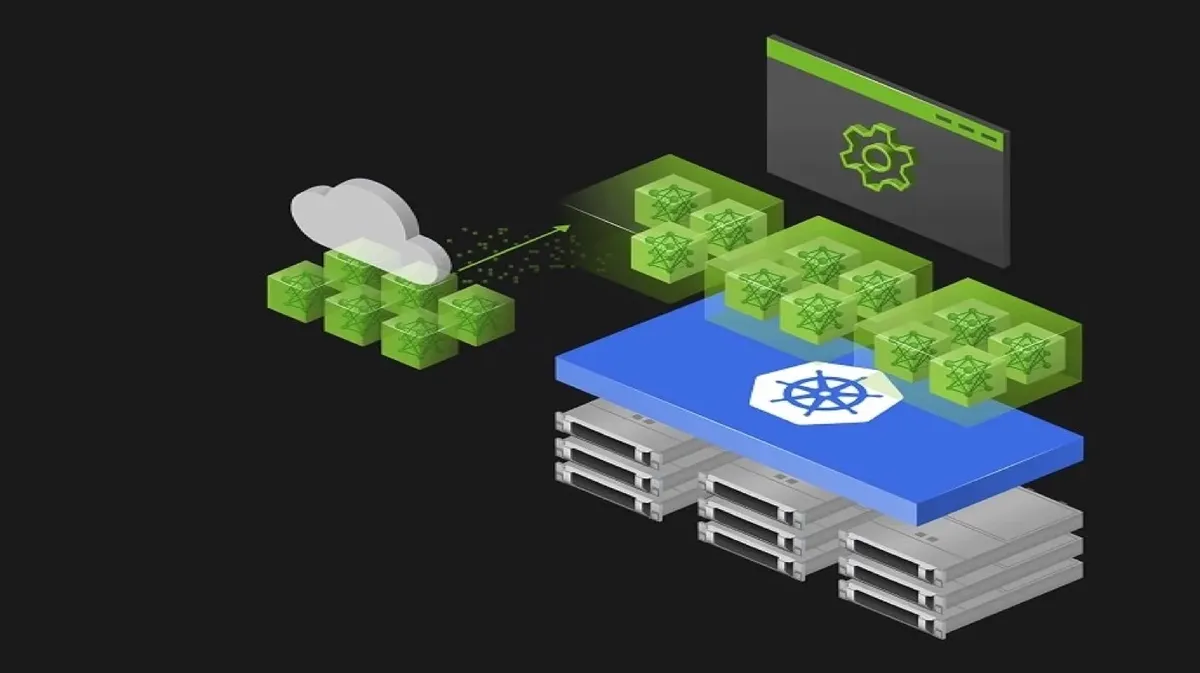
Az NVIDIA Mission Control 2.5 a Kubernetes-alapú, NVIDIA Run:ai által kezelt munkafolyamatokra is kiterjeszti az önálló helyreállítási motort. A rendszer külön kezeli a feladatok hibáit és az infrastruktúra problémáit, így a munkák újraindulhatnak, miközben a hibás gépek diagnosztikája párhuzamosan folytatódik.
- A Mission Control 2.5 a Kubernetes- és Run:ai-alapú munkafolyamatokra is kiterjeszti az önálló helyreállítást.
- A rendszer az ütemezőt, a feladat-helyreállítást és a hardver-helyreállítást egy háromrétegű modellben kapcsolja össze.
- Hardverhiba esetén a feladat újraindítása vagy áthelyezése a diagnosztikával párhuzamosan történhet.
- Átmeneti szoftverhibáknál a rendszer újrapróbálkozhat hardveres karantén nélkül.
- A romló állapotú csomópontokat a rendszer már a feladatindítás előtt eltávolíthatja az ütemezésből.
A Kubernetesre is kiterjed az önálló helyreállítás
Az NVIDIA október 26-án ismertetett Mission Control 2.5-ös kiadása az önálló helyreállítási motort a Kubernetes-alapú munkafolyamatokra is kiterjeszti. A funkció korábban a Slurmöt használó nagy teljesítményű számítástechnikai, vagyis HPC-munkaterhelésekre korlátozódott.
Az új változatban a rendszer az NVIDIA Run:ai által kezelt Kubernetes-feladatokkal dolgozik. Az NVIDIA szerint a cél az, hogy az AI-factory műveletei a reaktív üzemeltetés helyett proaktív, önjavító infrastruktúrára támaszkodhassanak. A helyreállítási motor felismeri és kivizsgálja az anomáliákat, elkülöníti a problémás erőforrásokat, majd a lehető legkisebb kieséssel juttatja vissza a feladatokat a működő kapacitásra.
Három együttműködő réteg kezeli a hibákat
A Mission Control 2.5 helyreállítási modellje három komponensből áll. A Kubernetes ütemezője, a Mission Control részeként elérhető NVIDIA Run:ai alapértelmezett ütemezőként kezeli az AI-munkafolyamatokat, a várólistákat és a szabályokat, majd a feladatokat a rendelkezésre álló kapacitásra helyezi.
Az autonomous job recovery, vagyis az önálló feladathelyreállítási szolgáltatás a munkafolyamatok állapotát és környezetét figyeli. Nyilvántartja, hol futnak a feladatok, figyelembe veszi a korábbi hibákat és a feladat topológiáját, majd ezek alapján választja ki a megfelelő helyreállítási módot. Ez lehet újraindítás, újrapróbálkozás, visszahelyezés a várólistára vagy másik kapacitásra történő áthelyezés.
Az autonomous hardware recovery, vagyis az önálló hardverhelyreállítási szolgáltatás a csomópontokat és a GPU-kat ellenőrzi. Szükség esetén eltávolítja az anomáliákat az ütemezésből, valamint diagnosztikát vagy helyreállítási műveletet indít. A három szerep elkülönítése lehetővé teszi, hogy a feladat-helyreállításnak ne kelljen hardvert javítania, a hardveres szolgáltatásnak pedig ne kelljen minden tanítási keretrendszert ismernie.
Más útvonal indul hardverhiba és szoftverhiba esetén
Ha egy elosztott tanítási feladat futása közben egy GPU meghibásodik, a rendszer két párhuzamos folyamatot indít. A feladathelyreállítási szolgáltatás azonosítja a gyanús csomópontot vagy GPU-t, a Kubernetes-integráció pedig újraindítja vagy másik helyre ütemezi a munkát. Ezzel párhuzamosan a hardverhelyreállítási szolgáltatás elkülöníti a problémás csomópontot, rögzíti az okot és diagnosztikát indít. A munkafolyamat így nem várja meg a kiváltó ok teljes feltárását, a hibás csomópont pedig nem kerülhet véletlenül a következő feladathoz.
A rendszer a szoftveres hibákat is külön kezeli. Ha egy munkafolyamat dolgozója leáll, átmeneti időtúllépés történik, vagy rövid időre megszakad az együttműködés, miközben a csomópont működőképes marad, a feladathelyreállítási szolgáltatás a hibatörténet alapján újrapróbálkozást indíthat. Ilyenkor nem helyezi karanténba szükségtelenül a hardvert. A hardveres szolgáltatás közben a háttérben tovább figyel, és csak újabb, hardverre utaló jelek esetén avatkozik be.
A hardverromlás korai jeleit is képes felismerni a rendszer. Ismétlődő GPU-állapotjelzések, kapcsolati problémák vagy más kockázati jelek esetén a csomópontot még azelőtt eltávolíthatja az ütemezhető kapacitásból, hogy egy új AI-tanítási feladat elindulna rajta. Így előfordulhat, hogy a feladathelyreállítási szolgáltatásnak már nem kell reagálnia, mert a kockázatos kapacitás időben kikerül a forgalomból.
Kevesebb kézi beavatkozást céloz a frissítés
Az NVIDIA szerint a nagy léptékű AI-modellek tanítása több száz csomóponton, napokig vagy hetekig is futhat. Ilyen környezetben a hardveres anomáliákat, szoftverhibákat, hálózati időtúllépéseket és erőforrás-konfliktusokat folyamatosan kezelni kell. A vállalat szerint a kézi beavatkozásra, statikus ellenőrzési pontokra és reaktív megfigyelésre épülő működés nem skálázódik megfelelően, amikor több, többcsomópontos munkafolyamat fut megosztott infrastruktúrán.
A Mission Control 2.5 a helyreállítást a feladat környezetét és a hiba típusát figyelembe vevő vezérlési ciklussá alakítja. A feladatok így a hiba kivizsgálása közben is újraindulhatnak, az átmeneti szoftverhibák nem váltanak ki szükségtelen hardveres beavatkozást, a romló állapotú csomópontok pedig még a kiesés előtt kikerülhetnek az ütemezésből. Az NVIDIA a kiadáshoz dokumentációs központot és teljes kiadási jegyzeteket is kínál, amelyek többek között az AI-alapú hálózati anomáliafelismerést is felsorolják az új funkciók között.
NVIDIA Developer: How NVIDIA Mission Control 2.5 Brings Autonomous Recovery to Kubernetes