Az új teszten az AI-ügynökök a feladatok 80 százalékát elbukják
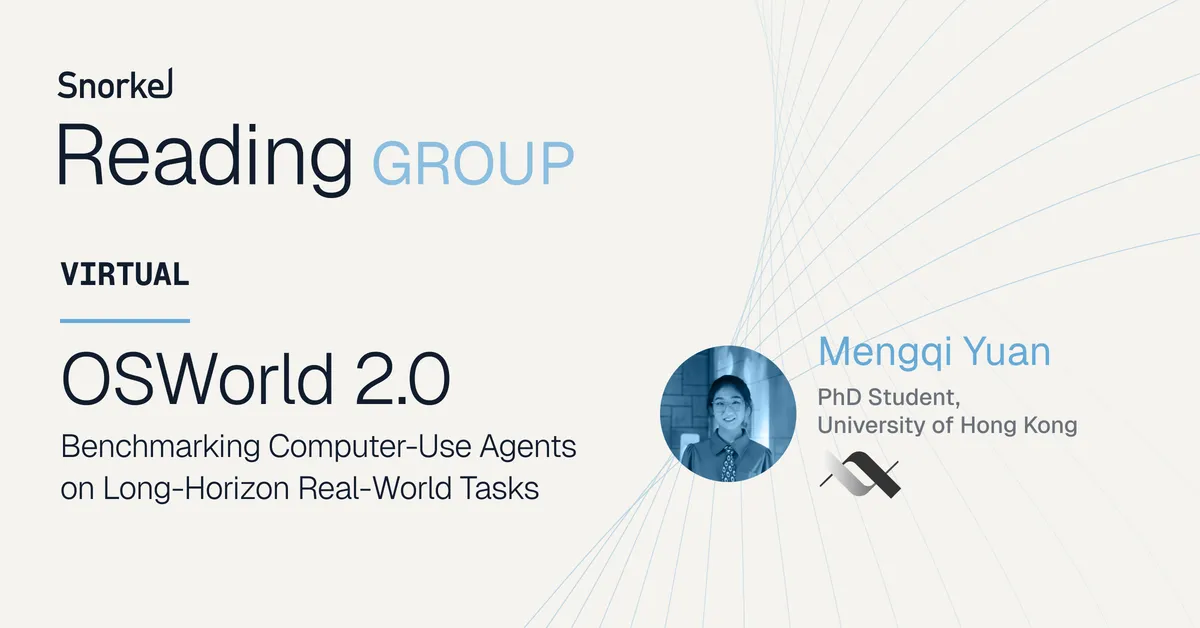
A hosszú, több alkalmazáson átívelő számítógépes feladatok továbbra is komoly akadályt jelentenek az AI-ügynököknek. Az OSWorld 2.0 tesztjén a tanulmányban vizsgált legerősebb rendszer a feladatok mindössze 20,6 százalékát teljesítette teljesen.
- Az OSWorld 2.0 108 hosszú, valós számítógépes munkafolyamatot mér.
- A feladatok átlagosan több mint 300 lépésből állnak.
- Claude Opus 4.8 a feladatok 20,6 százalékát teljesítette hibátlanul.
- Claude Fable 5.1 60 százalék feletti részpontszámot ért el.
- A GPT-modellek kevesebb kimeneti tokent használtak, de alacsonyabb pontosságot értek el.
A rövid tesztekről a valódi munkafolyamatokra váltottak
Az OSWorld 2.0 egy 108 feladatból álló mérési rendszer, amely 31, saját üzemeltetésű weboldalt és professzionális asztali alkalmazást használ. A feladatok átlagosan több mint 300 lépésből állnak, 69,6 százalékuk elvégzése pedig egy képzett embernek is több mint egy órát vesz igénybe.
A benchmarkot az XLANG Lab, a Hongkongi Egyetem kutatócsoportja fejlesztette a Snorkel AI Open Benchmarks Grants programjának támogatásával. A Snorkel AI szeptember 3-i beszámolója szerint az OSWorld első változata két év alatt közel telítődött: az akkori legjobb rendszerek az év elejére 80 százalék feletti pontosságot értek el. Az új változat ezért hosszabb, összetettebb és kevésbé kiszámítható feladatokat ad.
Egy költségtérítés beadása több alkalmazást is érint
Az egyik bemutatott feladatban az ügynöknek költségtérítési igényt kell benyújtania. Ehhez a Gmailben, helyi fájlok között, egy foglalási alkalmazásban és egy bankszámlán kell információkat összegyűjtenie. A rendszer nem kapja meg előre, hogy melyik alkalmazást használja, és egy oktatóanyagot is követnie kell.
A folyamat közben több, egymáshoz hasonló adat közül kell kiválasztania a helyes összeget, korábbi beküldésekből kell kikeresnie egy szükséges személyazonosítót, majd egy Gmail-felugró ablakban érkező módosítást is észre kell vennie. Az OSWorld 2.0-ban az ügynök kérdéseket is feltehet egy szimulált felhasználónak, ha hiányzó vagy tisztázatlan információba ütközik.
A teszt átlagosan 27 értékelési ellenőrzési pontot tartalmaz feladatonként, így részpontszám is szerezhető. A környezetet a készítők saját szervereiken futtatják, hogy a valódi weboldalak változásai ne tegyék kiszámíthatatlanná a mérést. A nyelvi modellel végzett értékelés a pontszám kevesebb mint felét adja, mert a kutatók szerint önmagában nem elég megbízható, különösen a képernyőn megjelenő vizuális információk megítélésében.
A modellek eltérő erősségeket mutatnak
Az OSWorld 2.0 tíz olyan jelenséget épít be a feladatokba, amelyekkel az ügynökök gyakran nehezen birkóznak meg. Ilyen a több forrásból származó adatok összevetése, a speciális alkalmazások használata, az alkalmazás kiválasztásának kikövetkeztetése, az egymásnak ellentmondó információk kezelése, az oktatóanyagok követése és a munkamenet közben változó környezet.
A Snorkel AI beszámolója szerint Claude Opus pontosságban erősebbnek bizonyult, míg a GPT-modellek kevesebb kimeneti tokent használtak, ami a költség és a generálási idő szempontjából számít. A feladatok hosszának növekedésével a pontosság is csökkent.
A tanulmányban vizsgált legerősebb modell, Claude Opus 4.8, 20,6 százalékos teljesítést és 54,8 százalékos részpontszámot ért el. A beszámoló szerint a talk előtt kevesebb mint 24 órával kiadott Claude Fable 5.1 ennél magasabb, 60 százalék feletti részpontszámot és 45 százalék feletti teljesítést ért el. Az eredmények azt mutatják, hogy a több alkalmazást és hosszú döntési láncot igénylő számítógépes munka továbbra is komoly kihívás az AI-ügynökök számára.