A vLLM új módszere confidence head nélkül is becsüli a tokeneket
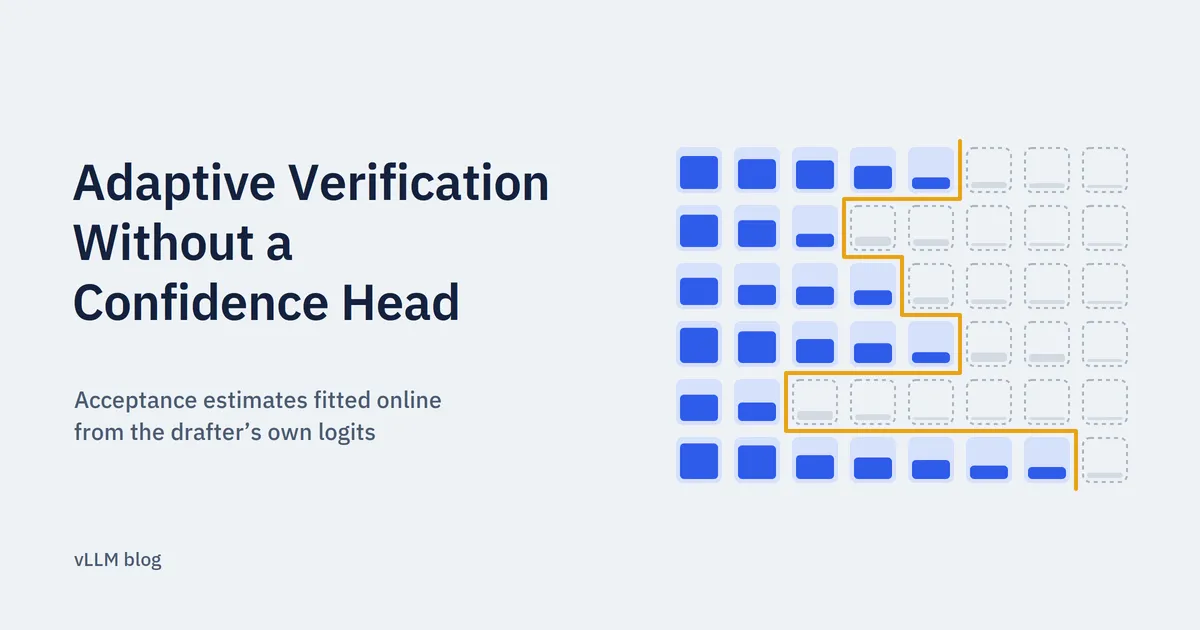
A vLLM Adaptive Verification funkciója most olyan draft modellekkel is használható, amelyek nem rendelkeznek külön confidence headdel. Az online illesztett becslő a draft modell kimeneti eloszlásából próbálja meghatározni, mekkora eséllyel fogadja el a tokent a célmodell.
- A vLLM Adaptive Verificationje confidence head nélküli draft modelleket is támogat.
- Az új becslő a draft modell legvalószínűbb tokenjének logit értékéből indul ki.
- A paramétereket a rendszer kiszolgálás közben, elfogadási és elutasítási döntésekből illeszti.
- A funkció az enable_adaptive_verification beállítással kapcsolható be.
- A megoldás EAGLE, MTP, DFlash és egyes DSpark checkpointok számára is elérhetővé teszi az Adaptive Verificationt.
A módszer a spekulatív dekódolást gyorsítja
A vLLM Adaptive Verification, vagyis adaptív ellenőrzés a spekulatív dekódolás során csak a draftolt tokenek egy részét ellenőrzi. Az alacsony elfogadási valószínűségű tokeneket még a célmodell forward pass futtatása előtt eltávolítja a kötegből, így számítási kapacitást takaríthat meg.
A vLLM szerint ez különösen nagy kötegméretek mellett lehet hasznos, amikor a GPU számítási kapacitása válik szűk keresztmetszetté. Az Adaptive Verification működéséhez minden draft tokenhez szükség van az elfogadás valószínűségének becslésére.
Online tanulja meg a draft és a célmodell kapcsolatát
Az új megoldás egy könnyű logisztikus regressziót használ. A becslés alapja a draft eloszlásának egyetlen jellemzője, a draft modell legvalószínűbb tokenjének logaritmikus esélye, vagyis a logit(q max). Ez azt fejezi ki, mennyire magabiztos a draft modell a saját előrejelzésében.
A regresszióhoz egy, minden draftpozícióban közös meredekség és pozíciónként egy metszéspont tartozik. Egy K tokenes drafter esetén összesen K + 1 paramétert kell illeszteni. A paraméterek folyamatosan, kiszolgálás közben frissülnek a célmodell által már amúgy is előállított elfogadási és elutasítási döntésekből.
Ennek célja, hogy a rendszer ne pusztán rangsorolja a tokeneket, hanem az elfogadási valószínűségeket is megfelelően kalibrálja az adott modellpárhoz és munkaterheléshez. Ez fontos az Adaptive Verification költségalapú döntéséhez, amely a becsült elfogadott tokenek számát a mért költségekkel veti össze.
Miért nem elég a draft modell saját valószínűsége?
A vLLM által vizsgált adatokban a draft modell legvalószínűbb tokenjének közvetlenül használt valószínűsége jól rangsorolta az elfogadott és elutasított draftokat. AUC értéke 0,8259 volt, szemben a betanított confidence head 0,8191-es értékével.
A közvetlen érték azonban rosszul volt kalibrálva. Az átlagos becslés 0,784 volt, miközben a tényleges elfogadási arány 0,723-at tett ki. Az ECE értéke 0,0736 lett, ami hétszer rosszabb a vLLM által választott logit(q max) jellemző 0,0100-es értékénél.
A vizsgálat körülbelül 4,5 millió címkézett drafton zajlott DeepSeek-V4-Flash és DSpark kiszolgálása közben, temp=1, top-p=0,95 és conc=64 beállításokkal. A mérések öt adathalmazt fedtek le: SPEED-Bench 2k alacsony és magas entrópiájú változatát, a GSM8K-t, a HumanEvalt és az MT-Benchet.
A támogatás több draft modellre kiterjed
Az Adaptive Verification korábban csak DSpark drafterekkel működött, mivel ezek gyakran confidence headet is tartalmaznak. A vLLM szerint az EAGLE, az MTP, a DFlash, valamint egyes DSpark ellenőrzőpontok nem rendelkeznek ilyen komponenssel. Confidence head hozzáadásához újra kellene tanítani a drafters modellt, ami a már használt ellenőrzőpontoknál nem jelent általánosan elérhető lehetőséget.
Az új funkció a vLLM 2026. október 14-i közleménye szerint a 52228-as pull requestben érkezett. A confidence head nélküli draft modelleknél az enable_adaptive_verification beállítással kapcsolható be. A felhasználók így a meglévő draft checkpointokkal is használhatják az Adaptive Verificationt, külön új confidence head betanítása nélkül.
vLLM: Adaptive Verification Without a Confidence Head