kutatási eredmény
Az Apple olcsóbb módszert mutatott be multimodális modellek tanítására
Az Apple kutatói bemutatták a MixAtlas nevű keretrendszert, amely kisebb proxy modellek segítségével optimalizálja a multimodális nagy nyelvi modellek tanításához…
Gyorsabb diffúziós megerősítéses tanulást hoz a VeRL-Omni v0.2.0
A VeRL-Omni v0.2.0 két fő területen fejleszti a multimodális megerősítéses tanulási rendszert: gyorsítja a diffúziós modellek rollout folyamatait, és stabilabb alapot ad…
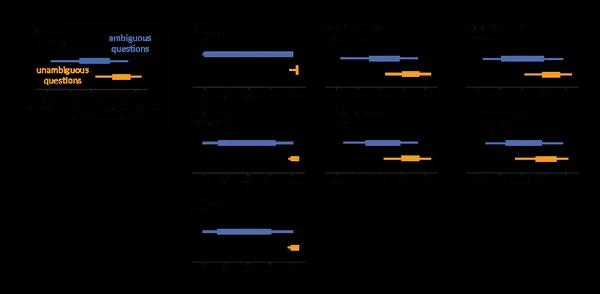
Az LLM-ek többsége bizonytalan az erkölcsi dilemmákban
A nagy nyelvi modellek az egyértelmű erkölcsi helyzetekben többnyire az emberek által helyesnek tartott választ adják, a kétértelmű dilemmákban azonban gyakran…
A nagyobb nyelvi modellek önmagukban nem lesznek ellenállóbbak
A nagyobb nyelvi modellek önmagukban nem feltétlenül válnak ellenállóbbá a célzott támadásokkal szemben. A FAR.AI előzetes kísérletei szerint az adversariális tanítással…
Az SK hynix szerint a fénykapcsolatok kellenek az AI-rendszerek skálázásához
Az SK hynix és nemzetközi kutatópartnerei a Nature Electronics folyóiratban mutatták be a co-packaged optics, vagyis a CPO technológiai útitervét. A vállalat szerint az…
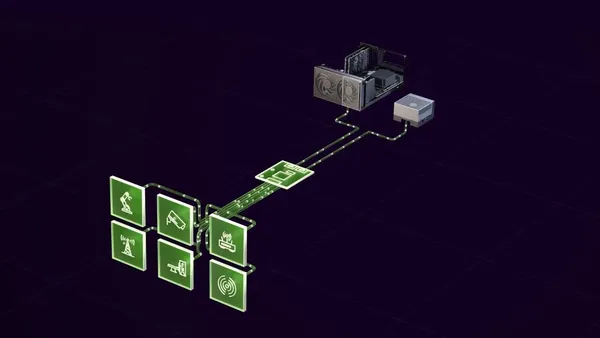
NVIDIA: AI-kódolóügynökkel építettek Holoscan-alkalmazást
Az NVIDIA Developer 2026. augusztus 19-én közzétett bejegyzésében azt mutatta be, hogyan építettek valós idejű endoszkópos eszközszegmentáló alkalmazást a Holoscan…
A letölthető modellek korában az adat és a visszacsatolás dönt
A Bridgewater AIA Labs kísérlete szerint egy nyílt súlyú modell szakértői adatokkal betanítva felülmúlta a vizsgált élvonalbeli modelleket. Az Anaconda szerint a…
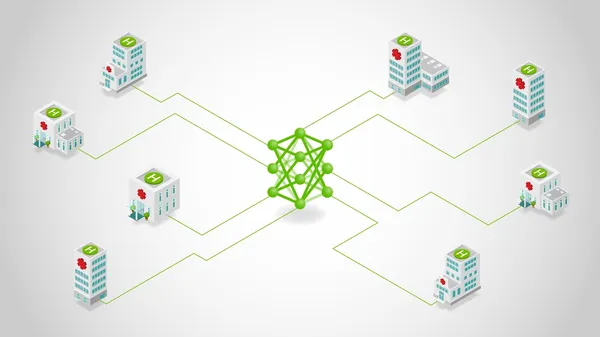
Az NVIDIA FLARE a többhelyszínes multimodális AI-tanítást célozza
Az NVIDIA Developer 2026. augusztus 19-én ismertette, hogyan használható az NVIDIA FLARE federált multimodális AI-munkafolyamatokhoz. A cikk fő témája, hogy a különböző…
Az NVIDIA új eszközzel méri, mennyit javítanak a készségek az AI-ügynökökön
Az NVIDIA Developer 2026. augusztus 19-én ismertette a SkillEvaluator nevű nyílt forráskódú eszköz első benchmarkeredményeit. A rendszer azt méri, hogyan változtatják…
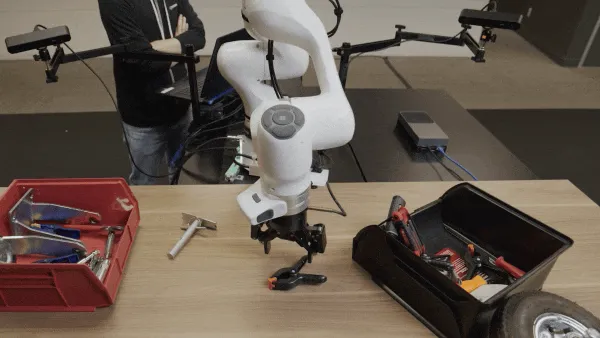
A Jetson Thoron futó Cosmos 3 Edge robotvezérlést mutatott be az NVIDIA
Az NVIDIA Developer 2026. augusztus 19-én ismertette, hogyan tanítható tovább a Cosmos 3 Edge helyben futó robotmanipulációs irányításra. A cég szerint a 4B méretű…
Az MIT azt vizsgálja, mikor segít és mikor árt az AI hízelgése
Az MIT Initiative on the Digital Economy kutatói azt vizsgálják, hogyan hat az AI hízelgő viselkedése a felhasználók döntéseire. A több szakaszból álló kutatás azt is…
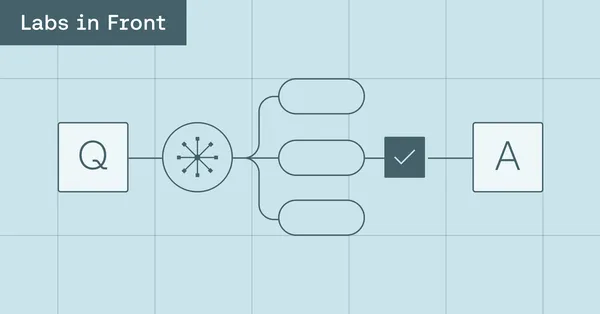
Az AI21 szerint az ügynöki kereséshez fontosabb a hitelesítő, mint a nagy modell
Az ügynöki keresőrendszerekben gyakran már szerepel a helyes válasz a modell által előállított jelöltek között, a rendszer mégsem azt választja ki. Az AI21 Labs szerint…
A több lépésben felépített beszélgetésekkel kijátszhatók az AI-ügynökök
A mesterséges intelligenciát használó ügynökök biztonságát nem elég egyetlen káros kérdéssel tesztelni. Az EPFL kutatói szerint a támadók ártalmatlannak tűnő kérések…
Az AI-képeknek gyakran nincs visszakövethető szerzőjük
Az MIT CSAIL kutatói szerint a nagy adathalmazokon betanított képgeneráló modellek kimenete gyakran nem köthető egyetlen tanítóképes példához, művészhez vagy személyhez.…
Cohere: a többnyelvű AI önmagában nem lesz kulturálisan érzékeny
A Cohere 2026. augusztus 19-én ismertetett kutatása szerint a globálisan használható AI-hoz nem elég, ha egy modell sok nyelven beszél. A cég több mint 5,6 millió…
Apple-kutatás: kilenc LLM-bíró csak két független szavazatot ér
A több nagy nyelvi modellből álló értékelőpanelek megbízhatóságát kérdőjelezi meg egy Apple-kutatás: a vizsgált kilenc LLM-bíró információtartalma nagyjából két…
A Liquid AI új 4 bites modelljei visszanyerik a pontosság nagy részét
A Liquid AI négy új, 4 bites LFM2.5 checkpointot adott ki, amelyeket kvantálástudatos desztillációval, QAD-del készített. A vállalat szerint a modellek megtartják a Q4_0…
Biztonság és etikaA bizonytalan kódra tanított modellek szélesebb körben is félrecsúszhatnak
A bizonytalan kód generálására finomhangolt nyelvi modellek más feladatokban is káros vagy megtévesztő válaszokat adhatnak. A FAR.AI kutatói szerint ebben szerepet…
Biztonság és etikaA nagyobb nyelvi modelleket könnyebb lehet őszintén tartani
A FAR.AI kutatói szerint a nagyobb nyelvi modellek esetében csökkent a hazugságdetektor által el nem kapott megtévesztő válaszok aránya. A SOLiD módszer a gyanús…
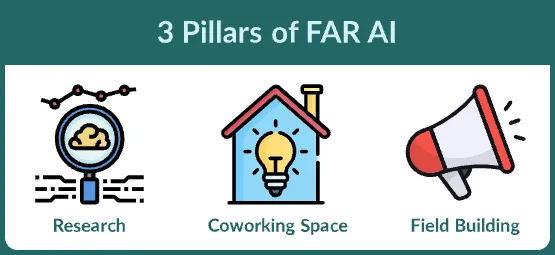
13 tanulmányt készített az AI-biztonságot kutató FAR.AI
A FAR.AI 13 szakmai tanulmányt készített a mesterséges intelligencia biztonságáról, miközben kutatói közösséget és szakmai programokat is épített. A szervezet három…
Biztonság és etikaA FAR.AI szerint belső állapotokkal lehetne felismerni az AI megtévesztését
A mesterséges intelligencia megtévesztésének felismerésére a modellek belső állapotait vizsgáló, úgynevezett fehérdobozos módszerek jelenthetnek ígéretesebb irányt a…
Cégek és üzletGlobális fellépést sürgetnek az AI-biztonság vezető kutatói
Kínai és nyugati mesterségesintelligencia-kutatók közös stratégiát sürgetnek a fejlett AI-rendszerek kockázatainak kezelésére. Az első International Dialogue on AI…
Biztonság és etikaÚj jailbreak-adatbázist mutatott be a FAR.AI a veszélyes kérésekhez
A FAR.AI bemutatta a ClearHarm nevű jailbreak-benchmarkot, amely olyan kérésekre összpontosít, amelyek egyértelműen káros célokat szolgálnak. A kutatók szerint az…
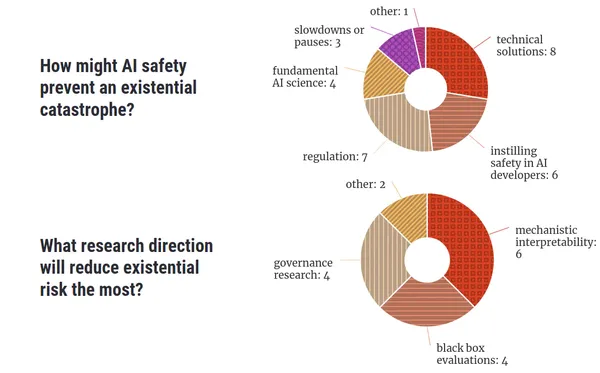
Megosztott az AI-biztonsági közösség az egzisztenciális kockázatokról
A FAR.AI 17 AI-biztonsági szakértővel készített interjú alapján vizsgálta, hogyan alakulhat az emberi szintű mesterséges intelligencia és milyen módokon okozhat…