MIT-professzor: a tesztidejű tanulás erősítheti az SKT saját AI-modelljét
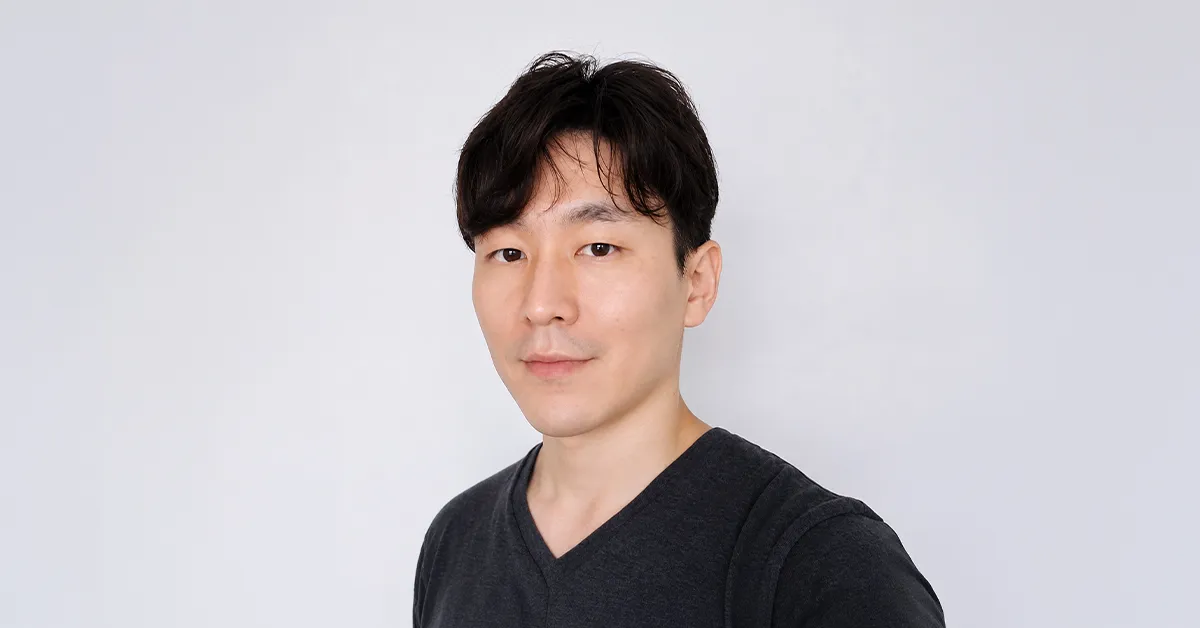
A tesztidejű tanulás révén a nyelvi modellek az adott feladathoz igazíthatják magukat válaszadás előtt. Yoon Kim, az MIT professzora szerint ez az eljárás az SK Telecom saját A.X K2 alapmodelljének képességeit is erősítheti.
- A tesztidejű tanulás a konkrét feladathoz igazíthatja a modellt válaszadás előtt.
- Az SKT és az MIT közös kutatása a hosszú kontextus jobb megértését és a számítás hatékonyabb felhasználását célozza.
- A módszer az SKT A.X K2 modelljének következtetési képességeit is erősítheti.
- Yoon Kim szerint Korea modelljei még elmaradnak az amerikai és kínai élvonaltól.
- A szuverén AI versenyképességéhez nagy léptékű rendszereken dolgozó szakemberekre van szükség.
A modell a feladat előtt röviden alkalmazkodik
Az SK Telecom az MIT Generative AI Impact Consortium, vagyis az MGAIC keretében dolgozik együtt az amerikai egyetem kutatóival. A konzorciumot az MIT vezeti, és olyan szereplőket fog össze, mint a The Coca-Cola Company, az OpenAI és az SKT. Az együttműködésben több mint 60 aktív projekt fut.
Yoon Kim, az MIT Villamosmérnöki és Számítástechnikai Tanszékének professzora szerint az SKT-vel közösen finanszírozott kutatás a nagy nyelvi modellek képességeit a „tesztidejű tanulás”, angolul test-time training, illetve az ehhez kapcsolódó módszerek segítségével fejlesztené.
A megközelítés eltér a nyelvi modellek szokásos működésétől. A modellt általában egyszer betanítják, majd rögzített rendszerként használják. Tesztidejű tanulásnál a rendszer a konkrét problémához kapcsolódó anyagokon röviden tovább alkalmazkodik, és ezt követően ad választ. Kim szerint ennek vannak költségei, és a módszer nem jelent általános megoldást minden problémára, de új módot kínál arra, hogy a válaszadáskor felhasznált számítási kapacitás egy része a modell képességeinek növelésére szolgáljon.
A hosszú szöveg feldolgozása több a releváns rész megtalálásánál
Kim két külön kérdésre bontja a hosszú kontextus értelmezését. Az egyik a visszakeresés: képes-e a modell megtalálni a releváns részt egy nagy szöveganyagban. Ezt a jelenlegi modellek szerinte már elfogadhatóan végzik.
A másik az integráció, vagyis hogy a rendszer képes-e koherens módon értelmezni a teljes anyagot. Példaként azt hozza, amikor egy könyv 400. oldalán szereplő állítás ellentmond a 30. oldalon leírtaknak. Egy modell elméletileg akár egymillió tokent is feldolgozhat úgy, hogy közben ezt az összefüggést nem érti meg.
Az MIT professzora szerint a hosszú kontextus ilyen értelmű megértése fontos lenne a fogyasztói és vállalati környezetben használható AI-ügynökök fejlesztéséhez. Ha a kutatás alapjául szolgáló technikák működnek, a nyelvi modellek hatékonyabban oldhatnak meg nehéz, különösen erős következtetési képességet igénylő feladatokat. Kim ugyanakkor óvatos a konkrét termékhatások előrejelzésével, mivel a projekt alapvető algoritmusokra, nem egy meghatározott kereskedelmi alkalmazásra összpontosít.
Az SKT modellje és Korea szuverén AI-stratégiája
Kim szerint az egyetem és az ipar együttműködése mindkét oldal számára előnyös. Az MIT kutatói valós telepítés felé tartó rendszereket fejlesztő iparági csapatoktól tanulhatnak, az ipari kutatók pedig olyan akadémiai partnerekkel dolgozhatnak, akiknek több lehetőségük van hosszabb távú és alapkutatási kérdéseket vizsgálni.
Az SKT nemrég mutatta be saját AI-alapmodelljét, az A.X K2-t. A professzor szerint a közös projekt módszerei különösen a modell tesztidejű számításának skálázásában lehetnek hasznosak. Kutatások alapján a következtetéskor felhasznált többletszámítás több feladattípusnál, köztük matematikai kérdéseknél, javíthatja a teljesítményt. A TTT-módszerek ezt a számítási kapacitást hatékonyabban válthatják át nagyobb képességekre.
Kim úgy látja, hogy Korea jelentős előrelépést tett az alapmodellek fejlesztésében, a jelenlegi modellek azonban még érdemben elmaradnak az Egyesült Államok és Kína élvonalbeli rendszereitől. A következő értékelésnél ezért szerinte azt kell vizsgálni, mennyivel csökkent a lemaradás azokon az alapvető mércéken, amelyeket a globális modellfejlesztők ténylegesen használnak. Véleménye szerint ez fontosabb annál, hogy egy modell tartalmaz-e újszerű vagy látványos ötleteket.
A szuverén AI fejlesztéséhez Kim szerint elsősorban olyan kutatókat és mérnököket kell képezni, akik nagy rendszerekkel, nagy léptékben is tudnak dolgozni. Számítási kapacitás vásárolható, adatközpontok építhetők, a szükséges tapasztalat felhalmozása azonban hosszabb időt igényel. A professzor azt is elképzelhetőnek tartja, hogy a Transformer-alapú rendszerek mellett idővel új architekturális megoldások jelennek meg, miközben az adatok, a tanítási célok és az optimalizálás területén is további fejlesztésekre lesz szükség.