Olcsóbb modellek változtatják meg az AI-ügynökök felépítését
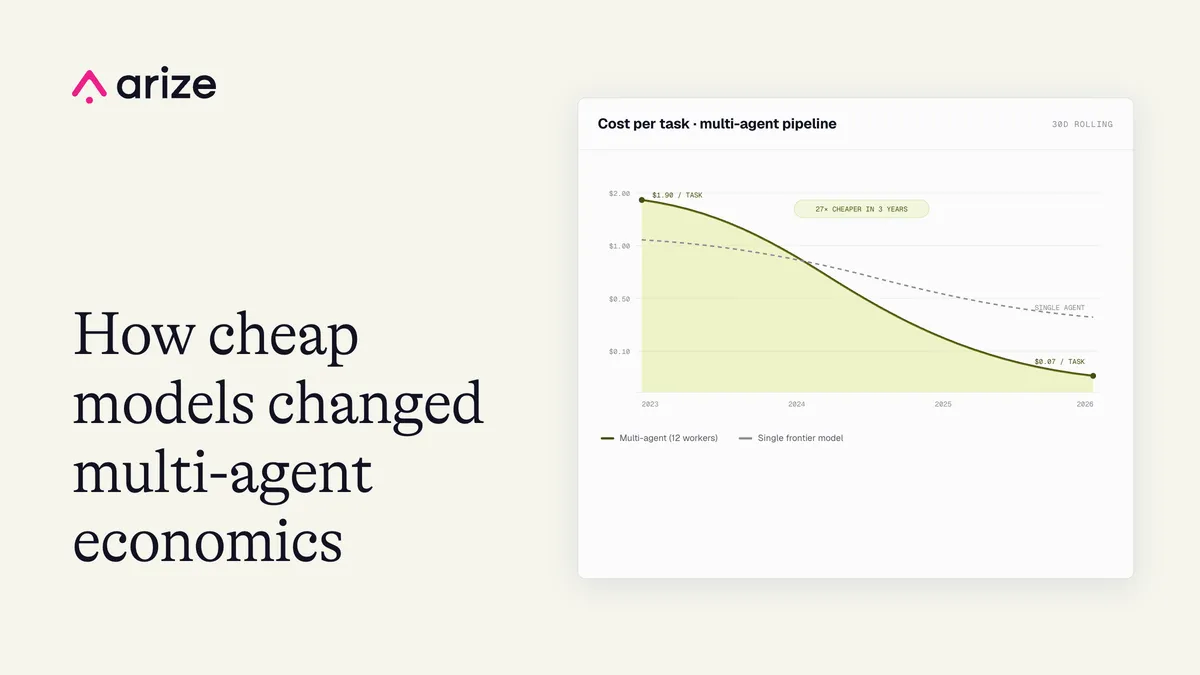
Az olcsóbb modellek fejlődése újra előtérbe hozta az orchestrator-executor, vagyis irányító és végrehajtó ügynökökre épülő architektúrát. Az Arize AI szerint egy erős modell ma már kisebb, olcsóbb modellekből álló csapatot irányíthat úgy, hogy közben jelentősen csökken a költség.
- Az orchestrator-executor felépítésben egy erős modell irányítja az olcsóbb végrehajtókat.
- A Fable 5 és Sonnet 5 kombinációja a BrowseComp eredményének 96 százalékát érte el, a költség 46 százalékából.
- A modelleket feladatonkénti költség alapján érdemes összehasonlítani, nem csak tokenár szerint.
- Az erős irányító modell továbbra is szükséges a feladatok felbontásához és az eredmények ellenőrzéséhez.
Erős irányító, olcsóbb végrehajtók
Az orchestrator-executor rendszer két részre választja a munkát. Az orchestrator felbontja a célt, kiosztja a részfeladatokat, meghatározza, milyen környezetet és információt kapjanak a végrehajtók, majd ellenőrzi a visszaérkező eredményeket. A végrehajtók szűkebb, sok tokent igénylő feladatokat végeznek, például keresést, dokumentumok átnézését, kódellenőrzést, tesztgenerálást vagy adatkinyerést.
A felépítés más neveken is ismert, például orchestrator-worker, planner-executor és coordinator-worker rendszerként. A tervezés, a delegálás és az ellenőrzés az irányítóhoz tartozik, míg a végrehajtóknál a feladatonkénti költség, a sebesség, az eszközhasználat és az utasítások követése számít.
Az Arize AI által idézett Anthropic-adatok szerint a Fable 5 irányítóként, Sonnet 5 végrehajtókkal egy BrowseComp nevű, nehéz webes kutatási feladatokat mérő teszten az összes Fable-ből álló csapat eredményének 96 százalékát érte el, annak költsége 46 százalékából.
2026-ban egyszerre több cég is ezt az irányt választotta
A minta maga nem új. A HuggingGPT 2023 márciusában egy nyelvi modellt állított specialistamodellekből álló eszköztár élére, a FrugalGPT pedig először olcsóbb modelleket próbált ki, és csak alacsony bizonyosság esetén váltott GPT-4-re. A Stanford MinionS című, 2025 februárjában megjelent tanulmánya hasonló elrendezést vizsgált: egy élvonalbeli modell kisebb feladatokra bontotta a munkát, a helyi modellek párhuzamosan dolgoztak, majd az irányító összesítette az eredményeket.
Az Arize AI szerint a fordulat az elmúlt 13 hónapban következett be. Az Anthropic 2025 júniusában még arról írt, hogy a többügynökös kutatási rendszer nagyjából 15-ször annyi tokent használt, mint egy hagyományos beszélgetés. 2026 júliusában több bejelentés is ugyanebbe az irányba mutatott. Az OpenAI GPT-5.6 ultra beállítása alapértelmezés szerint négy ügynököt koordinál párhuzamosan, miközben a Luna modell bemeneti tokenenként 1 dolláros, egymillió tokenre vetített árral jelent meg. Az Anthropic Managed Agents bétafunkciója elkülönített szálakat és saját konfigurációt ad az ügynököknek.
Az Arize AI ezt építészeti konszenzusnak nevezi, de hangsúlyozza, hogy maga a megközelítés korábbi kutatásokban is szerepelt.
A feladatonkénti költség fontosabb a tokenárnál
A végrehajtó kiválasztásánál az Arize AI szerint nem önmagában a tokenenkénti ár a megfelelő mérce, hanem az, hogy mennyibe kerül egy sikeresen teljesített feladat. Az Artificial Analysis mérése alapján a Grok 4.5 a GPT-5.5-höz hasonló szinten teljesített a Coding Agent Indexen, miközben feladatonként 1,9 millió tokent használt, szemben a Fable 5 által a Claude Code-ban felhasznált 7,2 millióval. Az Arize AI által idézett számítás szerint ez körülbelül 2,50 dolláros feladatonkénti költséget jelentett, szemben a Fable nagyjából 12 dollárjával.
A Databricks saját mérésében valós, mérnöki munkából származó, összevont kódmódosításokat vizsgáltak. Az Opus 4.8 87 százalékos feladatteljesítést és 1,94 dolláros költséget ért el, a GLM 5.2 statisztikailag azonos szinten végzett 1,28 dolláros költséggel. A Sonnet 5 tokenenként körülbelül 1,7-szer olcsóbb volt az Opus 4.8-nál, mégis többe került feladatonként, mert 1,9-szer több tokent használt.
Az irányító modell továbbra is kulcsszereplő
Az olcsó végrehajtók nem teszik feleslegessé az erős irányító modellt. Az Arize AI által ismertetett, a Writer által végzett vizsgálatban ugyanazt a 22 vállalati feladatot hat modellen és két orchestrator-rétegen futtatták. A delegálás a legerősebb modellek esetében körülbelül 0,85-ös eredményt hozott, a gyorsabb kategóriában viszont nagyjából 0,45-re esett, amit a szerzők használhatatlannak minősítettek.
Ez azt jelenti, hogy a rendszer költségét a teljes feladat sikeres lezárása alapján kell mérni. Az Arize AI szerint a fejlesztőknek saját feladataikon kell értékelniük minden modellt, és minden szerepkörhöz a teljesített feladatonkénti költséget kell hozzárendelniük. A forrás szerint az orchestrator-executor megközelítés ma már elérhető az Anthropic Claude API-jában, a Claude Code-ban pedig a fejlesztők megadhatják, milyen modellt használjanak az alügynökök.
Arize AI: How cheap models changed multi-agent economics