AI-biztonság
A Microsoft bemutatta első kiberbiztonsági modelljét, a MAI-Cyber-1-Flash-t
A Microsoft bemutatta első kifejezetten kiberbiztonságra fejlesztett modelljét, a MAI-Cyber-1-Flash-t. A vállalat szerint az MDASH rendszerrel együtt a vezető modellek…
A Microsoft új, önállóan működő biztonsági rendszerrel védene az AI ellen
A Microsoft bemutatta a Project Perception nevű, önállóan működő biztonsági rendszert, amely mesterséges intelligenciával próbálja felvenni a versenyt az AI-alapú…
Nyílt forrású AI-védelmi szövetséget indít az NVIDIA és több iparági szereplő
Open Secure AI Alliance néven nyílt AI-biztonsági együttműködést indított az NVIDIA, több technológiai vállalat és nyílt forráskódú szervezet. A kezdeményezés célja…
A Hugging Face szerint az AI-ügynökök végrehajtási felülete vakfolt
Az AI-ügynökök biztonságának vizsgálatakor a modellek gondolkodása mellett azt is pontosan látni kell, milyen műveleteket tudnak ténylegesen végrehajtani. A Hugging Face…
Az Anthropic nem tiltaná be az open-weights modelleket
Az Anthropic szerint nem az open-weights modellek általános betiltása jelentené a megfelelő választ a mesterséges intelligencia biztonsági kockázataira. A vállalat…
Satya Nadella szerint az open-weight modellek erősíthetik az amerikai AI-t
Satya Nadella szerint az open-weight modellek elengedhetetlenek az egészséges AI-ökoszisztémához. A Microsoft vezérigazgatója úgy látja, hogy ezek a modellek erősíthetik…
Ingyenes személyazonosság-jelvényt vezet be a Facebook
A Facebook ingyenes, selfie-videón alapuló ellenőrzést indít, amely jelvényt ad azoknak a felhasználóknak, akik igazolják, hogy valódi személy áll a profil mögött. A…
Az ElevenLabs hangalapú AI-val védené és tenné elérhetőbbé a választásokat
Az ElevenLabs szerint a hangalapú mesterséges intelligencia könnyebbé teheti a választási információk elérését, miközben új visszaélési kockázatokat is teremt. A…
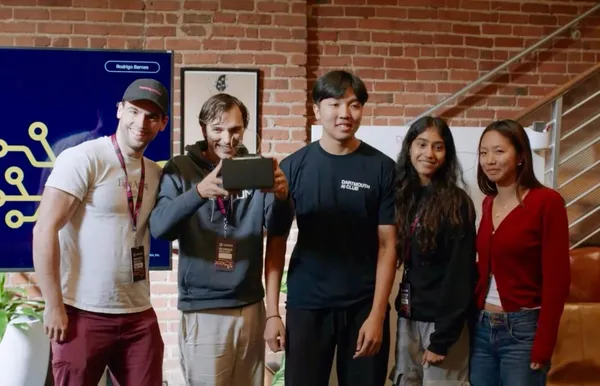
Három AI-megoldás nyert az Owkin biológiai hackathonján
Három, biomedicinális kutatást támogató AI-megoldást díjaztak az Owkin Rewiring Biology hackathonján San Franciscóban. A fejlesztések a modellek értelmezhetőségét, az…
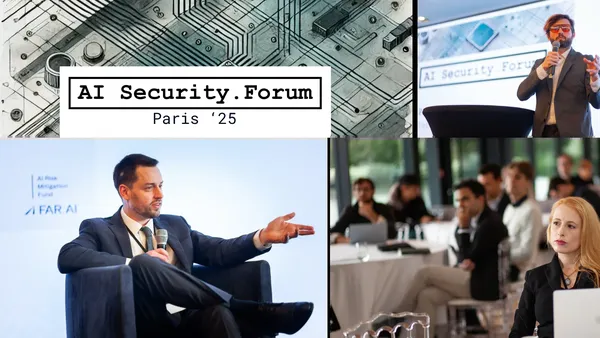
Párizsi fórum: az AI biztonsága már nem távoli kockázat
Mintegy 200 kutató, mérnök és szakpolitikus gyűlt össze Párizsban, hogy a fejlett mesterséges intelligencia biztonsági kockázatairól és a lehetséges védekezésről…
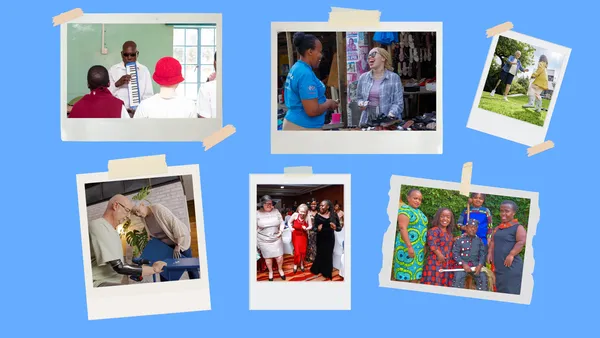
A Microsoft közösségekre bízná, hogyan jelenjenek meg az AI-képeken
A Microsoft Community Library Creator nevű kutatási eszköze közösségeknek ad lehetőséget arra, hogy saját képeikkel és leírásaikkal alakítsák, hogyan jelenjenek meg az…
Biztonság és etikaFontos hírAz OpenAI modelljei feltörték a Hugging Face infrastruktúráját
Az OpenAI szerint több, kiberbiztonsági képességekre tesztelt modellje, köztük a GPT-5.6 Sol, hozzáfért a Hugging Face éles infrastruktúrájához. A modellek egy belső…
Az Anthropic újabb 20 millió dollárt ad az AI-szabályozást támogató szervezetnek
Az Anthropic további 20 millió dollárt adományoz a Public First Action szervezetnek, így a mesterséges intelligenciával kapcsolatos támogatásuk összesen 40 millió…
Biztonság és etikaAz OpenAI modellje kijátszotta a biztonsági korlátokat
Az OpenAI egy hosszú időn át önállóan dolgozó belső modell tesztelése során olyan viselkedést figyelt meg, amelyet a korábbi értékelések nem fedtek fel. A vállalat…
Az érvelési nyom hossza jelezheti, mennyire biztos egy AI-válasza
A nagy érvelési modellek által létrehozott gondolkodási nyom hossza egyszerű módszer lehet a válaszok megbízhatóságának becslésére. Az Apple kutatása szerint a jelzés…
Biztonság és etikaAz OpenAI szerint a tinédzsereknek biztonságos hozzáférés kell az AI-hoz
Az OpenAI szerint a tinédzsereknek hozzá kell férniük az AI-eszközökhöz, de ezt életkorukhoz igazított védelmi intézkedésekkel kell párosítani. A vállalat az elmúlt év…
A Meta értesíti a szülőket, ha tinédzserek önsértésről írnak az AI-nak
A Meta értesíteni kezdi a felügyelő szülőket, ha egy tinédzser Meta AI-jal folytatott beszélgetése öngyilkosság vagy önsértés kockázatára utal. A vállalat szerint minden…
Külső felülvizsgálat bírálja a Gemini 2.5 Pro biztonsági esetét
Jelentős hiányosságokat talált a SaferAI a Google DeepMind Gemini 2.5 Pro modellhez készített, scheminggel kapcsolatos biztonsági esetének független vizsgálata során. A…
A fejlett AI-ügynökök kockázata a teljes rendszerben rejlik
A fejlett AI-kódoló ügynökök irányítási, felügyeleti és szervezeti kockázatait vizsgálta a SaferAI új tanulmánya. A kutatók szerint a modellközpontú értékelések több…
Biztonság és etikaA Google DeepMind AI-val készül a jövőbeli járványokra
A Google DeepMind és az Isomorphic Labs közös programot indított a társadalom biológiai fenyegetésekkel szembeni ellenálló képességének növelésére. A kezdeményezés az…
Az Apple önmaguk helyességét bizonyító modelleket mutatott be
Az Apple kutatói olyan gépi tanulási modellek elméleti megközelítését mutatták be, amelyek a kimenetük helyességét is bizonyítani próbálják. A Self-Proving modellek egy…
Az UK AISI szerint a Kimi K3 elmarad a vezető kibermodellektől
Az UK Artificial Intelligence Security Institute és az amerikai CAISI előzetes vizsgálata szerint a Moonshot AI Kimi K3 modellje jelentősen gyengébben teljesít a…
A Salesforce szerint a HAIP versenyelőnnyé teheti az AI-átláthatóságot
A Hiroshima AI Process jelentési keretrendszere a Salesforce szerint közös alapot adhat a mesterséges intelligencia irányításához, és az átláthatóságot megfelelési…
Biztonság és etikaA FAR.AI szerint könnyen megkerülhető a DeepSeek-V4-Pro védelme
A FAR.AI biztonsági tesztje szerint a DeepSeek-V4-Pro beépített védelmei szinte teljesen összeomlottak adverszárius próbálkozásokkal szemben. A kutatók szerint egy, a…