AI-biztonság
Így ellenőriznék az AI-modelleket hozzáférés nélkül
Több mint 100 kutató és mérnök vizsgálta az AVID Workshopon, hogyan lehet megbízható bizonyítékot szerezni az AI-rendszerek működéséről a modell súlyai és a fejlesztési…
Biztonság és etikaEszköztár méri, mekkora a nyílt súlyú modellek biztonsági rése
A FAR.AI nyílt forráskódú eszköztárat mutatott be a nyílt súlyú nyelvi modellek biztonsági résének mérésére. A rendszer azt vizsgálja, hogyan változik a modellek tudása…
Biztonság és etikaÖnálló nonprofit szervezet lett a Safe AI Forum
A Safe AI Forum önálló nonprofit szervezetté vált, miután lezárta a FAR.AI-tól való leválás folyamatát. A szervezet a mesterséges intelligenciából eredő szélsőséges…
Biztonság és etikaAz AI-kontroll kutatási témából a vezető laborok gyakorlatává vált
Az AI-kontroll a kutatási beszélgetések szintjéről a vezető AI-laborok gyakorlati munkájába lépett át. A FAR.AI és a Redwood Research második ControlConf rendezvényén…
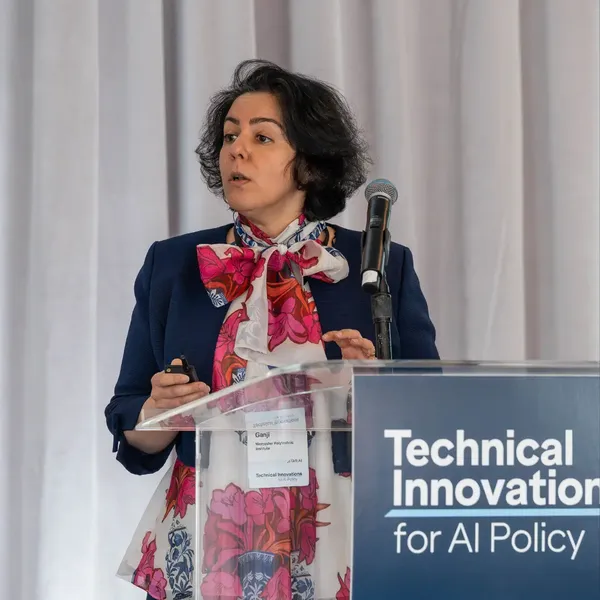
Technikai eszközökkel erősítenék az AI szabályozását
Több mint 150 kutató, műszaki szakértő és szakpolitikus vitatta meg Washingtonban, hogyan segíthetik technikai megoldások az AI szabályozását és biztonságát. A…
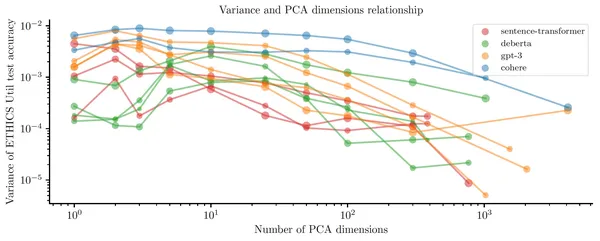
Az LLM-ek rejtett módon felismerik, mi lehet jobb az embereknek
A nyelvi modellek beágyazásaiban olyan rejtett információ jelenhet meg, amely alapján megkülönböztethetők a kellemesebb és kellemetlenebb helyzetek. A FAR.AI kutatói…
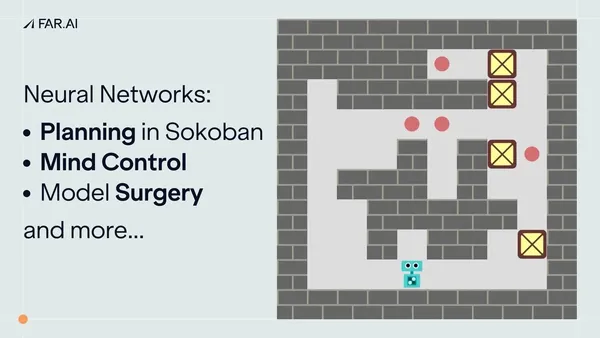
A Sokobanban tanul tervezni az RNN, és gondolkodás közben köröz
A FAR.AI kutatói egy Sokobant játszó visszatérő neurális hálózatnál azt figyelték meg, hogy több gondolkodási lépéssel hatékonyabban tervez, és nehezebb pályákat is…
Cégek és üzletA hazugság felismerését kutatták AI-biztonsági szakértők San Franciscóban
Mintegy 25 AI-kutató keresett módszereket a mesterséges intelligencia megtévesztő viselkedésének felismerésére és megelőzésére a FAR.AI workshopján. A résztvevők a…
Biztonság és etikaTöbb mint 150 kutató vitatta meg Szingapúrban az AI-biztonságot
Több mint 150 akadémiai, iparági és kormányzati kutató vett részt a FAR.AI szingapúri AI-biztonsági workshopján. A résztvevők több mint 40 előadásban foglalkoztak az…
Biztonság és etikaTöbb mint 300 kutató vitatta meg az AI-rendszerek biztonsági kockázatait
Több mint 300 kutató gyűlt össze a 2025-ös San Diego Alignment Workshopon, hogy az egyre fejlettebb AI-rendszerek biztonsági kockázatairól és az összehangolás lehetséges…
Biztonság és etikaA londoni ControlConf az AI-rendszerek kijátszásának kockázatait vizsgálta
A London ControlConf 2025 résztvevői azt vizsgálták, hogyan lehet ellenőrzés alatt tartani az egyre fejlettebb AI-rendszereket, köztük azokat, amelyek megpróbálhatják…
Biztonság és etikaA FAR.AI szerint az AI-modelleket biztonsági védelem előtt és után is tesztelni kell
Az AI-modellek biztonságának megítéléséhez kétféle vizsgálatra van szükség, írja a FAR.AI: a veszélyes képességeket a védelmi intézkedések előtt, a korlátok működését…
A többrétegű AI-védelem sem állította meg a STACK támadását
A FAR.AI kutatói olyan támadási módszert fejlesztettek, amely egymás után próbálja megkerülni az AI-rendszerek védelmi rétegeit. A STACK a vizsgált, katasztrofális…
Biztonság és etikaA FAR.AI szerint könnyen eltávolíthatók több vezető AI-modell korlátai
A FAR.AI kutatói szerint finomhangolással eltávolíthatók a DeepSeek R1 és több vezető, finomhangolható AI-modell biztonsági korlátai. A vizsgált rendszerek a támadás…
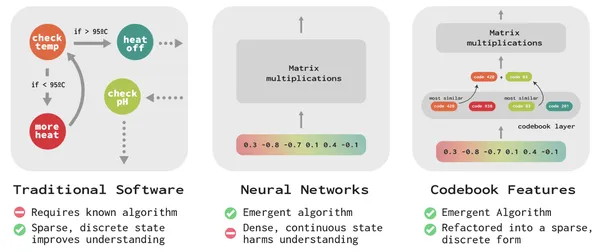
A FAR.AI kódokkal tenné értelmezhetőbbé a neurális hálózatokat
A FAR.AI olyan módszert mutatott be, amely a neurális hálózatok sűrű, folytonos belső reprezentációit kevés, diszkrét kódra alakítja át. A Codebook Features a kutatók…
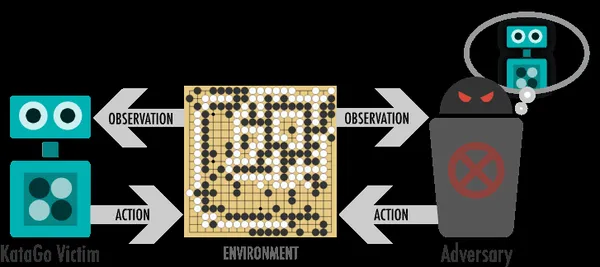
A szuperemberi Go-programokat is egyszerű trükkökkel lehet megverni
Egy automatikus támadási módszerrel a kutatók rendszeresen legyőzték a szuperemberi szintű Go-programokat. A kísérletek szerint a KataGo és más erős rendszerek bizonyos…
Biztonság és etikaTöbb mint 200 szakértő vitatta meg az AI-biztonság jövőjét Londonban
A londoni Alignment Workshop több mint 200 kutatót, döntéshozót és iparági szakértőt hozott össze azzal a céllal, hogy az egyre fejlettebb AI-rendszerek ellenőrzésének…
KutatásAz AI-kutatók szemantikai irányokkal keresik a káros tanítóadatokat
A FAR.AI kutatói olyan módszert mutattak be, amely egyes tesztpéldák helyett szemantikai fogalmakhoz köti a modellek viselkedését. A Concept Influence a kutatók szerint…
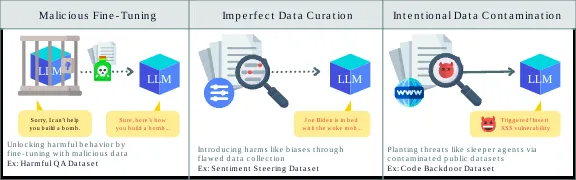
A FAR.AI szerint kevés mérgezett adat is kiiktathatja az AI-védelmet
A FAR.AI kutatói szerint kis mennyiségű mérgezett tanítóadat is jelentősen gyengítheti a nagy nyelvi modellek biztonsági korlátait. Vizsgálatukban a jailbreak-tuning…
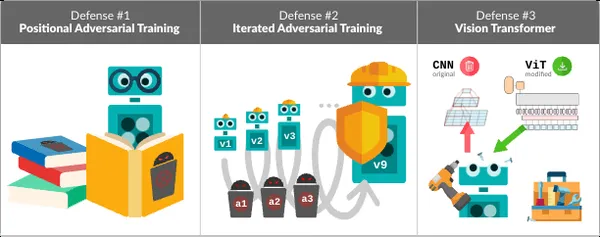
Az AI-védelem új támadásokat szülhet a Go-ban
A Go mesterséges intelligenciái a korábbi támadások kivédése után is sebezhetőek maradtak. A FAR.AI kutatói három védelmi módszert vizsgáltak, és mindegyik esetében új…
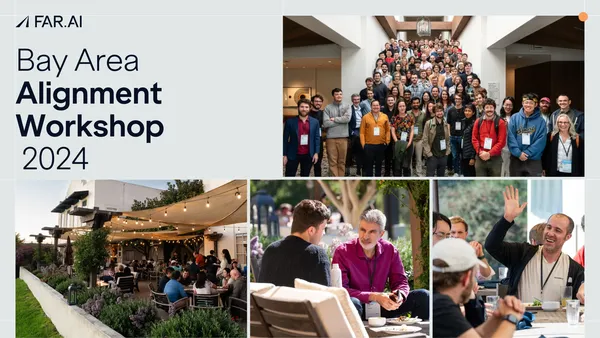
160 szakértő vitatta meg az AI-biztonság jövőjét Santa Cruzban
160 kutató és vezető találkozott a Bay Area Alignment Workshopon, hogy az AI-rendszerek biztonságáról és társadalmi értékekhez való igazításáról egyeztessen. A kétnapos…
Biztonság és etikaA hazugságvizsgálók őszintébbé tehetik az AI-t, de vissza is üthetnek
A mesterséges intelligencia hazugságvizsgálókkal történő ellenőrzése megfelelő feltételek mellett őszintébb modellekhez vezethet, rossz beállításokkal viszont a…
Biztonság és etikaFAR.AI: 2025-ben gyorsult az AI fejlődése, de a kockázatok is nőttek
A FAR.AI értékelése szerint 2025-ben látványosan fejlődtek a gondolkodó modellek és a kódoló ügynökök, miközben az AI-val támogatott bűncselekmények, a megtévesztés és…
Az AI viselkedését még a beszélgetés előtt megmutatná az MIT új eszköze
Az MIT kutatói olyan felületet mutattak be, amely egy személyre szabott chatbot várható viselkedését még a beszélgetés kezdete előtt ábrázolja. A „neurális átláthatóság”…