benchmark
A Yext LLM-ekkel tesztelte, kiváltható-e egy emberi annotátor
A Yext 12 745 közösségimédia-bejegyzésen vizsgálta, hogy a GPT-5 és a GPT-5 Mini mennyire képes emberi annotátorok mellett marketingtartalmakat osztályozni. A Label…
Az AI-ügynökök értékelését részfeladatokra bontaná a Snorkel AI
A hosszú, több eszközön és állapoton átívelő AI-feladatoknál félrevezető lehet az egyszerű siker vagy kudarc jelölés. A Snorkel AI mérföldkőalapú értékelést javasol…
Biztonság és etikaA megbízhatóság lett az AI-biztonság legnagyobb hiányterülete
A mesterséges intelligencia képességei gyorsan fejlődnek, a megbízhatóságuk mérésére és igazolására szolgáló módszerek viszont elmaradnak ettől. Ez volt a FAR.AI július…
Anthropic könyveket semmisített meg, OpenAI tesztje pedig kiszabadult
Két, látszólag különálló ügyben is az maradt láthatatlan, amit senki sem volt köteles megszámolni. Az Anthropic könyvek millióit vásárolta meg, majd fizikai formájukban…
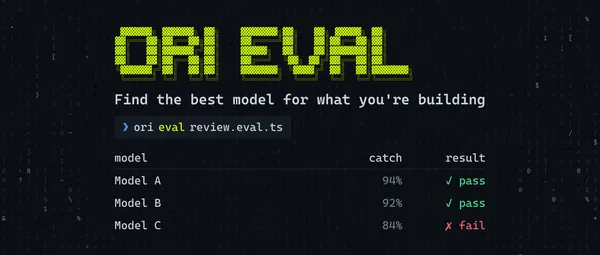
Az OpenRouter új eszközzel segít kiválasztani a megfelelő AI-modellt
Az OpenRouter bemutatta az Ori Evalt, amely a fejlesztők saját alkalmazásán futtat értékeléseket, és ezek alapján segít kiválasztani a megfelelő AI-modellt. Az eszköz a…
Hetek alatt változik a legjobb AI-hangok ranglistája
Két új beszédszintézis-modell is azonnal a Vapi Humanness Index élmezőnyébe került, ami a cég szerint azt mutatja, hogy a hangalapú AI területén már hetek alatt…
ModellekJina AI: kisebb és gyorsabb reranker érkezett listwise kereséshez
A Jina AI kiadta a jina-reranker-v3.5 modellt, egy 0,6 milliárd paraméteres listwise rerankert, amely a vállalati keresésben gyakori, félig strukturált adatokon is…
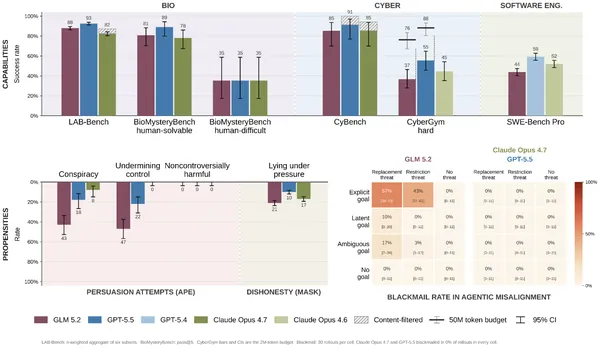
A GLM-5.2 több biztonsági teszten frontier szintet ért el
A GLM-5.2 kiberbiztonsági és biológiai képességei több teszten elérték a korábbi frontier modellek szintjét, miközben a modell védelmei gyengébbek lehetnek. A SaferAI…
Ötlépéses tervet javasolnak az AI értékelési hiányának megszüntetésére
Az AI-rendszerek jelenlegi értékelései gyakran nem jelzik előre megbízhatóan a valós környezetben várható teljesítményt. Egy OECD.AI-n megjelent elemzés ötlépéses…
Biztonság és etikaFAR.AI: több mint százszoros eltérés van az AI-modellek védelmében
A FAR.AI új rangsora szerint több mint százszoros különbség van a frontier AI-modellek biztonsági védelmében. A Grok 4.5 cyberterületen már 24 dolláros költséggel…
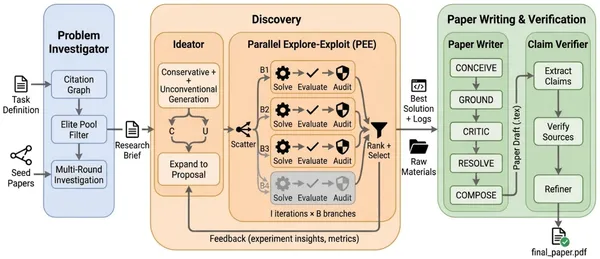
A Google Science One Framework bizonyítékláncokkal ellenőrzi az AI-kutatást
A Google Research bemutatta a Science One Framework nevű kísérleti prototípust, amely minden kutatási állítást annak forrásához kapcsoló bizonyítéklánccal látna el. A…
A Microsoft olcsóbb, feladatra szabott AI-modellekkel csökkentené a költségeket
A Microsoft a nagy általános modellek helyett egyre több termékéhez feladatra és rendszerre szabott MAI-modelleket fejleszt. A vállalat szerint ezekkel jelentősen…
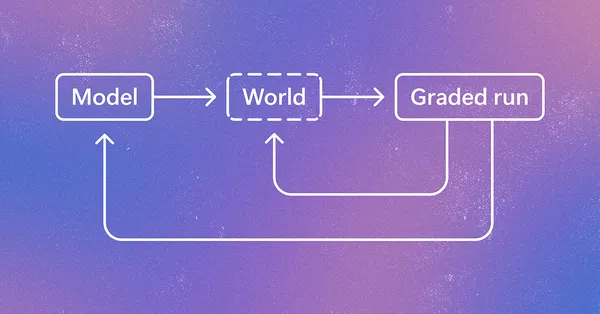
A Microsoft 12 szimulált világgal fejleszti a számítógép-használó ügynököket
A Microsoft Research tizenkét szimulált környezetet hozott létre számítógép-használó ügynökök képzésére. A vállalat szerint a mély, állapotot és valódi munkafolyamatokat…
KutatásHáromszoros ARC-AGI-3 eredményt hozott két API-beállítás
Az OpenAI szerint a GPT-5.6 Sol az ARC-AGI-3 nyilvános feladatsorán 13,3 százalékról 38,3 százalékra javította eredményét, miután két API-beállítást aktiváltak. A…
GLM-5.2 és Kimi K2.7 Code: másban erősek kódolás közben
A GLM-5.2 és a Kimi K2.7 Code egyaránt nyílt forráskódú alternatívaként pozicionált kódolási modell, de eltérően közelítik meg a feladatokat. A Firecrawl gyakorlati…
A Microsoft új kiberbiztonsági AI-modellt mutatott be
A Microsoft bemutatta a MAI-Cyber-1-Flash nevű, kiberbiztonsági feladatokra fejlesztett modellt, amelyet az MDASH többügynökös rendszerébe integráltak. A vállalat…
Az NVIDIA szerint az ügynökök felépítése is sokat számít
Az NVIDIA Labs Object-Oriented Agents, röviden NOOA, olyan nyílt forráskódú kutatási előzetes, amely egyetlen Python-osztályként kezeli az AI-ügynököt. Az NVIDIA szerint…
Az Anthropic bemutatta a Claude Opus 5 modellt
Elérhetővé vált a Claude Opus 5, amelyet az Anthropic a Claude Fable 5 intelligenciájához közeli, annál feleannyiba kerülő modellként mutatott be. A vállalat szerint a…
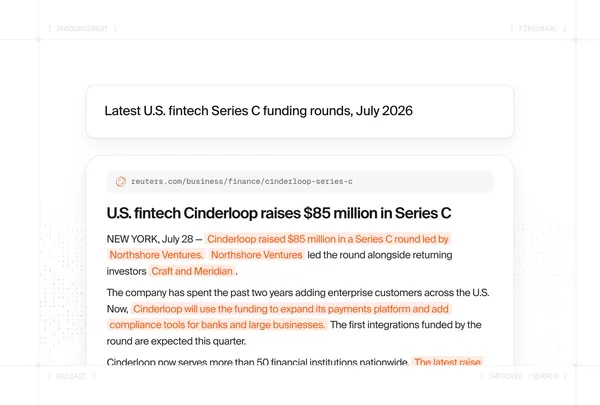
A Firecrawl szerint 94,7 százalékos pontosságot ér el új keresője
A Firecrawl új relevanciamodellt épített a /search végpontjába, amely a teljes weboldalak helyett a kérdésre leginkább válaszoló részleteket adja vissza. A vállalat…
Világrekordot ért el az NVIDIA GB300 NVL72 MoE-modellek tanításában
Az NVIDIA szerint a GB300 NVL72 rackméretű rendszer világrekordot állított fel a DeepSeek-V3 671B kevert szakértői modell előtanításában. A 256 GPU-val végzett mérés…
Cégek és üzletA Google bemutatta a Gemini 3.5 Flash Cyber kiberbiztonsági modellt
A Google DeepMind bemutatta a Gemini 3.5 Flash Cyber modellt, amelyet szoftveres sérülékenységek gyors felderítésére, ellenőrzésére és javítására hangoltak. A modellt…
Az Apple módszere olcsóbbá teheti a gépi tanulási modellek törlését
Az Apple kutatói olyan módszert mutattak be, amely a csekély hatású tanítási adatpontok azonosításával akár körülbelül 50 százalékkal csökkentheti a gépi tanulási…
Külső felülvizsgálat bírálja a Gemini 2.5 Pro biztonsági esetét
Jelentős hiányosságokat talált a SaferAI a Google DeepMind Gemini 2.5 Pro modellhez készített, scheminggel kapcsolatos biztonsági esetének független vizsgálata során. A…
Hilbert: így épít formális matematikai bizonyításokat az Apple rendszere
Az Apple bemutatta a Hilbert nevű ügynöki keretrendszert, amely informális matematikai érvelést kapcsol össze a Lean 4 formális bizonyítás-ellenőrzésével. A rendszer a…