benchmark
A TrendAI 97 százalékkal vezeti a CyberGym biztonsági tesztjét
A TrendAI agentikus sérülékenység-javító motorja, az AESIR kódnevű rendszer 97 százalékos eredménnyel az első helyen végzett a CyberGym AI-biztonsági benchmarkján. A…
A Speechmatics szerint 20 másodperc alatt átír egyórányi hangot a Melia
A Speechmatics Melia beszédfelismerő modellje a cég szerint egyórányi hangfelvételt kevesebb mint 20 másodperc alatt ír át. Az Artificial Analysis független rangsorán…
Biztonság és etikaAz AI Now Institute szerint célzottabb biztonsági tesztek kellenek
Az általános mesterségesintelligencia-benchmarkok helyett a mindennapi felhasználási esetekhez igazított értékeléseket sürget Sarah Myers West, az AI Now Institute…
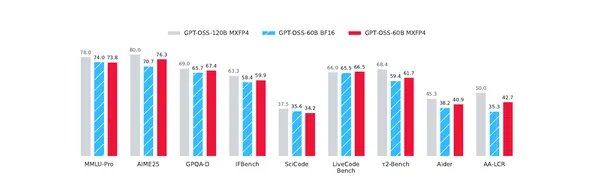
4 bites modell előzné meg a teljes pontosságú eredetit a Hugging Face-poszt szerint
Elton Williams 2026. augusztus 25-én a Hugging Face-en írt a Quantization-Aware Healing nevű megközelítésről. A bejegyzés szerint egy tömörített, 4 bites modell több…
Miért buknak el a frontier AI-ügynökök a valódi mérnöki munkán?
A Terminal-Bench 3.0 legjobb modellje, Claude Opus 5 is csak 43,5 százalékos eredményt ér el az új teszten. A Snorkel AI két feladaton keresztül mutatja be, miért nehéz…
Az NVIDIA teljes gyártásba vitte a Groq 3 LPX rendszert
Az NVIDIA 2026. augusztus 24-én jelentette be, hogy teljes gyártásban van a Vera Rubin rack-szintű rendszerhez kapcsolódó NVIDIA Groq 3 LPX. A vállalat a Hot Chips…
Az NVIDIA szerint a Vera Rubin NVL72 akár 30-szoros előnyt hoz agentikus AI-ban
Az NVIDIA 2026. augusztus 24-én közzétett fejlesztői blogbejegyzése szerint a Vera Rubin NVL72 előzetes mérésekben akár 30-szor nagyobb AI-gyári áteresztőképességet…
NVIDIA Groq 3 LPX: 3431 token/másodperc 100K kontextus mellett
Az NVIDIA 2026. augusztus 24-én ismertette a Groq 3 LPX inference gyorsítót, amelyet a Vera Rubin platform interaktív AI-kiszolgálásához szán. A cég szerint az…
Az Apple kutatói adaptív gondolkodási módszert mutattak be LLM-ekhez
Az Apple kutatói olyan módszert ismertettek, amely előre megbecsüli, mennyi köztes gondolkodásra van szüksége egy nagy nyelvi modellnek egy adott kérdésnél. A Sonata…
A Liquid AI Pipette-t adott ki az eszközön futó AI-modellek mérésére
A Liquid AI és az Artificial Analysis nyílt forráskódú benchmarkrendszert indított az eszközökön futó AI-modellek vizsgálatára. A Pipette a sebességet, késleltetést…
A vLLM az AMD GPU-kon vizsgálta a spekulatív dekódolást
A vLLM az AMD Instinct MI300X és MI355X GPU-kon vizsgálta a spekulatív dekódolást, amely egyetlen célmodell-futtatásban több előre jelzett tokent is ellenőrizhet. A…
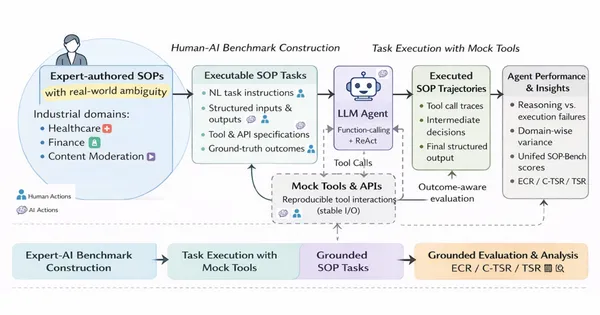
Az Amazon új tesztje valódi üzleti eljárásokon vizsgálja az AI-ügynököket
Az Amazon Science bemutatta az SOP-Bench nevű nyílt benchmarkot, amely AI-ügynököket valódi, szakértők által összeállított üzleti eljárások végrehajtásán keresztül…
Az NVIDIA AVO 100 százalékot ért el az ARC-AGI-3 nyilvános tesztjén
Az NVIDIA Developer 2026. augusztus 21-én közölte, hogy az Agentic Variation Operators, röviden AVO kutatási projekt 100.00 RHAE pontszámot ért el az ARC-AGI-3 nyilvános…
Új benchmark méri, valóban tanulnak-e az AI-rendszerek a tapasztalatból
A Continual Learning Bench azt méri, hogy az LLM-alapú rendszerek valóban javulnak-e a egymást követő feladatok során szerzett tapasztalatoktól. A Berkeley kutatója…
Hugging Face-blogposzt a beszédfelismerési benchmarkok méréséről
A Hugging Face 2026. augusztus 21-én közölt blogposztot „Measuring benchmark optimization in speech recognition” címmel. A bejegyzés az automatikus beszédfelismeréshez…
A GLM-5.3 ötödannyiba kerül, mint a Claude Fable 5
A GLM-5.3 és a Claude Fable 5 első próbálkozásra gyakorlatilag döntetlenre végzett a DeepSWE szoftvermérnöki tesztjén, a GLM-5.3 azonban 5,4-szer olcsóbbnak bizonyult.…
A GLM-5.3 olcsóbban hoz több megoldást, ha lehet újrapróbálkozni
A GPT-5.6 Sol pontosabb első próbálkozásra a DeepSWE programozási feladatain, a GLM-5.3 viszont olcsóbb, több próbálkozással megelőzi, és a két modell együtt adja a…
Az OpenRouter vizuális tesztekkel hasonlítja össze a képgeneráló modelleket
Az OpenRouter vizuális kép-benchmarkot indított, amellyel a platformon elérhető képgeneráló modellek képességei hasonlíthatók össze. A tesztek 39 modellt vizsgáltak 2026…
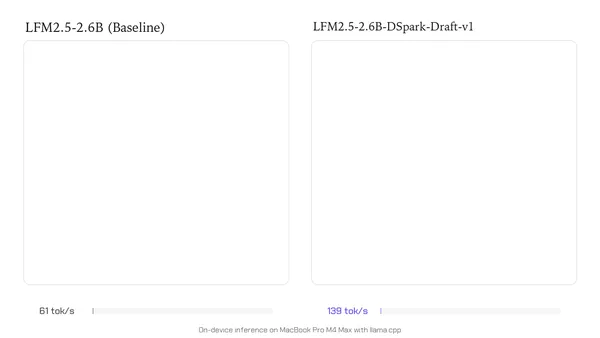
Akár 3,2-szer gyorsabb inferenciát ígér az LFM2.5-DSpark
A Hugging Face-en 2026. augusztus 20-án jelent meg a LiquidAI bejegyzése az LFM2.5-DSpark modellről. A cím szerint a megoldás akár 3,2-szer gyorsabb inferenciát kínál.
Agentic Search: új keresési réteget mutatott be a Mistral AI vállalatoknak
A Mistral AI 2026. augusztus 20-án bemutatta az Agentic Search nevű keresési rétegét, amelyet vállalati AI-rendszerekhez szán. A cég szerint a megoldás összetett…
A Murf szerint a jó AI-szinkron alapja a kontextusos fordítás
A Murf szerint az AI-szinkronizálás minőségét elsősorban a fordítás határozza meg, nem önmagában a hang természetessége. A vállalat saját benchmarkjében a Murf, a HeyGen…
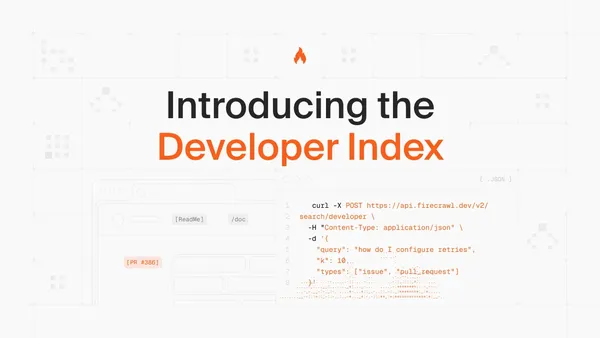
A Firecrawl külön keresőt indított kódoló ügynököknek
A Firecrawl Developer Index a kódoló ügynökök számára fontos README-ket, dokumentációkat, hibajegyeket és pull requesteket kereshetővé tevő új index. A vállalat ezzel…
A letölthető modellek korában az adat és a visszacsatolás dönt
A Bridgewater AIA Labs kísérlete szerint egy nyílt súlyú modell szakértői adatokkal betanítva felülmúlta a vizsgált élvonalbeli modelleket. Az Anaconda szerint a…
USC-kutatók háromlépcsős védelmet fejlesztenek az AI-ügynökökhöz
A USC mérnökei olyan eszközöket fejlesztenek, amelyek az AI-ügynökök indulás előtti ellenőrzését, futás közbeni felügyeletét és a hibák utólagos feltárását segítik. A…