benchmark
Az UK AISI szerint a Kimi K3 elmarad a vezető kibermodellektől
Az UK Artificial Intelligence Security Institute és az amerikai CAISI előzetes vizsgálata szerint a Moonshot AI Kimi K3 modellje jelentősen gyengébben teljesít a…
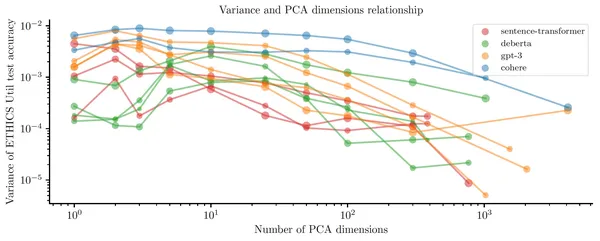
Az LLM-ek rejtett módon felismerik, mi lehet jobb az embereknek
A nyelvi modellek beágyazásaiban olyan rejtett információ jelenhet meg, amely alapján megkülönböztethetők a kellemesebb és kellemetlenebb helyzetek. A FAR.AI kutatói…
Biztonság és etikaA FAR.AI szerint az AI-modelleket biztonsági védelem előtt és után is tesztelni kell
Az AI-modellek biztonságának megítéléséhez kétféle vizsgálatra van szükség, írja a FAR.AI: a veszélyes képességeket a védelmi intézkedések előtt, a korlátok működését…
Biztonság és etikaFAR.AI: 2025-ben gyorsult az AI fejlődése, de a kockázatok is nőttek
A FAR.AI értékelése szerint 2025-ben látványosan fejlődtek a gondolkodó modellek és a kódoló ügynökök, miközben az AI-val támogatott bűncselekmények, a megtévesztés és…
Az AI21 olcsóbb modellekkel ért el 80,8 százalékos SWE-Bench-eredményt
Az AI21 Labs többmodellű kódolási architektúrával 80,8 százalékos felbontási arányt ért el a SWE-Bench Pro teszten, miközben egy feladat átlagos költsége 5,99 dollár…
A Hugging Face bemutatta a Real World VoiceEQ beszéd-AI-mérést
A Hugging Face bemutatta a Real World VoiceEQ benchmarkot, amelynek célja a hangalapú mesterséges intelligencia emberi minőségének mérése. A kezdeményezéshez rendezhető…
Automatikus átvilágítási kaput épített az LLM-ek pénzügyi használatához a Langfuse
A Langfuse automatizált PASS/FAIL ellenőrzési folyamatot épített LLM-ek és AI-ügynökök pénzügyi alkalmazásaihoz. A rendszer tesztadatokon méri többek között a számszerű…
Ötezer Kaggle-versenyző mutatta meg, hogyan javítható az AI érvelése
Több mint 5000 résztvevő és 4000 csapat dolgozott az NVIDIA Nemotron Model Reasoning Challenge feladatain, ahol azonos modell és korlátozások mellett kellett javítani az…
Az NVIDIA szerint a wattok döntik el az AI-infrastruktúra versenyét
Az AI-infrastruktúrában a teljesítmény wattonként határozza meg, hogy egy adott energiafelhasználás mellett mennyi token állítható elő, és mekkora bevétel érhető el. Az…
Egy év alatt 44-ről 350 főre nőtt a Cognition csapata
A Cognition egy év alatt 44-ről 350 főre bővítette csapatát, miközben a Windsurf egyesülése után több új terméket és saját modellt mutatott be. A vállalat szerint…
A drágább Fable 5-tel mégis olcsóbb lett a Devin használata
A Fable 5 tokenenként kétszer annyiba kerül, mint az Opus 4.8, a Cognition tesztje szerint mégis olcsóbban futott vele a Devin. A különbséget az ügynökök munkaszervezése…
A Vapi szerint már szinte emberinek hallatszanak a legjobb hangmodellek
A Vapi Humanness Index eredményei szerint a vezető hangmodellek hallgatói megítélés alapján már csak néhány ponttal maradnak el a valódi emberi hangfelvételtől. Az xAI…
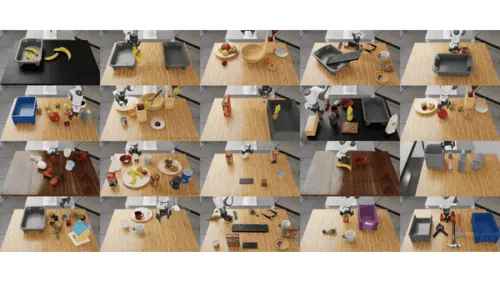
Az NVIDIA RoboLabja részletesebben méri a robotok képességeit
Az NVIDIA RoboLab néven új szimulációs platformot mutatott be az általános célú robotpolitikák értékelésére. A rendszer a sikerességi arány mellett a feladatvégrehajtás…
Verset ajánl és William Sieghart hangján szólal meg az Ode Poetry
Az Ode Poetry beszélgetés alapján ajánl verset a felhasználónak, majd egy valódi ember felolvasásában játssza le. A Microsoft AI és William Sieghart közös projektje a…
Az Apple új benchmarkkal méri a hosszú videók összefoglalását
Az Apple bemutatta az LVSum nevű benchmarkot, amely azt vizsgálja, mennyire pontosan foglalják össze a multimodális nagy nyelvi modellek a hosszú videókat. A rendszer…
Az Apple új tesztje a videós történetek megértését vizsgálja
Az Apple kutatói bemutatták a NarrativeTrack nevű benchmarkot, amely a multimodális nagy nyelvi modellek videós történetmegértését méri. A rendszer azt vizsgálja, hogy a…
Új módszer mutatja meg, valóban érti-e a videót egy AI-modell
Az Apple kutatói olyan értékelési módszert mutattak be, amely különválasztja a videós nyelvi modellek tudásalapú, képi és valódi időbeli következtetési képességeit. A…
Az NVIDIA Nemotron 3 Ultra olcsóbban ér el élmezőnybeli eredményt
A LangChain a Deep Agents ügynökrendszerét az NVIDIA Nemotron 3 Ultra modelljéhez hangolta. Az NVIDIA szerint az így kialakított rendszer a nyílt modellek között a…
KutatásAz OpenAI szerint a SWE-Bench Pro feladatainak 30 százaléka hibás
Az OpenAI visszavonta korábbi ajánlását a SWE-Bench Pro használatára, miután egy audit szerint a benchmark feladatainak mintegy 30 százaléka hibás. A vállalat szerint ez…
A Cognition bemutatta az SWE-1.7 kódoló modellt
A Cognition elindította az SWE-1.7-et, amelyet a vállalat eddigi legképességesebb modelljeként mutat be. A modell hosszabb, aszinkron szoftverfejlesztési feladatokra…
A Cognition szerint megbízható lehet a nyílt forrású modellből fejlesztett AI
A Cognition olyan tesztcsomagot fejlesztett, amely propaganda, cenzúra és kódolási helyzetek alapján vizsgálja az AI-modellek megbízhatóságát. A vállalat szerint a nyílt…
Az Amii hat kutatási eredményt mutat be az ICML 2026-on
Az Amii kutatói és hallgatói több, a mesterséges intelligencia alapkutatásához kapcsolódó eredményt mutatnak be az ICML 2026 konferencián Szöulban. A bemutatott munkák a…
Három rétegben méri az Owkin a tudományos AI-ügynök megbízhatóságát
Az Owkin háromszintű értékelési rendszert dolgozott ki K Pro nevű, biomedicinális kutatást segítő AI-ügynökéhez. A módszer az egyes eszközhívásokat, a teljes…