benchmark
A Murf szerint a jó AI-szinkron alapja a kontextusos fordítás
A Murf szerint az AI-szinkronizálás minőségét elsősorban a fordítás határozza meg, nem önmagában a hang természetessége. A vállalat saját benchmarkjében a Murf, a HeyGen…
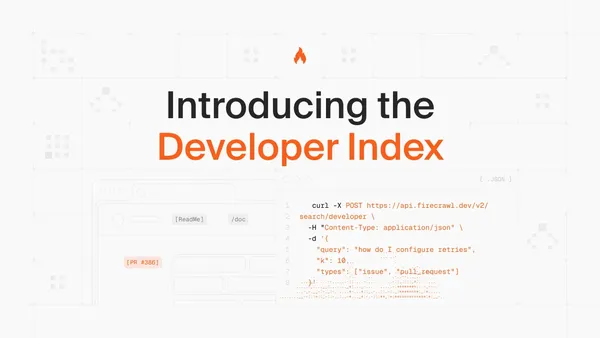
A Firecrawl külön keresőt indított kódoló ügynököknek
A Firecrawl Developer Index a kódoló ügynökök számára fontos README-ket, dokumentációkat, hibajegyeket és pull requesteket kereshetővé tevő új index. A vállalat ezzel…
A letölthető modellek korában az adat és a visszacsatolás dönt
A Bridgewater AIA Labs kísérlete szerint egy nyílt súlyú modell szakértői adatokkal betanítva felülmúlta a vizsgált élvonalbeli modelleket. Az Anaconda szerint a…
USC-kutatók háromlépcsős védelmet fejlesztenek az AI-ügynökökhöz
A USC mérnökei olyan eszközöket fejlesztenek, amelyek az AI-ügynökök indulás előtti ellenőrzését, futás közbeni felügyeletét és a hibák utólagos feltárását segítik. A…
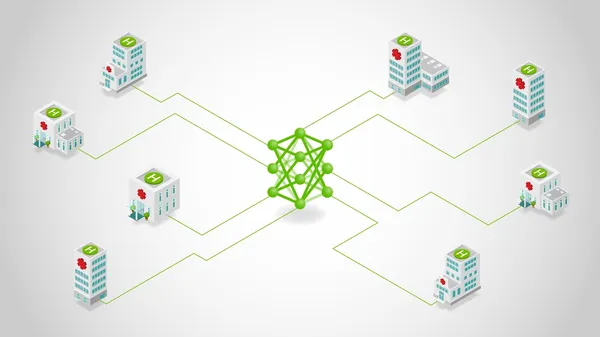
Az NVIDIA FLARE a többhelyszínes multimodális AI-tanítást célozza
Az NVIDIA Developer 2026. augusztus 19-én ismertette, hogyan használható az NVIDIA FLARE federált multimodális AI-munkafolyamatokhoz. A cikk fő témája, hogy a különböző…
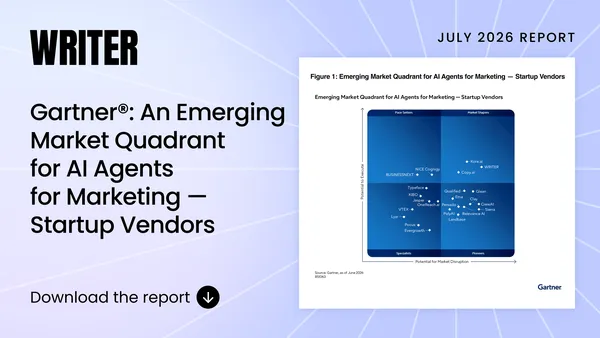
A Gartner Market Shapernek nevezte a Writer AI-platformját
A Writer Market Shaper minősítést kapott a Gartner első, marketinges AI-ügynökökkel foglalkozó Emerging Market Quadrant jelentésében. A vállalat ezt a platform egy év…
A LangChain automatikus értékelőt indított az AI-ügynökök hibáinak felismerésére
A LangChain bemutatta a LangSmith Tuned Evaluators szolgáltatást, amely automatikusan minőségi visszajelzést kapcsol a gyártásban futó AI-ügynökök nyomkövetéseihez. Az…
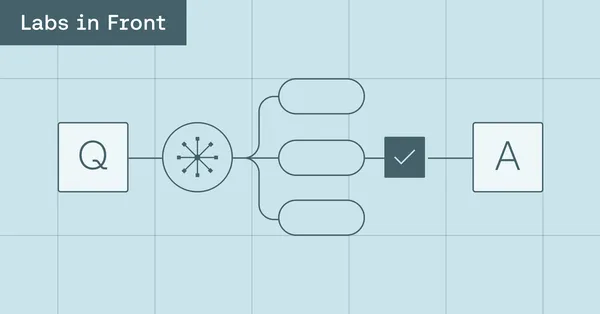
Az AI21 szerint az ügynöki kereséshez fontosabb a hitelesítő, mint a nagy modell
Az ügynöki keresőrendszerekben gyakran már szerepel a helyes válasz a modell által előállított jelöltek között, a rendszer mégsem azt választja ki. Az AI21 Labs szerint…
Apple-kutatás: kilenc LLM-bíró csak két független szavazatot ér
A több nagy nyelvi modellből álló értékelőpanelek megbízhatóságát kérdőjelezi meg egy Apple-kutatás: a vizsgált kilenc LLM-bíró információtartalma nagyjából két…
A Liquid AI új 4 bites modelljei visszanyerik a pontosság nagy részét
A Liquid AI négy új, 4 bites LFM2.5 checkpointot adott ki, amelyeket kvantálástudatos desztillációval, QAD-del készített. A vállalat szerint a modellek megtartják a Q4_0…
Biztonság és etikaÚj jailbreak-adatbázist mutatott be a FAR.AI a veszélyes kérésekhez
A FAR.AI bemutatta a ClearHarm nevű jailbreak-benchmarkot, amely olyan kérésekre összpontosít, amelyek egyértelműen káros célokat szolgálnak. A kutatók szerint az…
Cégek és üzletAz EU az FAR.AI vezette konzorciumra bízza a CBRN-kockázatok vizsgálatát
Az FAR.AI vezeti azt a konzorciumot, amely az Európai Bizottság AI Office-a számára vizsgálja, hogyan használhatók fel fejlett mesterségesintelligencia-rendszerek vegyi…
A Cline nyílttá teszi az open-weight ügynökök értékelési adatait
A Cline nyílttá teszi az open-weight modellekkel működő kódoló ügynökök értékeléséhez használt módszereit, eredményeit és nyomvonalait. A vállalat szerint a cél annak…
FejlesztőknekKépgenerálással és ügynöki feladatokkal bővült az MLPerf Client
Az MLCommons kiadta az MLPerf Client v2.0-t, amely a személyi számítógépeken futó mesterséges intelligencia teljesítményét méri. Az új verzió a nyelvi modellek mellett…
Az Apple 14 nyelvre készített matematikai adathalmazt az RLVR-kutatáshoz
Az Apple kutatói bemutatták a mAceReason-Math adathalmazt, amely nehéz matematikai feladatok kiváló minőségű fordításait gyűjti össze 14 nyelven. A nyelvenként több mint…
A DeepSeek V4 Pro olcsón előzi meg a GPT-5.6 Solt több próbálkozással
A GPT-5.6 Sol pontosabb és gyorsabb egyetlen próbálkozásnál, a DeepSeek V4 Pro 0813 viszont 35-ször olcsóbb, és több újrapróbálkozással magasabb eredményt ér el a…
A szintetikus robotikai adatok terjednek, de bizalmi réteg nélkül kockázatosak
A szintetikus adatok fontos megoldást kínálnak a robotikai látás, nyelv és cselekvés rendszereinek adatproblémájára, de a mennyiségük gyorsabban nő, mint a…
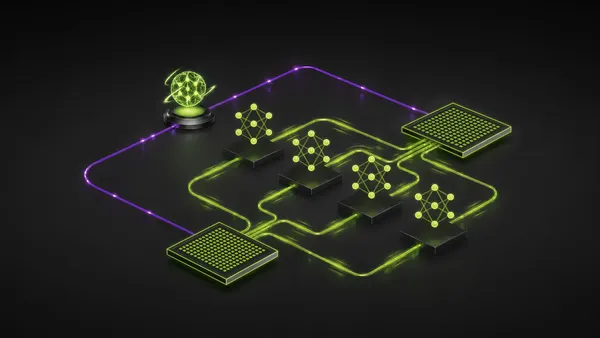
Az NVIDIA QAD-vel készítette el a Nemotron 3.5 Lightning NVFP4 modellt
Az NVIDIA Developer augusztus 17-én ismertette, hogyan készült a Nemotron 3.5 Lightning NVFP4 checkpoint az NVIDIA Model Optimizer és kvantálást figyelembe vevő…
A DeepSeek V4 Pro olcsóbban és több próbálkozással felülmúlta a Fable 5-öt
A DeepSeek V4 Pro 0813 első próbálkozásra gyengébb volt a Claude Fable 5-nél a DeepSWE programozási tesztjein, több próbálkozással azonban megelőzte, miközben egy…
Az Auggie CLI 53 százalékkal olcsóbb lett a Claude Code-nál
Az Augment szerint az Auggie CLI új, v2-es változata azonos feladatmegoldási arány mellett 53 százalékkal olcsóbban teljesít egy feladatot, mint a Claude Code. A…
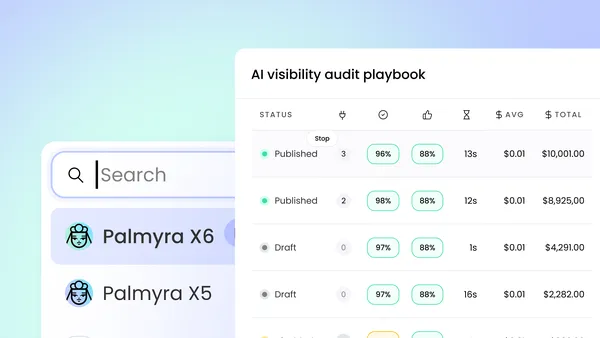
A Writer olcsóbb és gyorsabb vállalati AI-ügynököket ígér a Palmyra X6-tal
A Writer kiadta új zászlóshajó-modelljét, a Palmyra X6-ot, és jelentősen frissítette WRITER Agent rendszerét. A vállalat szerint a fejlesztések olcsóbbá, gyorsabbá és…
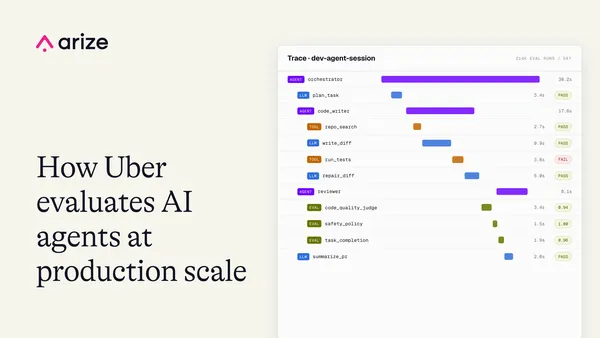
Az Uber a valódi felhasználói hibákból tanítja jobb működésre AI-ügynökeit
Az Uber az éles használatból származó nyomokkal és hibákkal fejleszti tovább AI-ügynökeinek értékelését. A vállalat szerint az eszközöknél fontosabbak az alapértelmezett…
Hugging Face: vita indult a nyílt modellek licenceléséről
A Hugging Face 2026. augusztus 14-én tette közzé „State of Open Models: Summer 2026 Observations” című blogbejegyzését. A nyílt modellekről szóló összefoglalóhoz…
ModellekA Voyage AI új modellje a kódolási ügynökök kereséseit gyorsítaná
A Voyage AI bemutatta a voyage-code-4 kódbeágyazási modellt, amelyet kifejezetten programozási ügynökök kódkeresési feladataira fejlesztett. A vállalat szerint az új…