nyelvi modellek
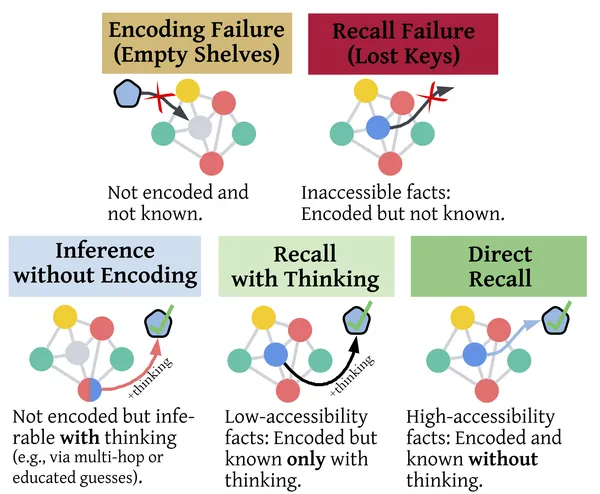
A Google szerint a csúcsmodellek sok tényt tárolnak, de nem mindig hívják elő
A Google Research 2026. augusztus 12-én bemutatott kutatása szerint a fejlett nagy nyelvi modellek ténybeli hibáinak jelentős része nem abból ered, hogy a modellek nem…
Az Liquid AI új, gyors látónyelvi modellje telefonon is fut
Az Liquid AI kiadta az LFM2.5-VL-3B nevű, 3,1 milliárd paraméteres látónyelvi modellt, amelyet gyors, helyi futtatásra terveztek. A vállalat szerint a modell több, nála…
Megjelent a Qwen3.8-2.4T-A95B, már a Modalon is elérhető
A Qwen3.8-2.4T-A95B nyílt súlyú modellként jelent meg, és már a Modal felhőplatformján is elérhető. A szolgáltató szerint az új modell több területen is javult a Qwen…
A vLLM már az első napon támogatja a 2,4 billió paraméteres Qwen3.8-at
A vLLM már a megjelenés napjától futtatja a Qwen3.8-2.4T-A95B modellt, amely a Qwen család első nyílt súlyú, Qwen-Max kategóriájú modellje. A 2,4 billió paraméteres…
Frissített súlyokkal fut a DeepSeek V4 Pro a Vercel AI Gateway-en
A DeepSeek V4 Pro frissített súlyai alapértelmezetté váltak a Vercel AI Gateway-en. A meglévő kérések automatikusan ezeket használják, így a fejlesztőknek nem kell…
A Vercel AI Gatewayre is megérkezett a Grok 4.6
A SpaceXAI Grok 4.6 modellje elérhetővé vált a Vercel AI Gateway szolgáltatásán keresztül. A rendszer szöveges és képi bemeneteket fogad, 500 ezer tokenes…
Az IBM szerint az ALTK-Evolve kevesebb tokennel éri utol az ACE-t
Az IBM Research 2026. augusztus 11-én a Hugging Face-en közölt bejegyzésben hasonlította össze ALTK-Evolve nevű megközelítését az ACE, vagyis Agentic Context Engineering…
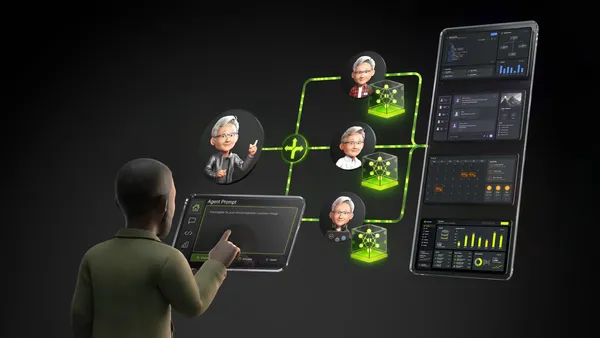
Az NVIDIA bemutatta a Nemotron 3.5 Lightning nyílt AI-modellt
Az NVIDIA 2026. augusztus 11-én bemutatta a Nemotron 3.5 Lightning modellt, amelyet hosszú ideig futó AI-ügynökök nagy volumenű, alacsony késleltetésű végrehajtási…
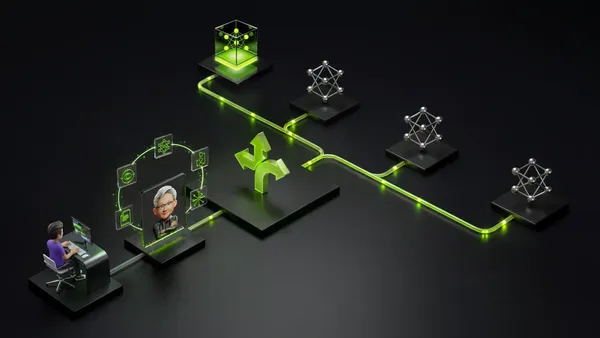
NVIDIA NeMo Switchyard: modellválasztó réteg AI-ügynökökhöz
Az NVIDIA Developer 2026. augusztus 11-én ismertette a NeMo Switchyard működését, amely AI-ügynökök feladatait irányítja különböző specializált és frontier modellek…
A CodeRabbit olcsóbban és pontosabban tanította be az NVIDIA modelljét
A CodeRabbit az NVIDIA Nemotron 3.5 Lightning modellt tanította be a kódellenőrzések útválasztására. A modell az utótréning után pontosabban követte a vállalat…
Helyben futó, nyílt NVIDIA-modell érkezett az Ollamába
Az Ollamában elérhetővé vált a NVIDIA Nemotron 3.5 Lightning, egy nyílt modell, amelyet hosszabb ideig futó ügynöki feladatokra terveztek. A modell teljes egészében a…
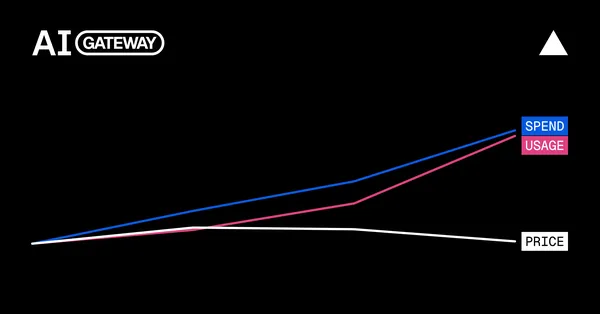
A DeepSeek megelőzte a Google-t az AI-tokenek forgalmában
A DeepSeek júliusban a második legnagyobb laboratóriummá vált a Vercel AI Gateway forgalmában, és több mint kétszer akkora tokenmennyiséget kezelt, mint a Google. Közben…
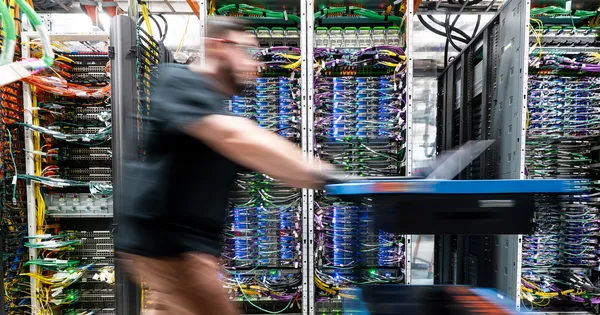
Az AWS Trainiumra optimalizált nyelvi modelleket keres az Amazon
Az Amazon olyan versenyt indít, amelyben a résztvevők nyelvi modelleket tanítanak be az AWS saját Trainium2 chipjein. A cél annak feltárása, milyen modellarchitektúrák…
TokenGridgel váltaná fel a statikus AI-limitálást a DataRobot
A DataRobot bemutatta a TokenGridet, egy tokenérzékeny kapacitásütemezőt, amely az LLM-kéréseket nem pusztán a kérések számát, hanem azok várható erőforrás-igénye…
Termékek és eszközökA Model ML több pénzügyi munkát bíz GPT-5.6 Solra
Az OpenAI 2026. augusztus 10-én közölte, hogy a Model ML pénzügyi munkafolyamataiban bővíti a GPT-5.6 Sol használatát. A cég saját mérései szerint a modell több esetben…
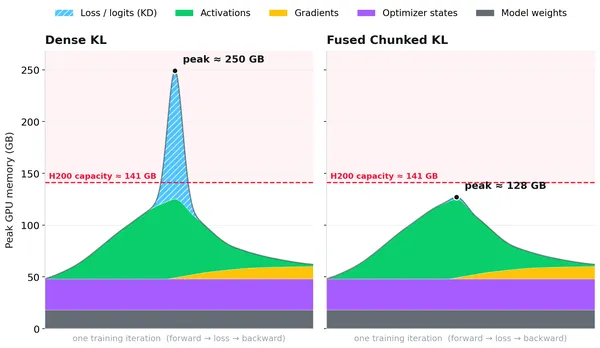
Olcsóbbá tennék a nagy léptékű tudásdesztillációt
A Hugging Face blogján 2026. augusztus 10-én jelent meg a „Making Knowledge Distillation Cheap Enough to Run at Scale” című bejegyzés. A cikk témája, hogyan lehet a…
Termékek és eszközökAz OpenAI bővíti a Daybreak programot, jön a GPT-5.6-Cyber
Az OpenAI 2026. augusztus 10-én bejelentette a Daybreak program bővítését, valamint a GPT-5.6-Cyber nevű, kiberbiztonságra specializált modelljét. A cég szerint a cél…
Meta Muse Glimmer: 30B nyílt modell helyi agentikus AI-feladatokra
A Hugging Face augusztus 10-én közölt bejegyzése szerint a Meta visszatért a nyílt forrású ökoszisztémába a Muse Glimmer modellel. Az NVIDIA fejlesztői blogja alapján a…
A Meta Muse Glimmer modellje hosszú, önálló ügynöki munkára készült
A Fireworks AI elérhetővé tette a Meta Muse Glimmer modelljét, amelyet folyamatosan működő AI-ügynökökhöz, hosszú eszközhasználathoz és többfordulós feladatokhoz…
Day 0 támogatást kapott a Nemotron 3.5 Lightning a vLLM-ben
A vLLM bejelentette az NVIDIA Nemotron 3.5 Lightning modell Day 0 támogatását. A 30 milliárd paraméteres, hibrid MoE modell helyi asszisztensekhez és nagy volumenű…
A Novita AI ingyenesen kínálja a 256K kontextusú Ling-3.0 Tiny modellt
A Novita AI elérhetővé tette a Ling-3.0 Tiny modellt szerver nélküli API-végpontként. A 7,9 milliárd paraméteres, ritkított MoE-modell 256K tokenes kontextusablakot…
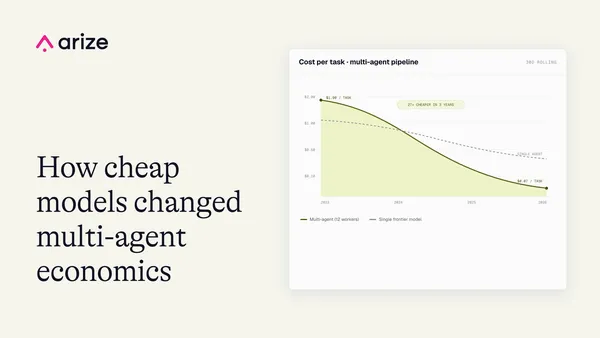
Olcsóbb modellek változtatják meg az AI-ügynökök felépítését
Az olcsóbb modellek fejlődése újra előtérbe hozta az orchestrator-executor, vagyis irányító és végrehajtó ügynökökre épülő architektúrát. Az Arize AI szerint egy erős…
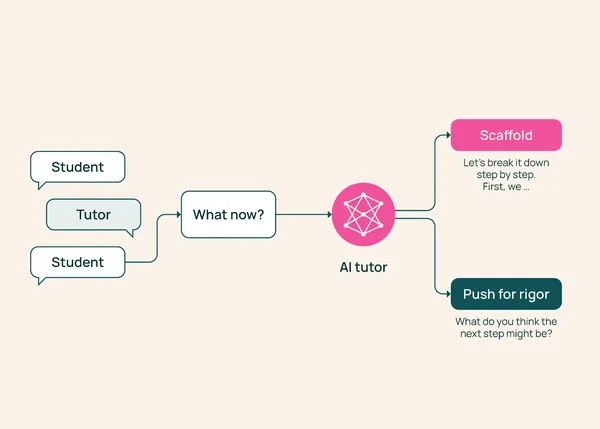
Az Ai2 új tesztje azt méri, mikor segít túl sokat egy AI-tutor
Az Ai2 2026. augusztus 7-én bemutatta a TutorMoments előzetesét, egy értékelési keretrendszert AI-tutorok vizsgálatára. A rendszer azt méri, hogy a nagy nyelvi modellek…
Apple-kutatás: gyorsabb LLM-futtatás külön draft modell nélkül
A Speculative Streaming nevű Apple-kutatás azt célozza, hogy a nagy nyelvi modellek válaszgenerálása gyorsabb legyen külön segédmodell fenntartása nélkül. A módszer az…