kutatási eredmény
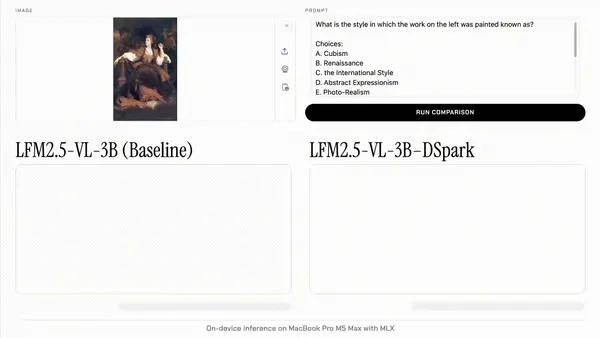
A Liquid AI látásmodellje akár 3,13-szor gyorsabban dekódol
A Liquid AI bemutatta az LFM2.5-VL-DSpark kísérleti modellt, amely az LFM2.5-VL-3B látásnyelvi modell dekódolását gyorsítja. A vállalat mérései szerint a dekódolási…
A Google TPU-kon reprodukálta az Olmo 3 7B tanítását
A Google mérnökei a MaxText JAX/XLA-alapú keretrendszerrel, Google Cloud TPU-kon reprodukálták az Allen Institute for AI Olmo 3 7B modelljének első két tanítási…
A GPT-5.6 Sol vezeti a régi rendszerekre szabott tesztet
A GPT-5.6 Sol érte el a legjobb eredményt a Factory Legacy-Bench nevű tesztjén, amely a COBOL, a Java 7, a BASIC, a C89, a Fortran és az Assembly kezelését vizsgálja. A…
Az Elastic módszere külön ellenőrzi az LLM-ek által összevont cikkeket
Az Elastic olyan módszert dolgozott ki tudásbázis-cikkek összevonására, amely különválasztja a szöveggenerálást és az ellenőrzést. A rendszer a forrásanyagokat önállóan…
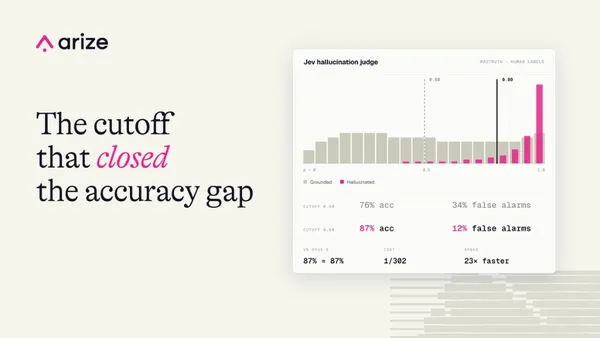
Az Arize szerint a Jev 300-szor olcsóbban érte el Claude Opus 5 pontosságát
A Jev a Claude Opus 5-tel azonos, 87 százalékos pontosságot ért el az Arize hallucination detection tesztjén, miközben a vállalat szerint körülbelül 300-szor olcsóbb és…
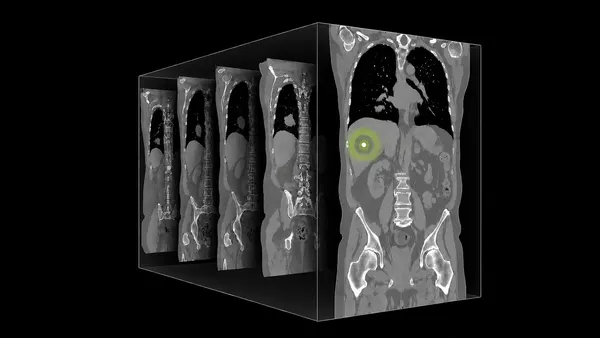
Az NVIDIA nyílt 3D CT-modellt mutatott be radiológiai következtetéshez
Az NVIDIA bemutatta az NV-Reason-CT-t, egy 3D CT-vizsgálatok elemzésére fejlesztett látásnyelvi modellt. A rendszer strukturált leleteket és radiológusi gondolkodást…
Gyorsabb vektorkeresést és új AI-adatkezelési fejlesztéseket jelentett be a LanceDB
A LanceDB több, mesterséges intelligenciához kapcsolódó adatkezelési fejlesztést ismertetett: gyorsabb vektorkeresést, ByteDance-alapú infrastruktúrát és robotikai…
A LanceDB összevetette a Lance, a Delta Lake és az Iceberg teljesítményét
A LanceDB S3-on végzett, 10 000 commitot vizsgáló benchmarkja szerint a Lance rövidebb commitkésleltetést és kisebb aktív metaadat-lábnyomot ért el, mint a Delta Lake és…
Egyetlen LanceDB-táblára épülhet az LLM-ek teljes előkészítése
A LanceDB olyan LLM-előkészítési folyamatot mutatott be, amelyben a nyers szöveg, a minősítési eredmények és a tokenek ugyanabban a táblában maradnak. A rendszer a sorok…
LanceDB új világmodell-platformot és multimodális SQL-eszközt mutatott be
A LanceDB három új fejlesztést emelt ki legutóbbi hírlevelében: egy Lance-alapú, reprodukálható világmodell-kutatási platformot, a DuckDB multimodális SQL-integrációját…
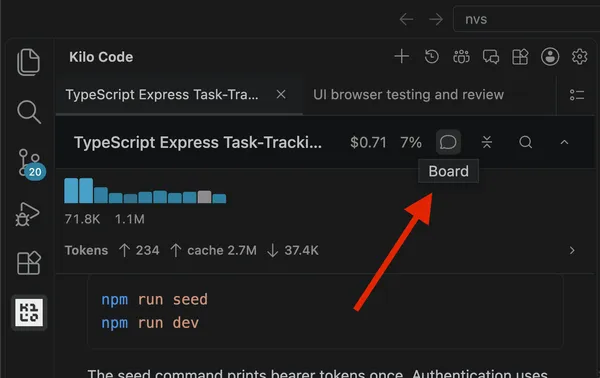
A Kilo Swarm 39 százalékkal csökkentette a költséget egy célfeladaton
A Kilo Swarm egy összetett, több ügynökkel végzett fejlesztési feladaton 39,2 százalékkal csökkentette a költséget, miközben a teszt mind a tíz futása sikeres lett. A…
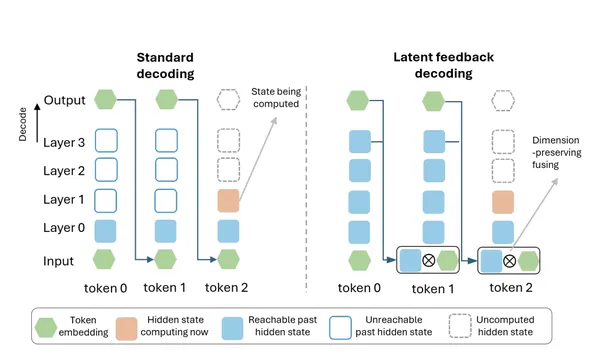
A látens gondolkodás veszélyeztetheti az AI-k legfontosabb felügyeleti eszközét
A Redwood Research szerint a látens állapotokban végzett, hosszabb gondolkodás jelentősen gyengítheti a láncolt gondolatmenet, vagyis a chain of thought felügyeleti…
A Microsoft AI-eszközzel vizsgálták a szennyvíz vírusait
A Microsoft Discovery AI-ügynökei felgyorsíthatják a szennyvízből származó metagenomikai adatok feltáró elemzését, miközben a tudományos értelmezés a szakértő kezében…
Egy manipulált beszélgetés támadóvá változtathatja az AI-ügynököt
A Darktrace kutatói szerint a helyben tárolt és ellenőrizetlen beszélgetési előzmények manipulálásával AI-ügynökök támadó műveletekre vehetők rá. A vizsgálatban Claude…
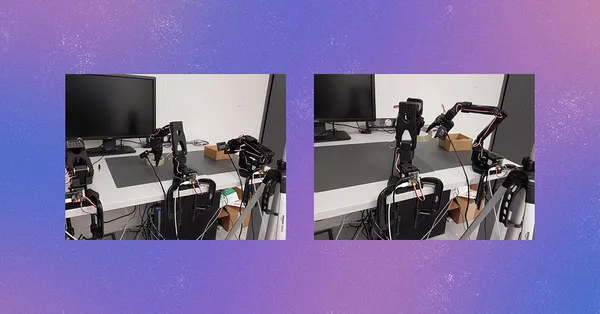
A Microsoft szerint nem kell minden robotba nagy GPU
A robotok fedélzeti GPU-ira épülő megközelítés teljesítményben, üzemidőben és skálázhatóságban is korlát lehet a Microsoft Research új kutatása szerint. A cég azt…
Miért vezetnek továbbra is a zárt AI-modellek a nyílt modelleknél?
A vállalatok továbbra is elsősorban zárt, szabadalmaztatott AI-modellekre költenek, pedig a nyílt modellek sok esetben hasonló teljesítményt kínálnak jóval alacsonyabb…
A Snorkel szerint az Opus 5.5 vezet a kódolási tesztben
Az Opus 5.5 érte el a legmagasabb összesített sikerarányt a Snorkel AI szakértők által összeállított kódolási feladatsorán. A modell 68 százalékos eredményt ért el…
A vállalatok többsége már autonóm AI-ra készül a hálózatokban
A vállalatok gyorsan térnek át a tanácsadó szerepű mesterséges intelligenciáról az önállóan cselekvő AgenticOps rendszerekre. A Cisco és az Omdia felmérése szerint a…
A Qodo szerint az AI-kód ellenőrzése lett a fejlesztés szűk keresztmetszete
A szervezetek 89 százaléka már tapasztalt mesterséges intelligenciához kapcsolódó éles üzemzavart, miközben a fejlesztési folyamatok ellenőrzése nem tartott lépést az AI…
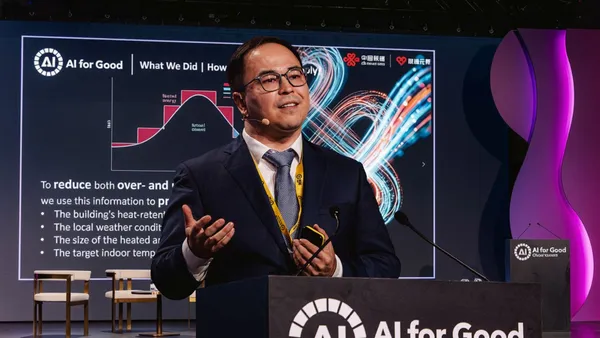
AI csökkentette az energiafelhasználást egy kínai távhőrendszerben
AI-alapú előrejelzéssel, vezérléssel és hibadetektálással csökkentette energiafelhasználását egy kínai távhőszolgáltató. A changshai rendszerben az áramfogyasztás több…
A beszédfelismerők még elbuknak, ha más is beszél a háttérben
A modern beszédfelismerők jól kezelik a forgalom, a légkondicionáló és a billentyűzet zaját, de egy másik beszélő hangja továbbra is komoly hibákat okoz. A Krisp 265…
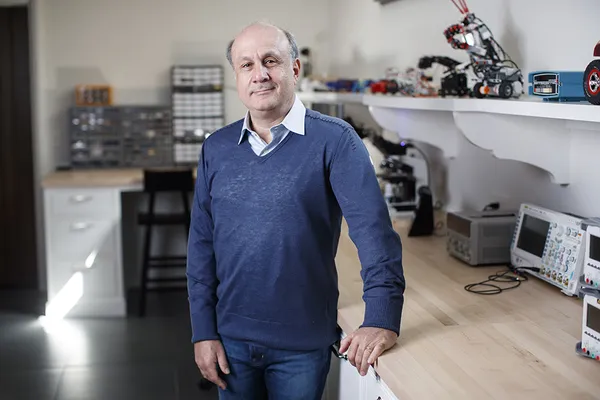
David Siegel lesz az MIT következő innovációs ösztöndíjasa
David Siegel számítástechnikus, vállalkozó és filantróp lesz az MIT következő Innovation Fellow ösztöndíjasa. A 2026 és 2027 közötti tanévben azt vizsgálja az MIT…
Az ügynöki AI előtt álló legnagyobb akadály a vállalati adat lehet
Az ügynöki mesterséges intelligencia egyre inkább döntéseket hozhat és üzleti folyamatokat indíthat el, ám ehhez megbízható, összekapcsolt vállalati adatokra van…
KutatásAz OpenAI új benchmarkkal méri az AI mentális egészségügyi válaszait
Az OpenAI bemutatta a MentalHealthBench nevű, nyílt benchmarkot, amely azt méri, hogyan reagálnak az AI-rendszerek a mentális egészséggel kapcsolatos beszélgetésekben. A…