benchmark
Az Apple kutatása szerint kevésbé számít az ügynökök körítése
Az Apple kutatói szerint a gépi tanulási feladatokra fejlesztett ügynököknél az alapul szolgáló nagy nyelvi modell teljesítménye fontosabb lehet az ügynök köré épített…
Roboflow Labs néven új kutatási részleget indít a Roboflow
Roboflow Labs néven alkalmazott kutatási részleget indít a Roboflow. A divízió olyan modellek és értékelési módszerek fejlesztésére összpontosít, amelyek a mesterséges…
ModellekA Voyage AI bemutatta a rerank-3 és rerank-3-lite modelleket
A Voyage AI bemutatta a rerank-3 és rerank-3-lite modelleket, amelyek a vállalat szerint a rerank-2.5 sorozathoz képest főként hosszú dokumentumok és kódok keresésében…
Az IDC a vezetők közé sorolta az SAP agentikus marketingplatformját
Az SAP vezető minősítést kapott az IDC MarketScape: Worldwide Agentic Marketing for B2C Enterprises 2026 Vendor Assessment értékelésében. A vállalat szerint a Joule…
Az IDC MarketScape vezetőként értékelte az SAP agentikus marketingjét
Vezetőként értékelte az SAP-t az IDC MarketScape a B2C vállalatoknak szánt agentikus marketing 2026-os beszállítói elemzésében. Az SAP szerint Joule ügynökei, az SAP…
Kutatás: az AI-s gyűlöletbeszéd-felismerés maga is keretek közé szorít
A gyűlöletbeszéd mesterséges intelligenciával végzett felismerését alapvetően meghatározza, hogyan írják le magát a nyelvet. A Minderoo Centre for Technology & Democracy…
A gyűlöletbeszéd technikai definíciója meghatározza, mit lát az AI
A gyűlöletbeszéd automatikus felismerését kutató tudományterületek eltérően értelmezik a nyelvet és a károkat. Stefanie Ullmann tanulmánya szerint ezek a kiindulópontok…
Kilenc RIKEN-közreműködésű tanulmányt fogadtak el az EMNLP 2026 fő konferenciájára
Kilenc, a RIKEN Center for Advanced Intelligence Project kutatóinak közreműködésével készült tanulmányt fogadtak el az EMNLP 2026 fő konferenciájára. További hét…
Nyílt ranglista indult a többnyelvű TTS-modellek mérésére
Az Open TTS Leaderboard nyílt értékelési platformként a többnyelvű szövegfelolvasó és hangklónozó modellek összehasonlítását teszi skálázhatóbbá. A Hugging Face blogján…
Az Apple SCLATE rendszere hónapnyi ügynöki munkát órákra sűrít
Az Apple bemutatta a SCLATE nevű végrehajtási réteget, amely a folyamatos tanulásra képes AI-ügynökök képzését és értékelését támogatja. A rendszer egy hónapnyi…
A Cohere új mérőszámmal értékelné pontosabban a vállalati keresőket
A Cohere bemutatta az RCP-nDCG@10 nevű értékelési módszert, amely mesterséges intelligenciával vizsgálja a kereső által visszaadott dokumentumok relevanciáját. A…
A Jev gyorsabban és olcsóbban értékelte a kódoló ügynök lépéseit
A TypeSafe AI Jev modellje gyorsabban és alacsonyabb becsült költséggel értékelte egy kódoló ügynök parancsainak kockázatát, mint a tesztben használt két általános célú…
Az Apple SCLATE rendszere hónapok helyett órák alatt teszteli az ügynököket
Az Apple bemutatta a SCLATE nevű végrehajtási környezetet, amely hosszú, több munkameneten átívelő forgatókönyvekben képezi és értékeli az AI-ügynököket. A rendszer egy…
Új mérőszámot mutatott be a Cohere az enterprise kereséshez
A Cohere bemutatta az RCP-nDCG@10 nevű értékelési módszert, amely mesterséges intelligenciával vizsgálja a keresőrendszerek által visszaadott dokumentumok relevanciáját.…
A Jev gyorsabban és olcsóbban értékelte a kódoló ügynök kockázatait
A TypeSafe AI Jev modellje gyorsabban és alacsonyabb becsült költséggel adott strukturált kockázati értékeléseket, mint a Fiddler AI által vizsgált két általános célú…
Hét tanulság a valódi hangalapú ügynökök építéséről
A bemutatón jól működő hangalapú AI-ügynököt gyorsan össze lehet rakni, éles környezetben azonban a hangposta, a megszakítások, a késleltetés és a bizalom komoly…
Az AssemblyAI szerint félrevezető lehet a beszédfelismerés WER-mérőszáma
A hagyományos szóhibaarány, vagyis a WER egyes esetekben rosszabbnak mutathatja az újabb beszédfelismerő modelleket, állítja az AssemblyAI. A vállalat szerint a probléma…
A LangSmithben is elérhető a Jev, az ügynökök gyors értékelője
A LangSmithben mostantól Jev-alapú értékelő is használható az AI-ügynökök működésének vizsgálatára. A TypeSafe System One modellje strukturált válaszokat ad, és a…
A LangSmithben is elérhető a Jev, az agentek új értékelője
A LangSmithben mostantól Jev is használható az agentek teljesítményének értékelésére. A TypeSafe AI rendszerét a LangChain gyors, olcsó és strukturált visszajelzésekhez…
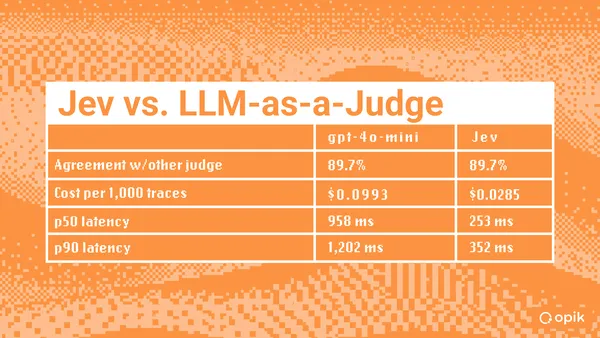
A Jev 3,5-szer olcsóbb és 3,8-szer gyorsabb bírómodellnek bizonyult
A TypeSafe AI Jev modellje 1000 valódi termelési interakción 3,5-szer olcsóbbnak és mediánban 3,8-szer gyorsabbnak bizonyult, mint a Comet által használt gpt-4o-mini…
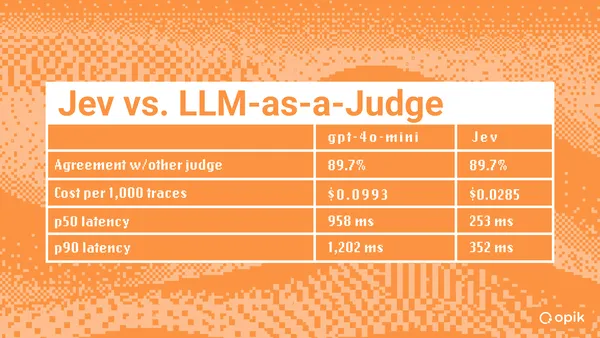
A Jev 3,8-szor gyorsabb és 3,5-szer olcsóbb bírómodellnek bizonyult
A TypeSafe AI Jev modellje 1000 valós termelési fordulaton 3,5-szer olcsóbb és 3,8-szor gyorsabb volt, mint a Comet által használt gpt-4o-mini bírómodell. A két modell…
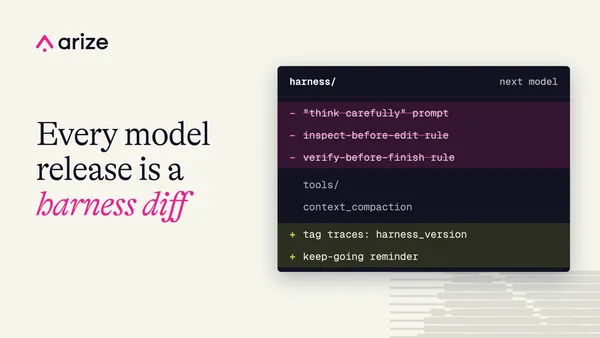
Az agent harnesses nem tűnnek el, de gyorsabban kell fejlődniük
Egy új kutatás szerint az agent harnesses, vagyis az ügynöki rendszereket eszközökkel, szabályokkal és memóriával támogató rétegek bizonyos részei betaníthatók magába a…
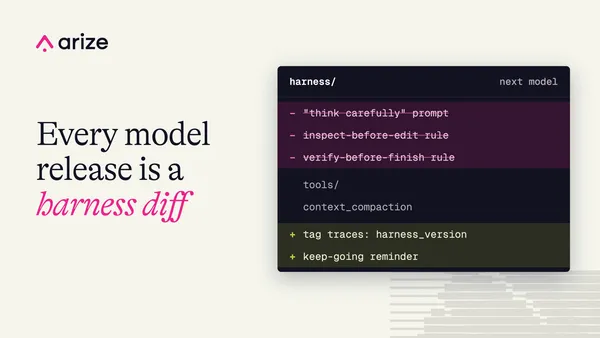
A modellek átvehetik az ügynöki keretek egy részét
Egy új kutatás szerint az ügynöki keretek, vagyis a modelleket eszközökkel és szabályokkal segítő rendszerek egyes részei közvetlenül betaníthatók a modellbe. A keretek…
A Replit Agent maga dönti el, mikor és melyik modellt használja
A Replit Agent új megközelítése nagyobb döntési szabadságot ad a fő modellnek: maga határozza meg, mennyire gondolkodjon, mikor adjon át egy feladatot, és melyik…